
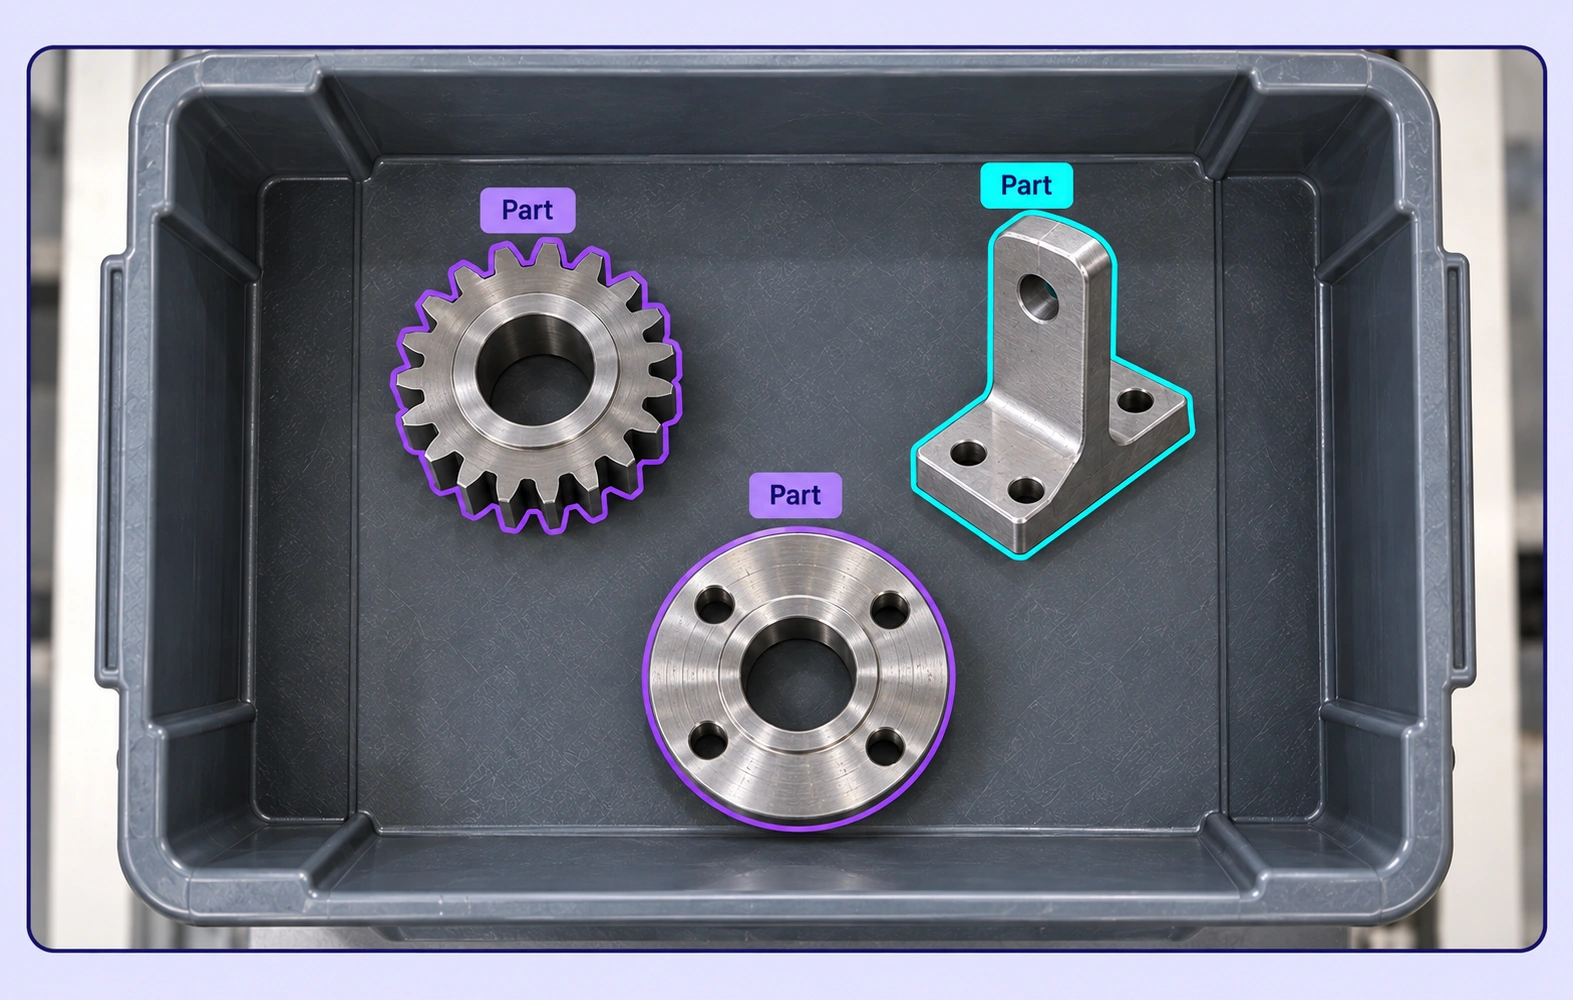
面向增强现实 AI 的训练数据
为空间感知与交互模型准备视觉数据,在图像和演示录像中标注对象、场景区域及关键点。
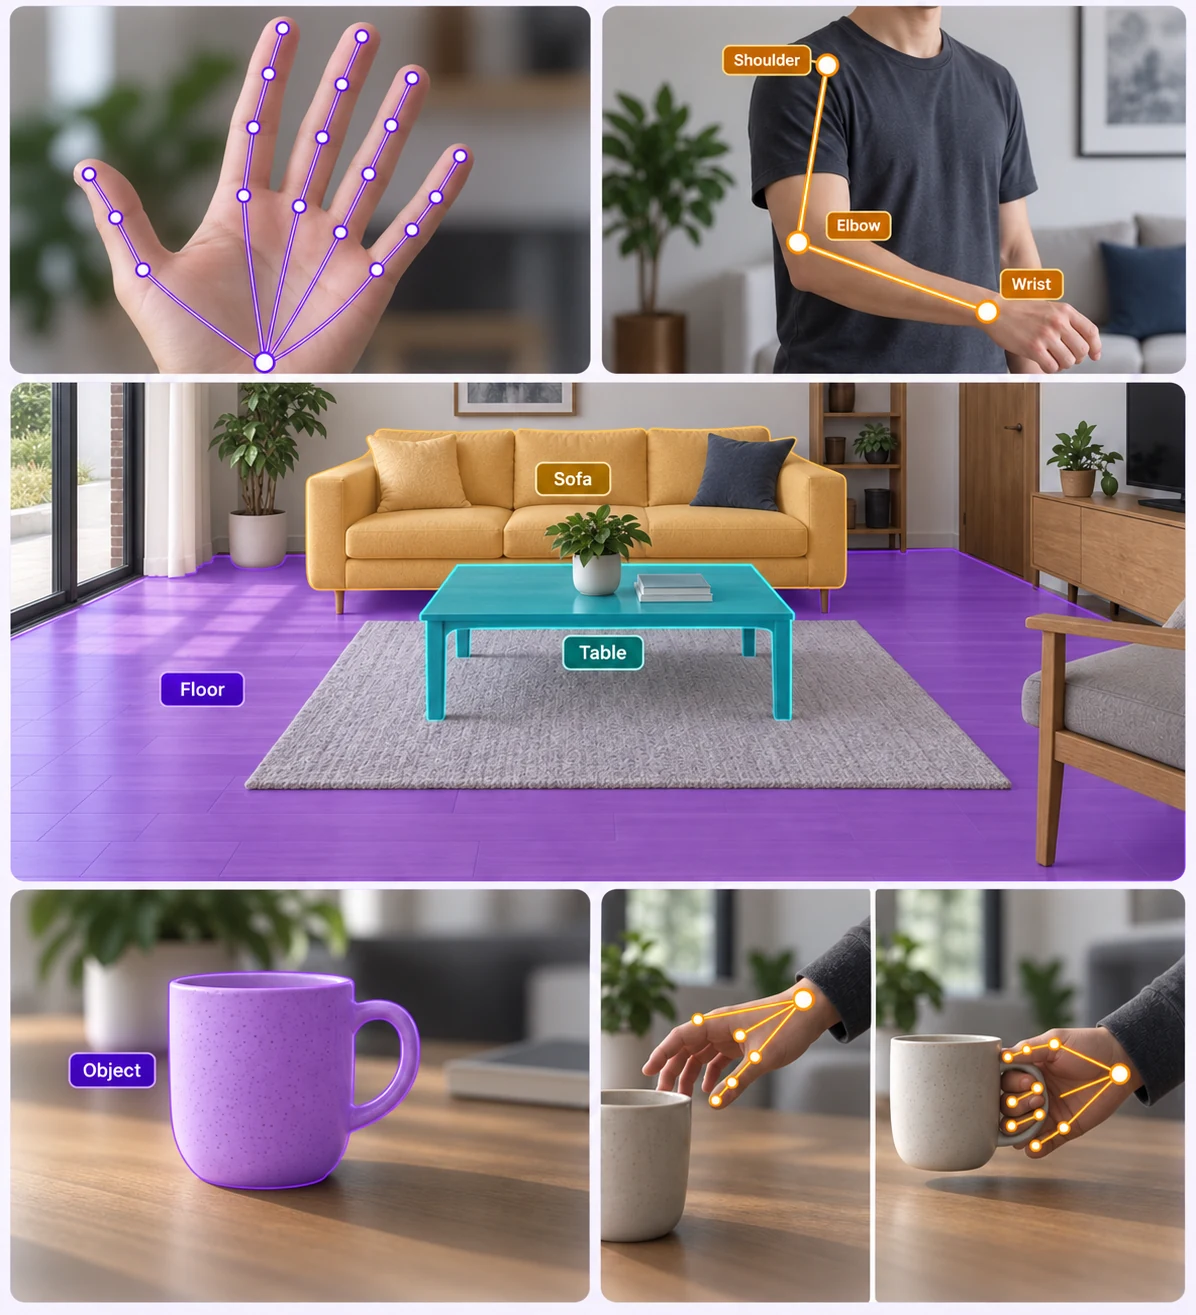
增强现实标注应用场景
将源数据转化为清晰、针对具体任务的训练样本。
对象几何
勾画对象实例,为感知模型提供可见边界标注。
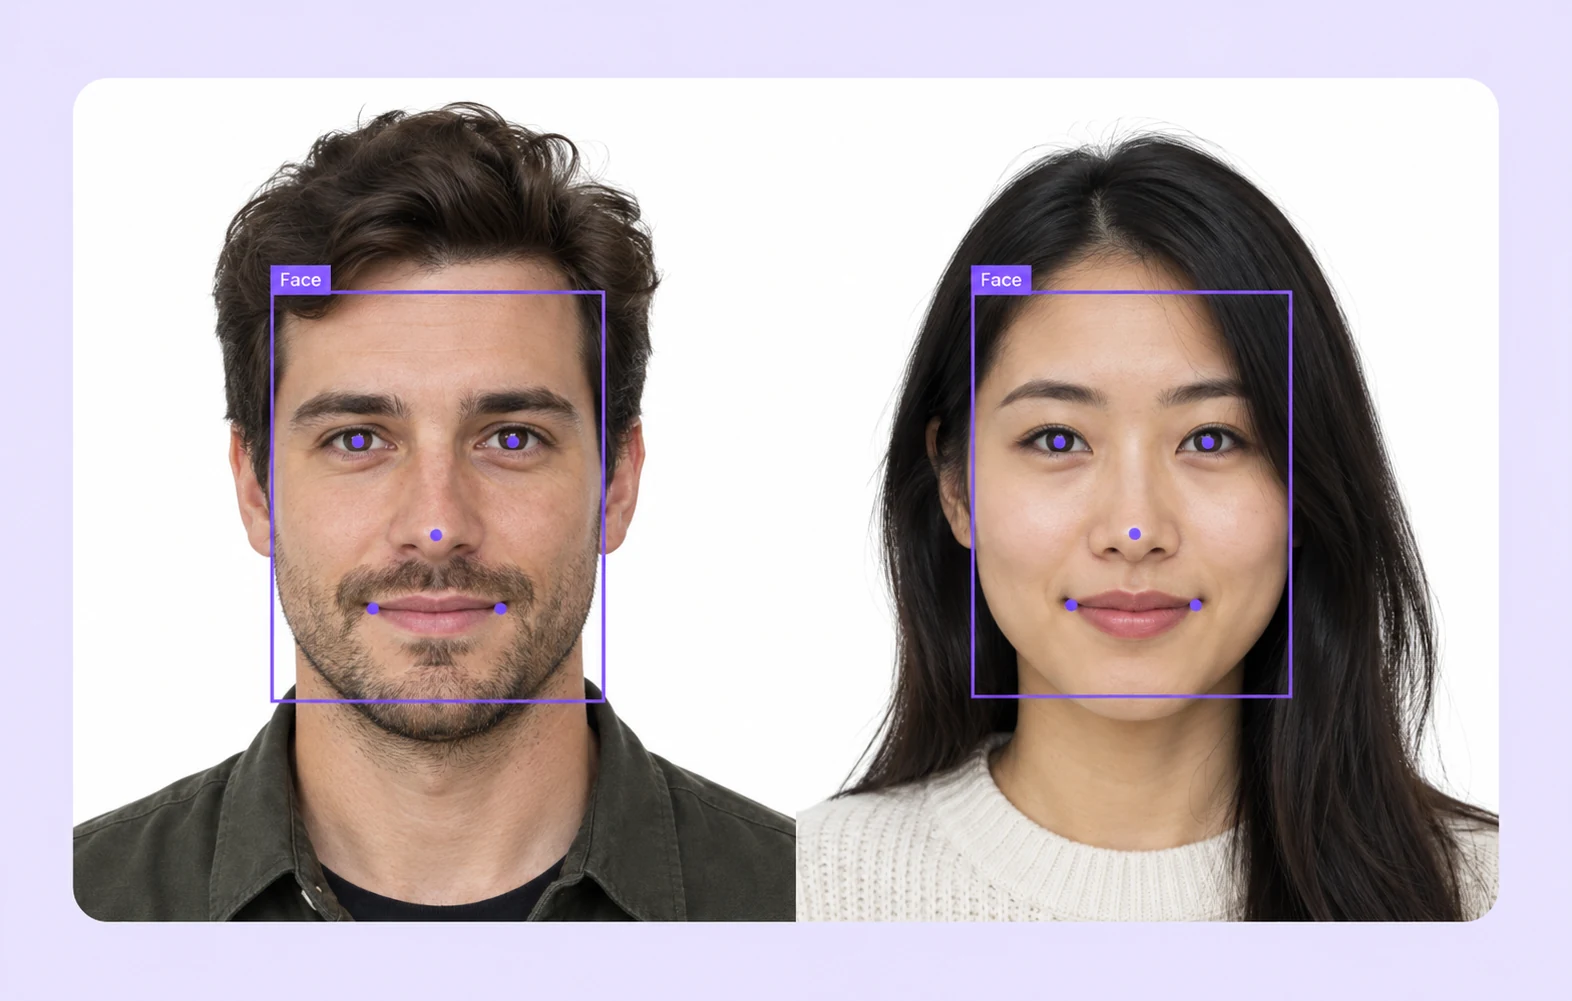
面部关键点
在可见面部特征上放置规定关键点,构建交互数据集。
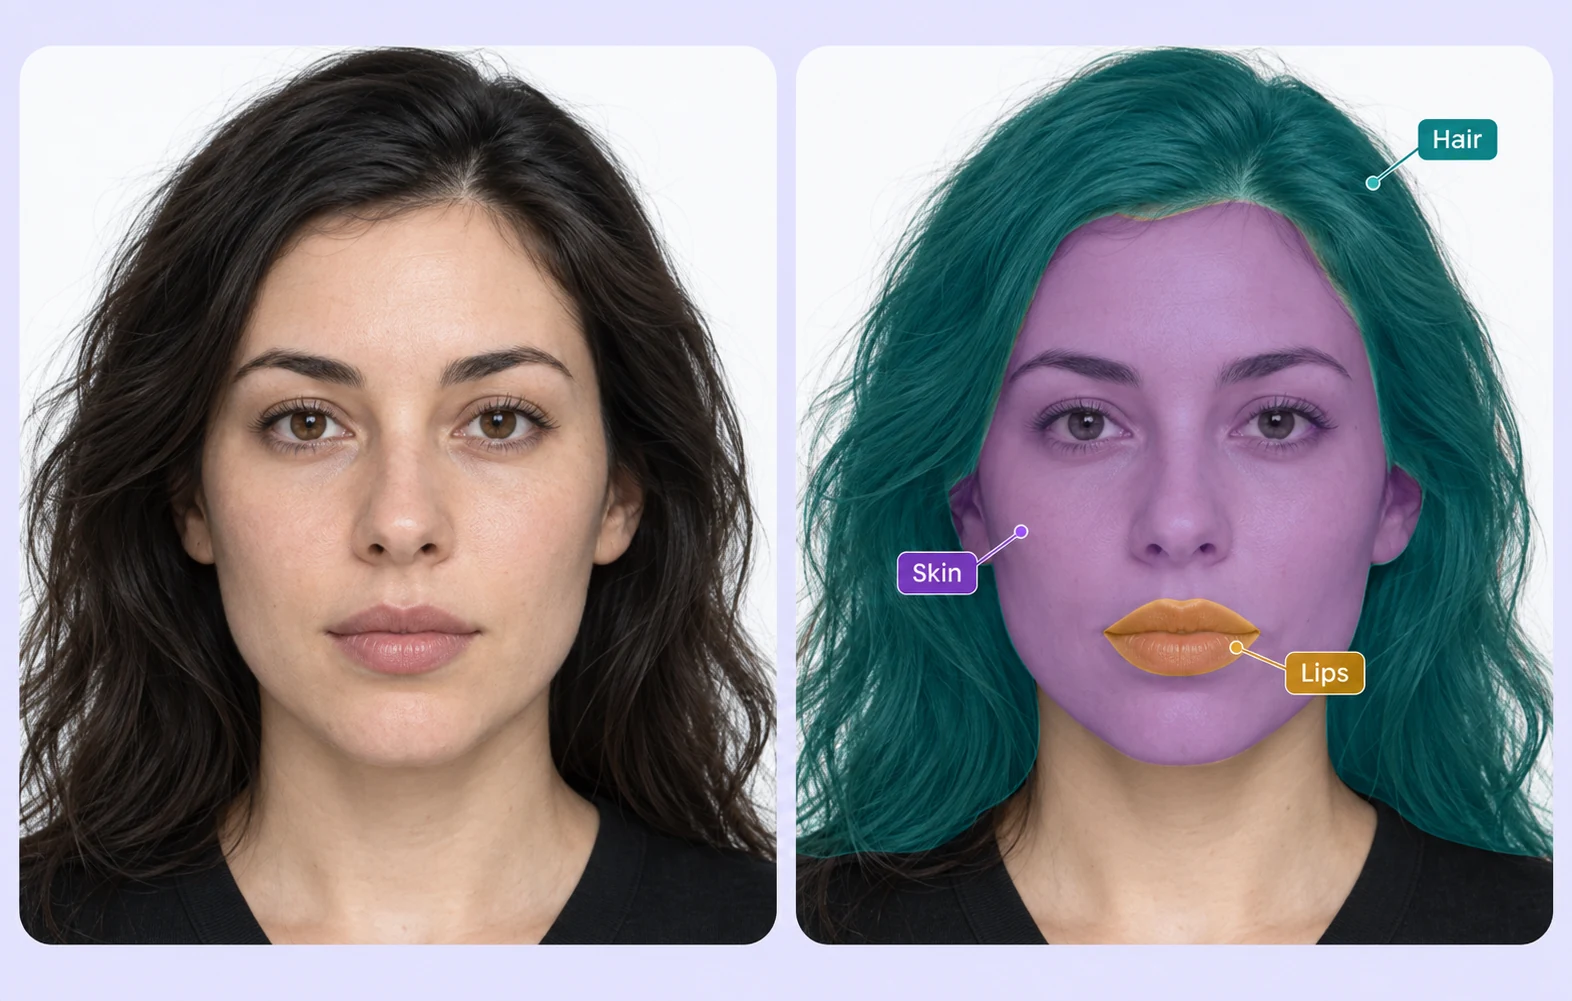
区域掩码
使用一致的掩码类别区分可见面部与头发区域。
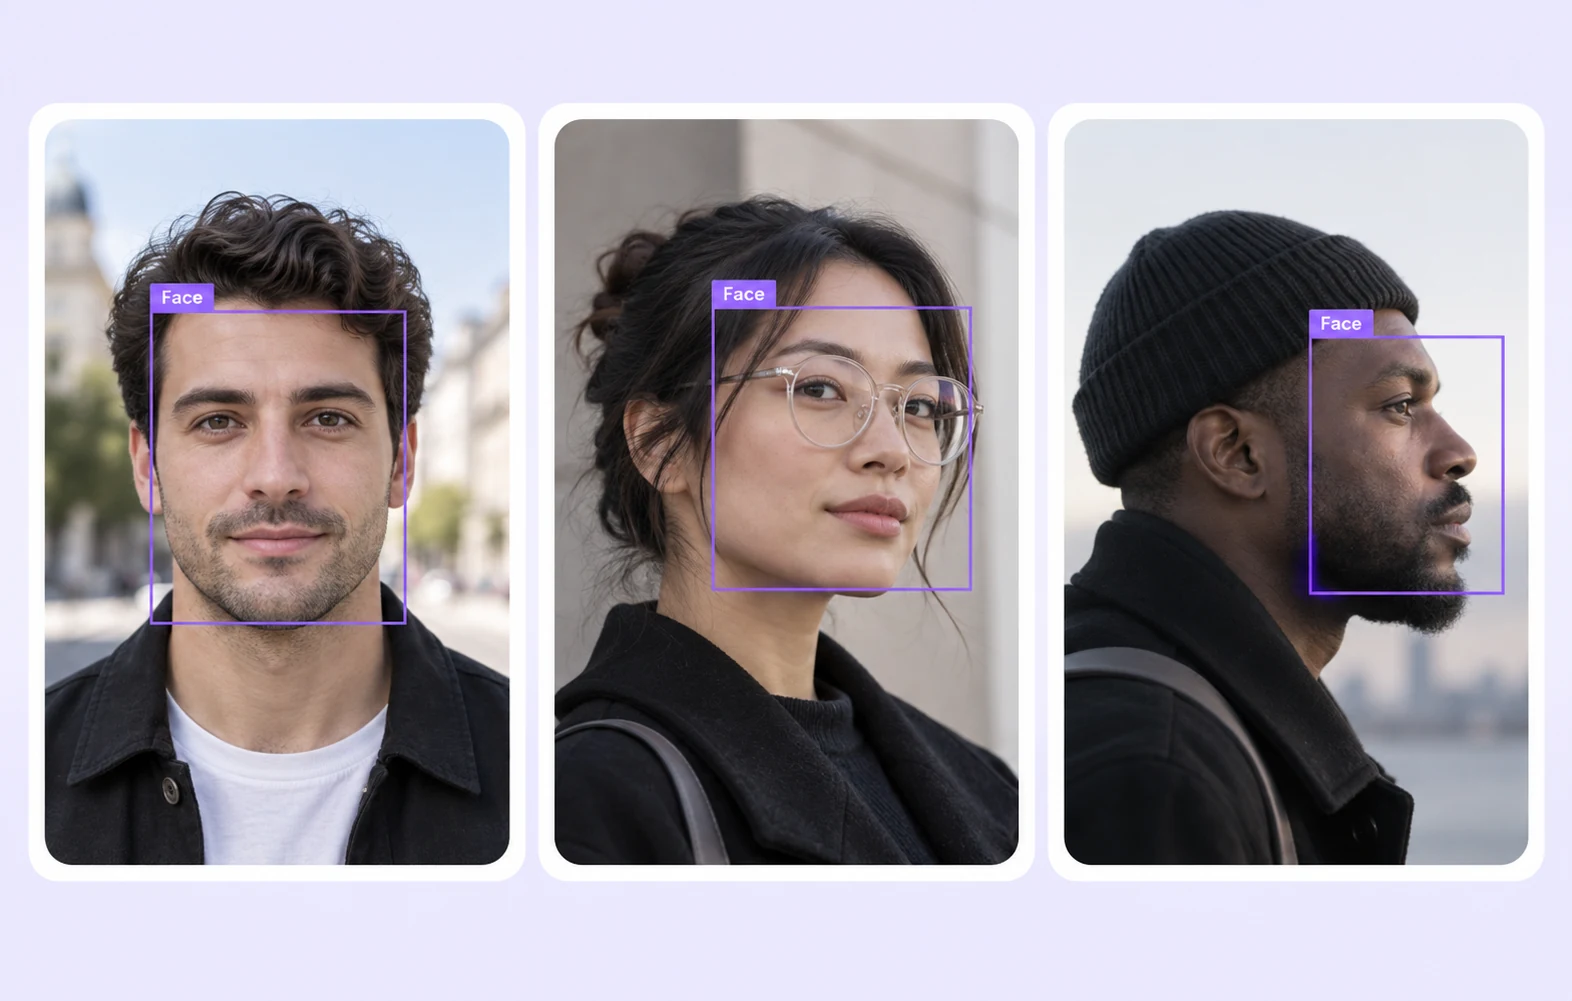
姿态多样性
筛选训练样本时覆盖不同姿态和采集条件。
AI 团队为何选择 Unitlab
将数据整理、统一标签定义、审核和数据集版本连接到同一工作流程。
15×
更快完成增强现实标注
使用可复用本体和审核工作流标注物体与场景几何。
60%
减少数据运营耗时
自动完成增强现实数据集的筛选、管理和版本控制。
5×
降低训练数据成本
可复用本体和规范化质量控制,减少重复的标注与审核工作。
保留源上下文的标签
让标注几何形状与属性匹配模型任务。
实例边界
将可见对象与周围场景分开。定义不同视角下相接对象和缺失边缘的处理规则。
姿态与采集属性
将姿态与采集属性和身份标签分开。审核不同朝向的已选样本,构建一致的视觉交互数据。
增强现实常见问题
什么是增强现实数据标注?
数据标注为源数据添加定义明确的标签,让模型学习具体任务。增强现实场景包括对象几何和面部关键点等。Unitlab 的数据标注平台将这些工作连接起来。
如何保持标注规则一致?
标注前定义类别、必填属性及边界规则,并利用对象几何等示例明确歧义。请参阅类别与标注类型指南。
如何筛选有代表性的训练数据?
通过数据整理检查样本并筛选可用元数据。规划视角、对象尺度、姿态和光照等方面的覆盖,在标注前检查缺失或过度代表的条件。
能否导出数据并连接训练流程?
选择标注任务支持的输出格式,并使用训练代码验证结果。自动化与集成方式请参阅导出格式指南及API、SDK 与 CLI 文档。
需要协助定义标注流程?
联系 Unitlab


