
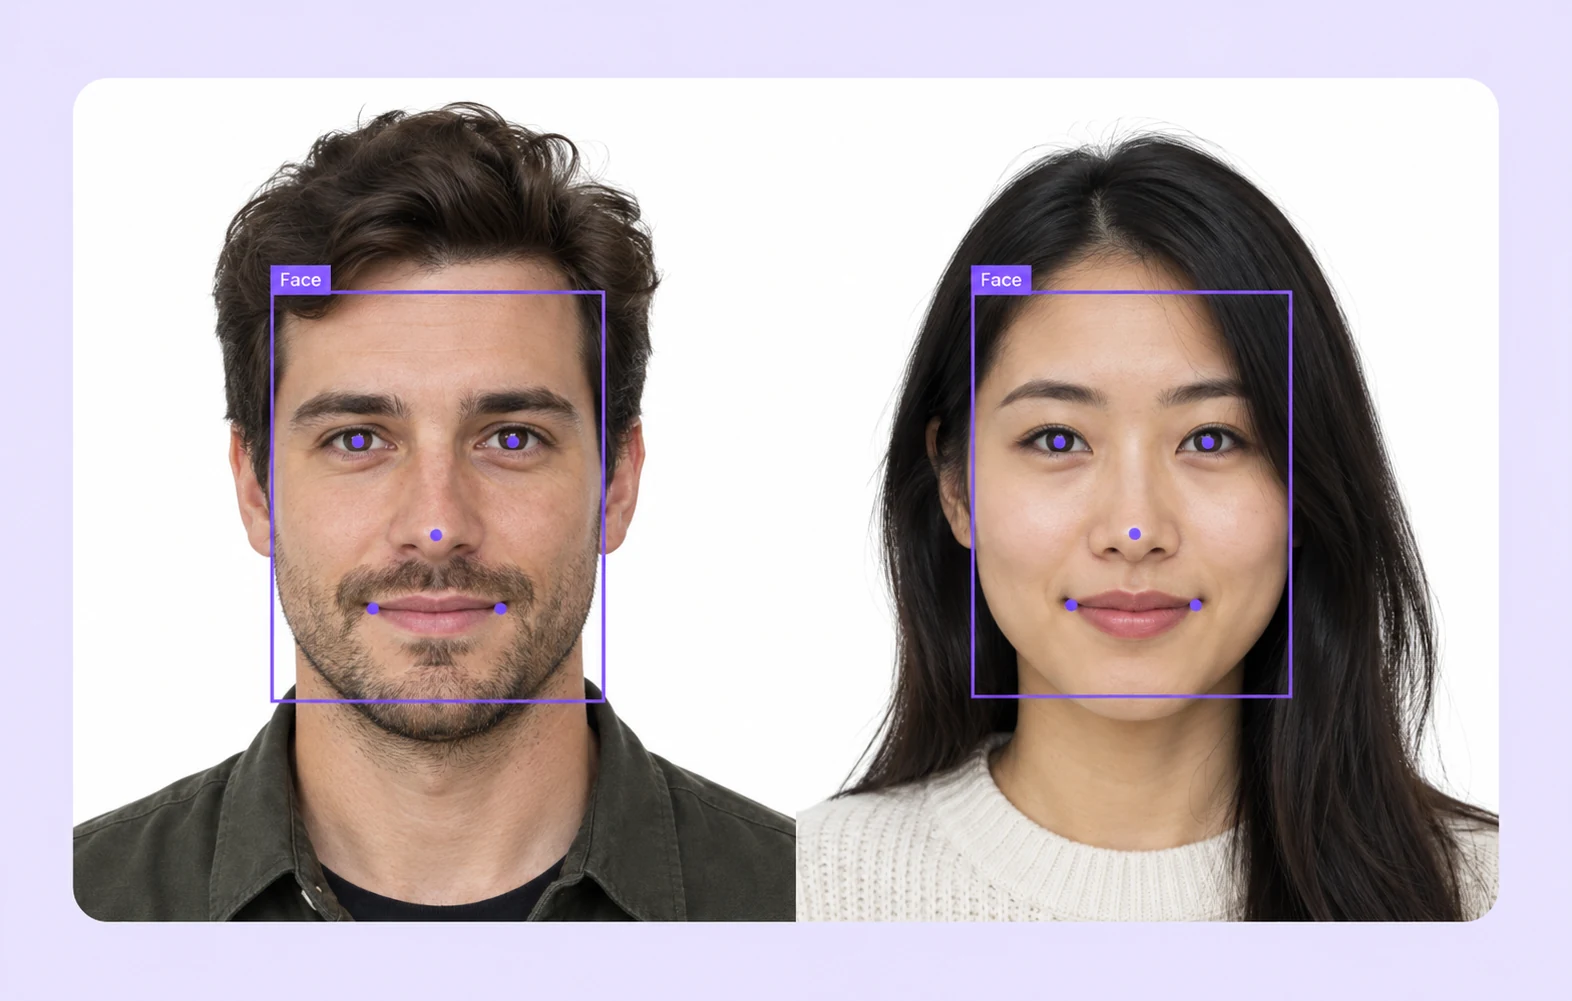
面向人脸识别 AI 的训练数据
通过边界框、关键点和区域掩码准备人脸图像与视频帧,审核不同姿态、遮挡及采集条件下的可见几何结构。
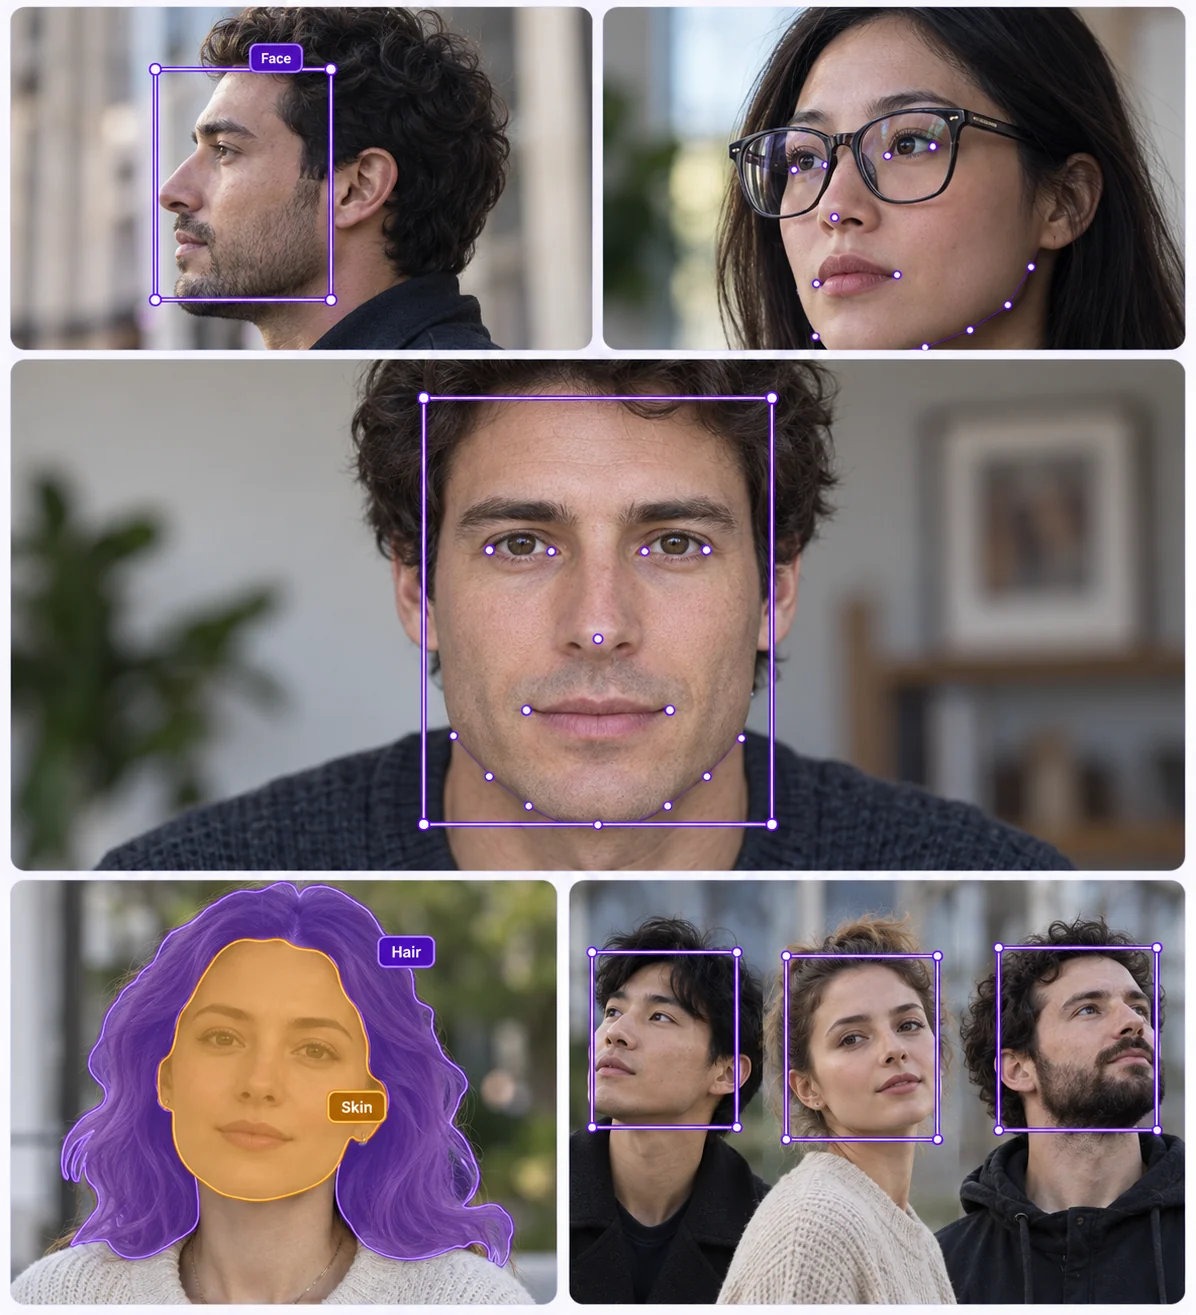
人脸识别标注应用场景
将源数据转化为清晰、针对具体任务的训练样本。
人脸框与关键点
标注人脸边界及规范定义的面部特征点。
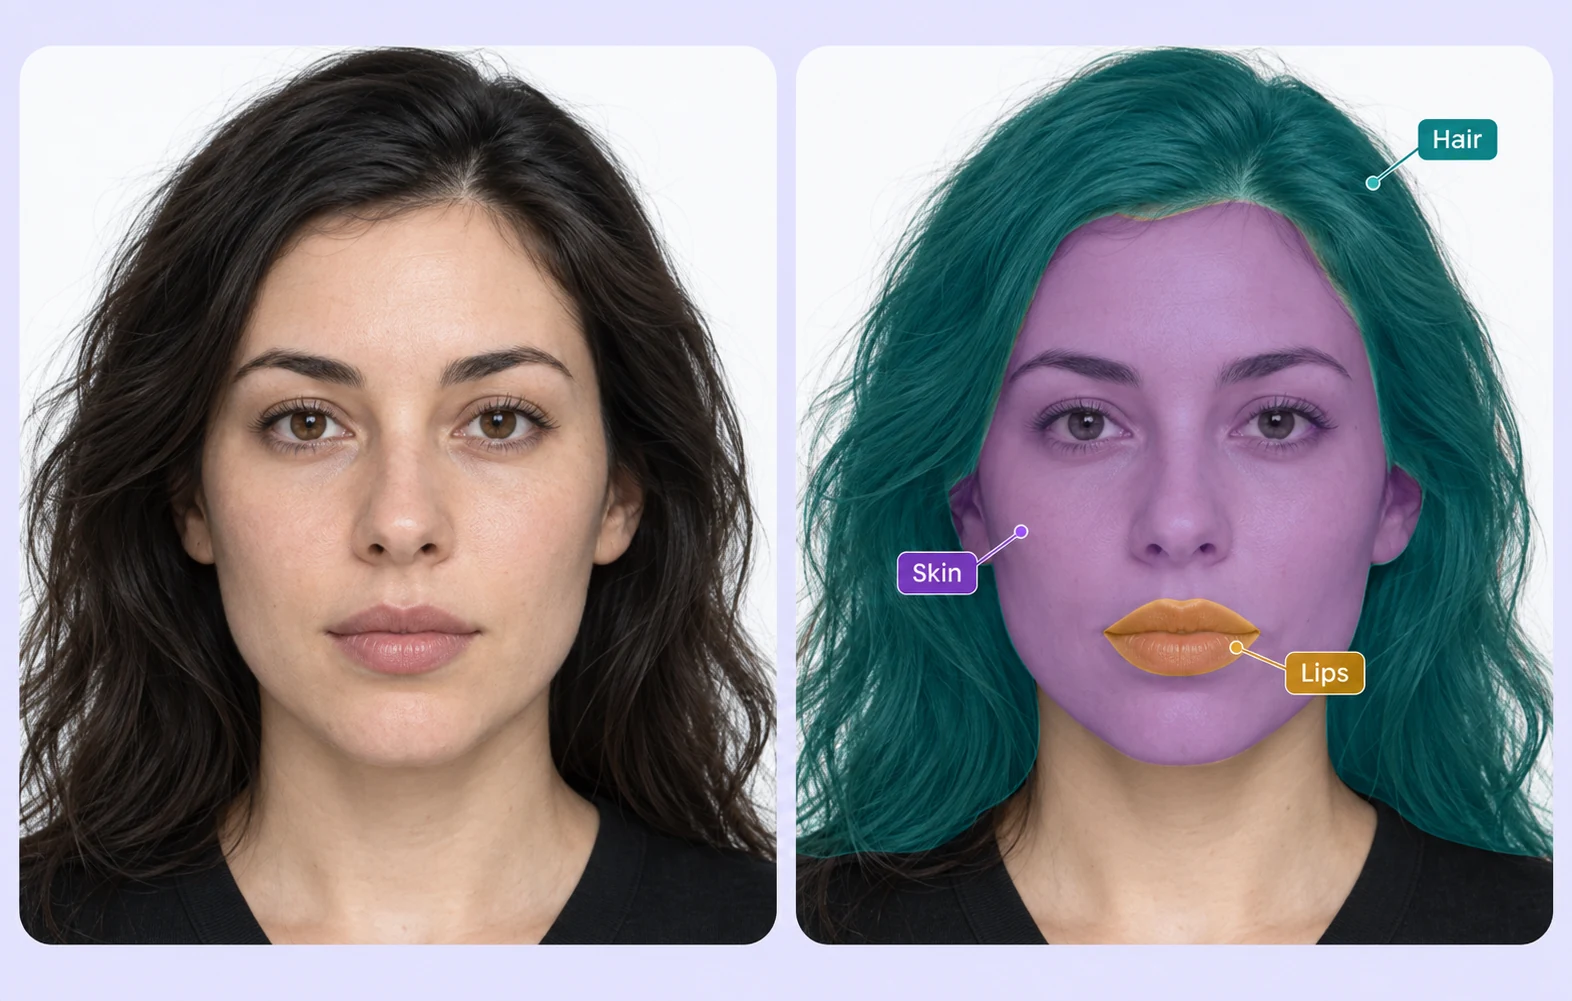
面部区域掩码
按照统一分割规范区分面部区域与头发。
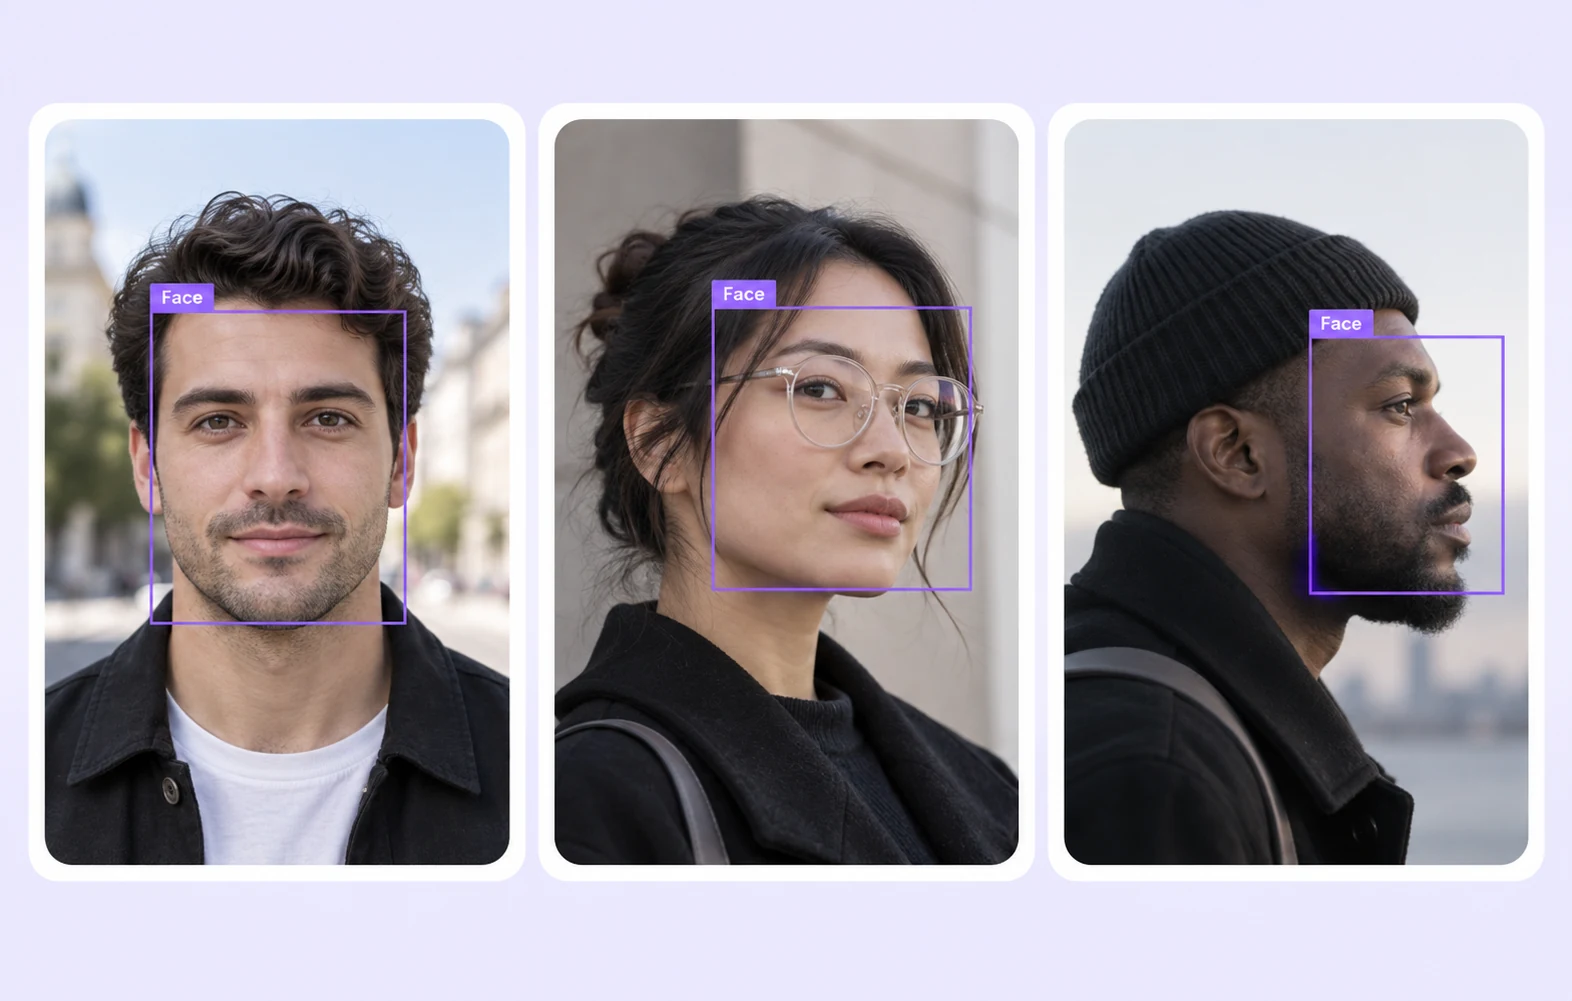
姿态与光照覆盖
筛选不同姿态和光照条件的样本,检查标注一致性。
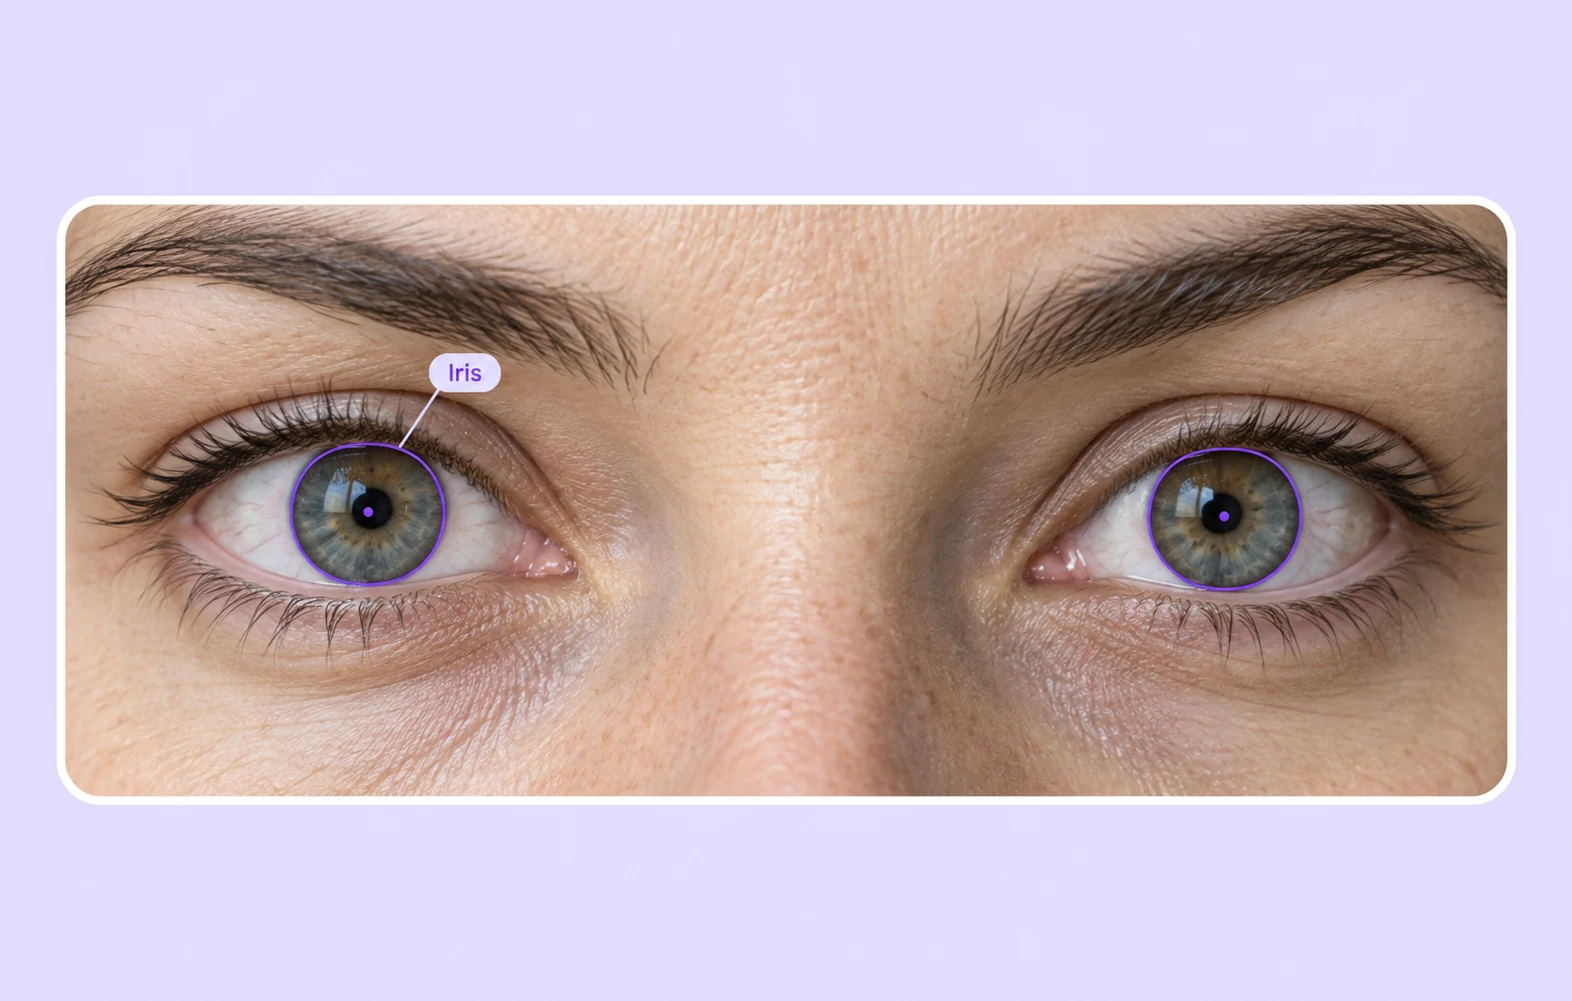
眼部细节
按照任务规范需要,标注可见眼部轮廓与关键点。
AI 团队为何选择 Unitlab
将数据整理、统一标签定义、审核和数据集版本连接到同一工作流程。
15×
更快完成人脸识别标注
使用可复用本体和审核工作流标注面部关键点与属性。
60%
减少数据运营耗时
自动完成人脸识别数据集的筛选、管理和版本控制。
5×
降低训练数据成本
可复用本体和规范化质量控制,减少重复的标注与审核工作。
保留源上下文的标签
让标注几何形状与属性匹配模型任务。
人脸框与关键点集
在整个数据集中应用统一关键点规范,并一致记录可见性。审核复杂姿态,避免推测遮挡后的特征位置。
眼部轮廓
仅描绘任务要求的可见区域。审核精细标注前,定义眼睑遮挡与图像模糊的处理规则。
人脸识别常见问题
什么是人脸识别数据标注?
数据标注为源数据添加定义明确的标签,让模型学习具体任务。人脸识别场景包括人脸框与关键点和面部区域掩码等。Unitlab 的数据标注平台将这些工作连接起来。
这与身份与生物识别方案有何区别?
本页聚焦人脸框、面部关键点和可见区域掩码。身份与生物识别涵盖更广泛的身份数据流程。标注描述源数据中的可见内容,身份标签应来自您有权使用的参考数据。
如何保持标注规则一致?
标注前定义类别、必填属性及边界规则,并利用人脸框与关键点等示例明确歧义。请参阅类别与标注类型指南。
如何筛选有代表性的训练数据?
通过数据整理检查样本并筛选可用元数据。规划姿态、遮挡、光照和图像质量等方面的覆盖,在标注前检查缺失或过度代表的条件。
能否导出数据并连接训练流程?
选择标注任务支持的输出格式,并使用训练代码验证结果。自动化与集成方式请参阅导出格式指南及API、SDK 与 CLI 文档。
需要协助定义标注流程?
联系 Unitlab


