
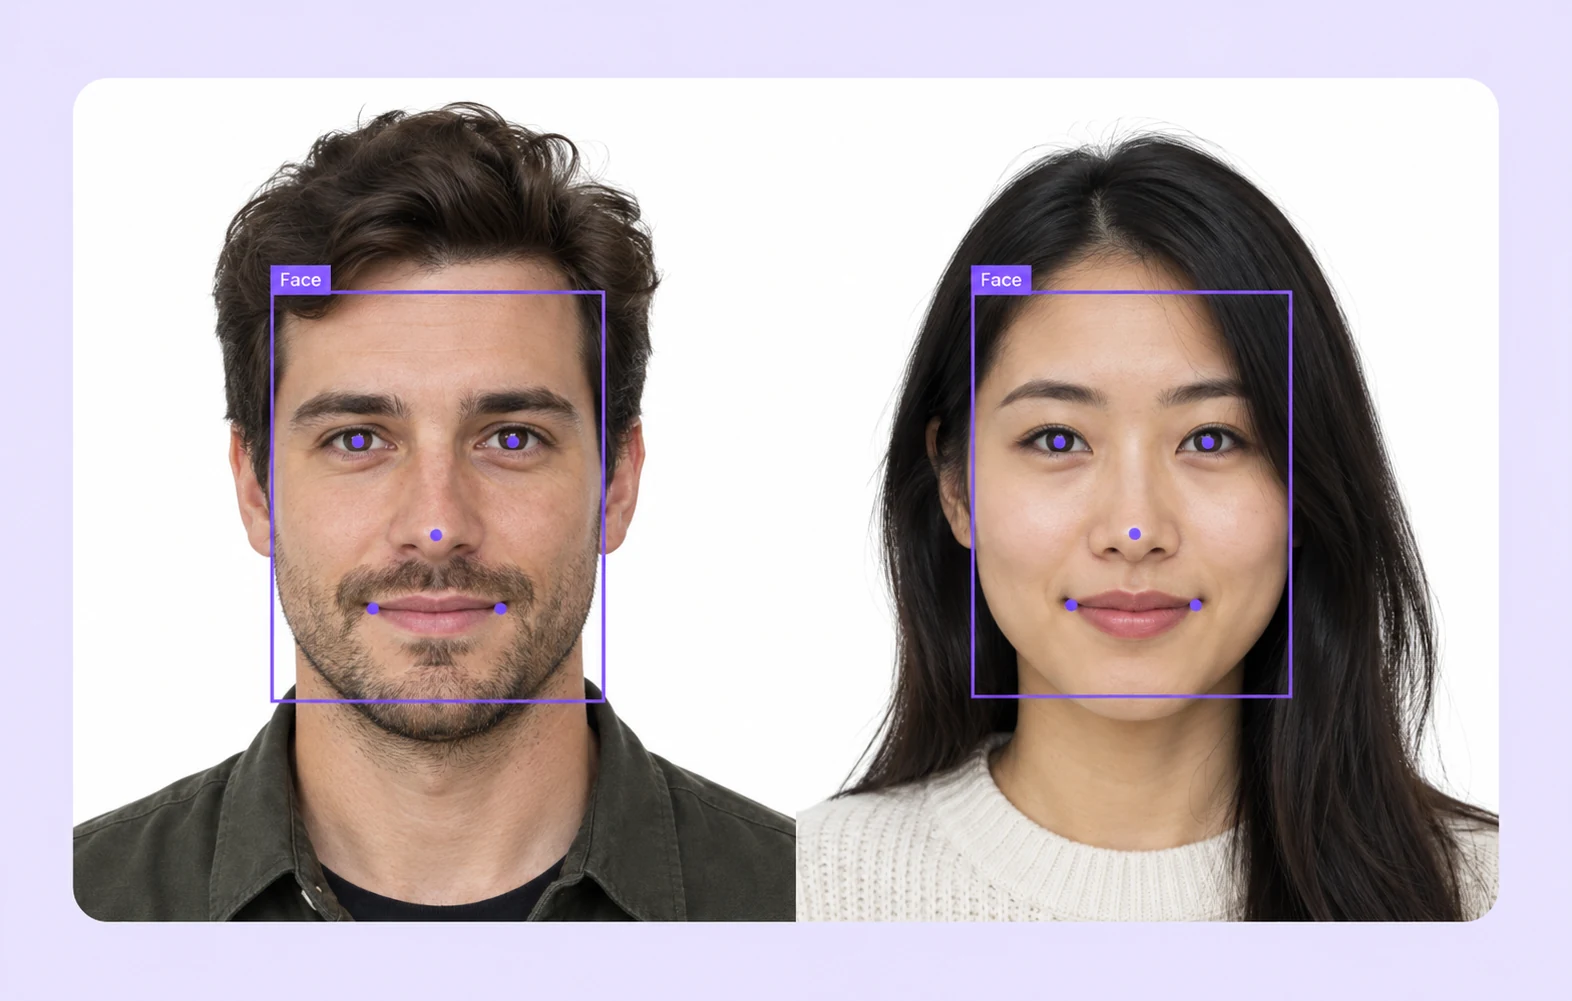
얼굴 인식 AI를 위한 학습 데이터
바운딩 박스, 랜드마크, 영역 마스크로 얼굴 이미지와 영상 프레임을 준비하세요. 다양한 자세, 가림, 촬영 조건에서 보이는 형태를 검토하세요.
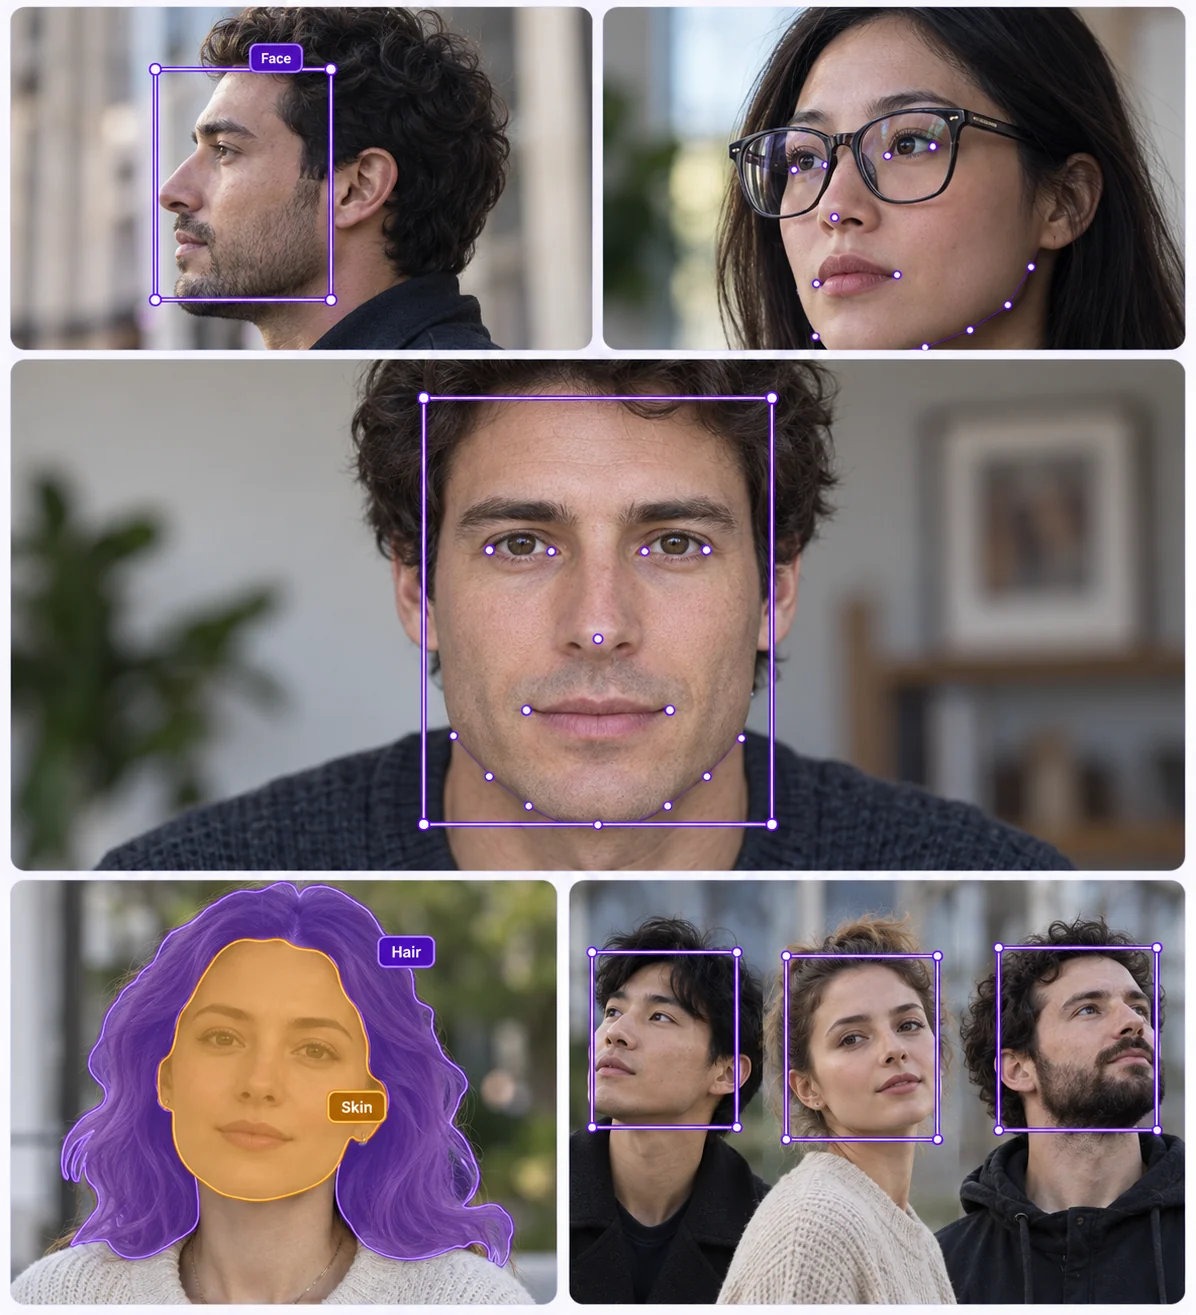
얼굴 인식 어노테이션 활용 사례
원본 데이터를 과제별로 명확한 학습 예제로 만드세요.
얼굴 박스와 랜드마크
얼굴 경계와 지침에 정의된 얼굴 특징점을 표시하세요.
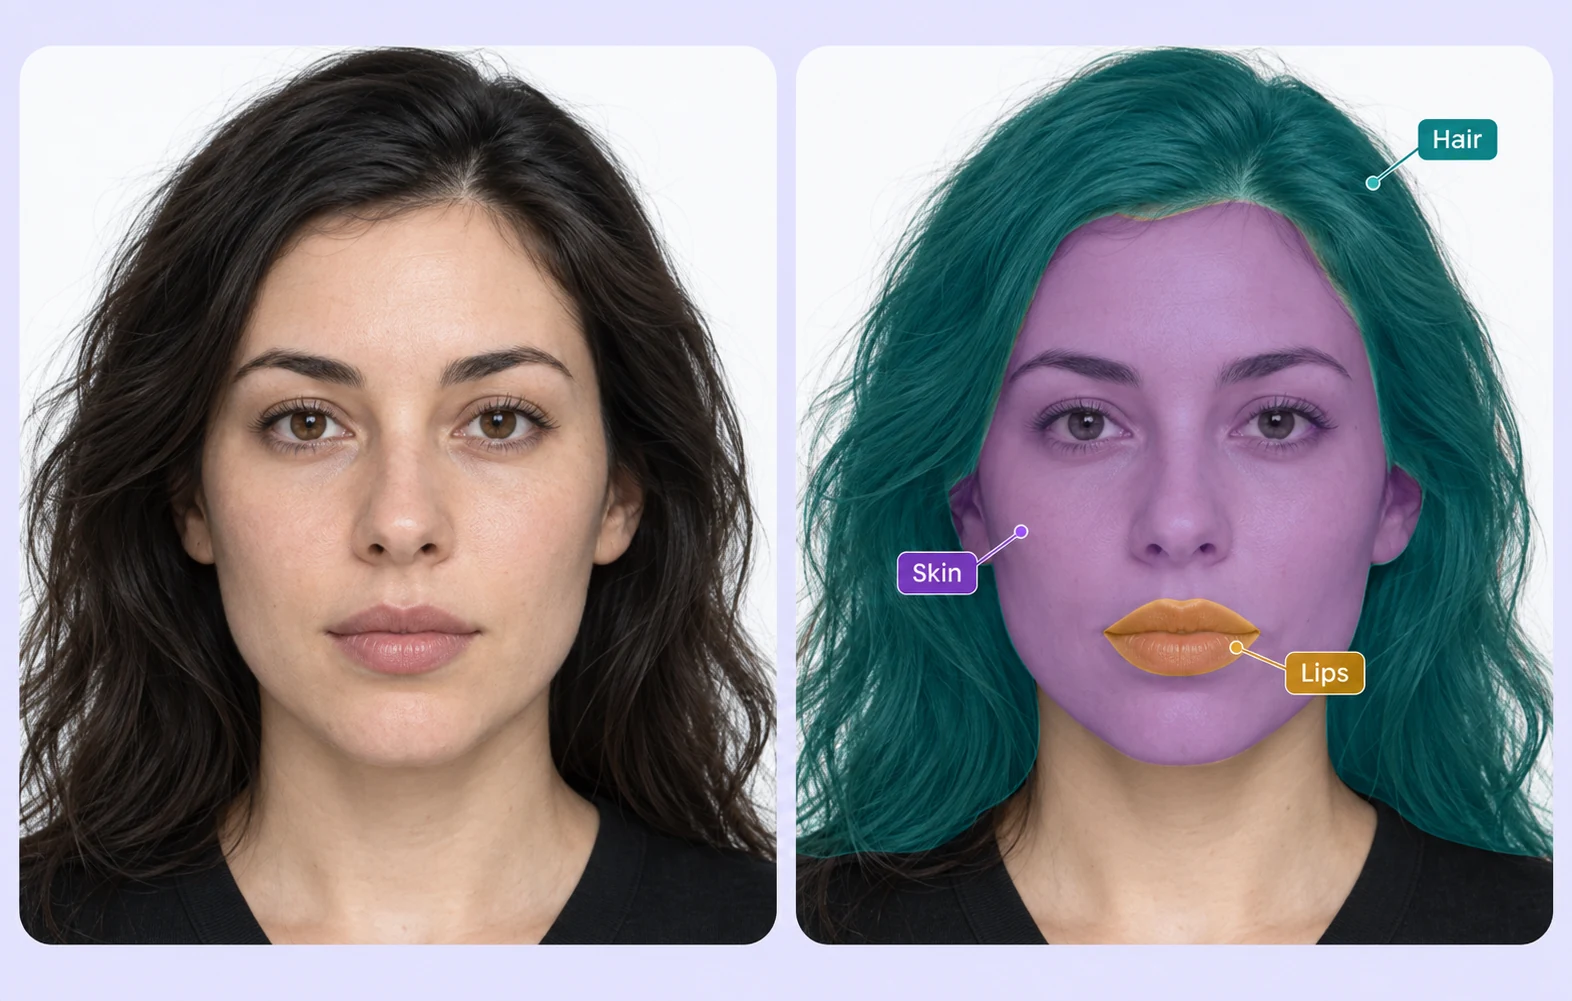
얼굴 영역 마스크
공통 분할 지침에 따라 얼굴 영역과 머리카락을 구분하세요.
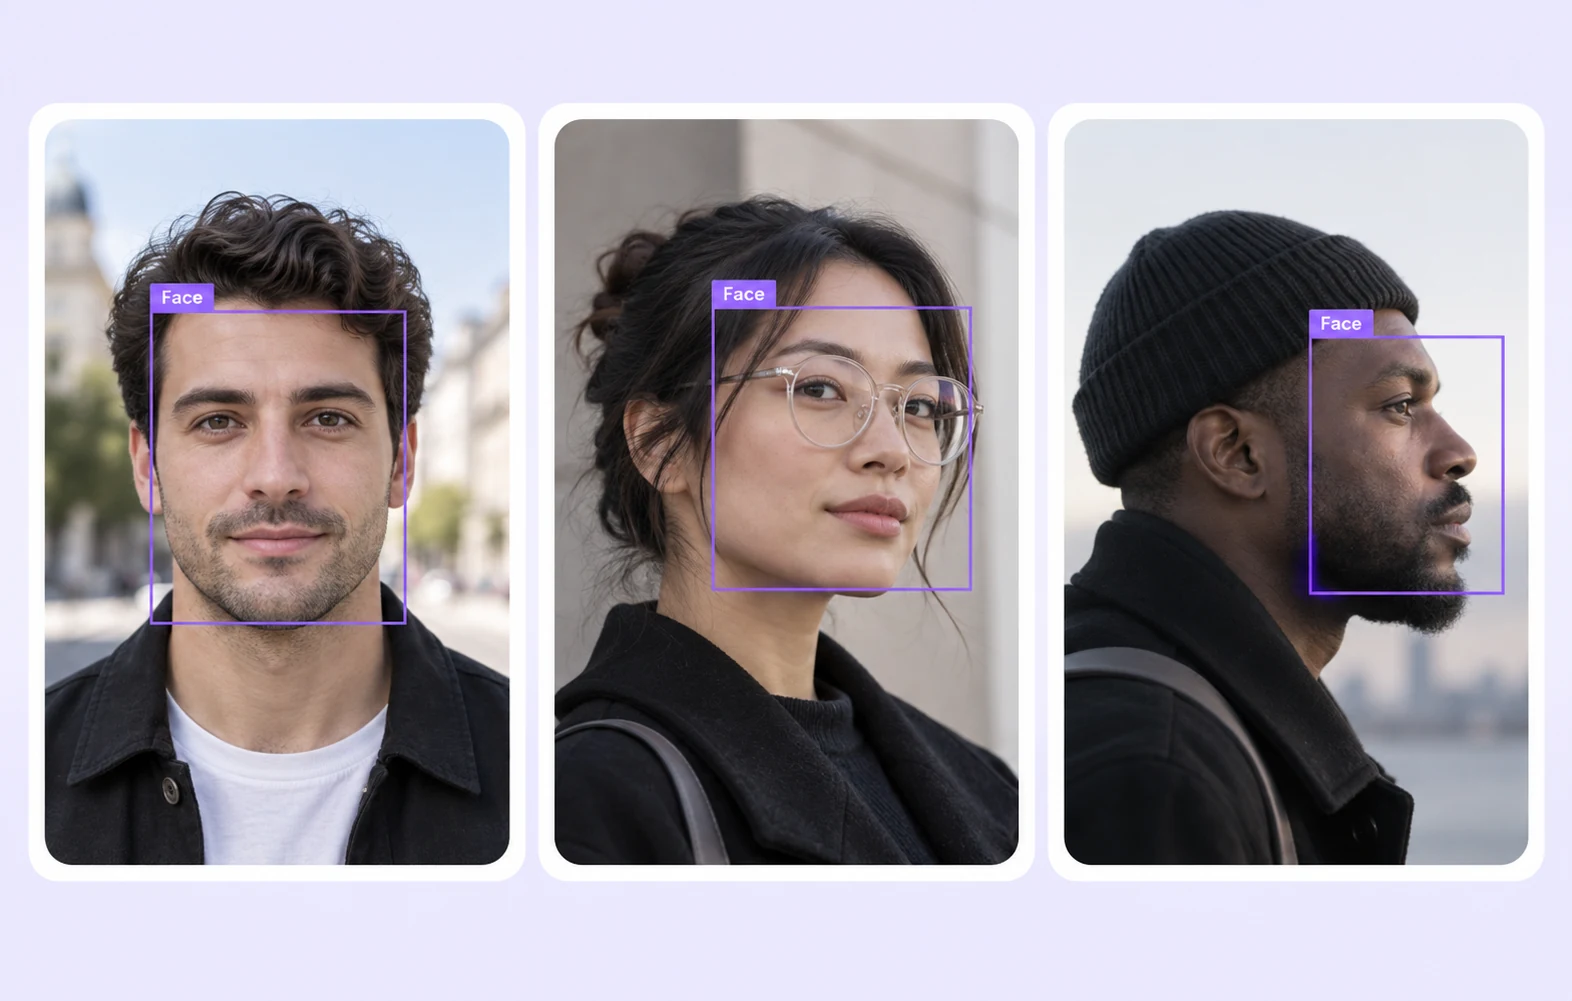
자세와 조명 다양성
다양한 자세와 조명 조건을 선별하고 주석의 일관성을 확인하세요.
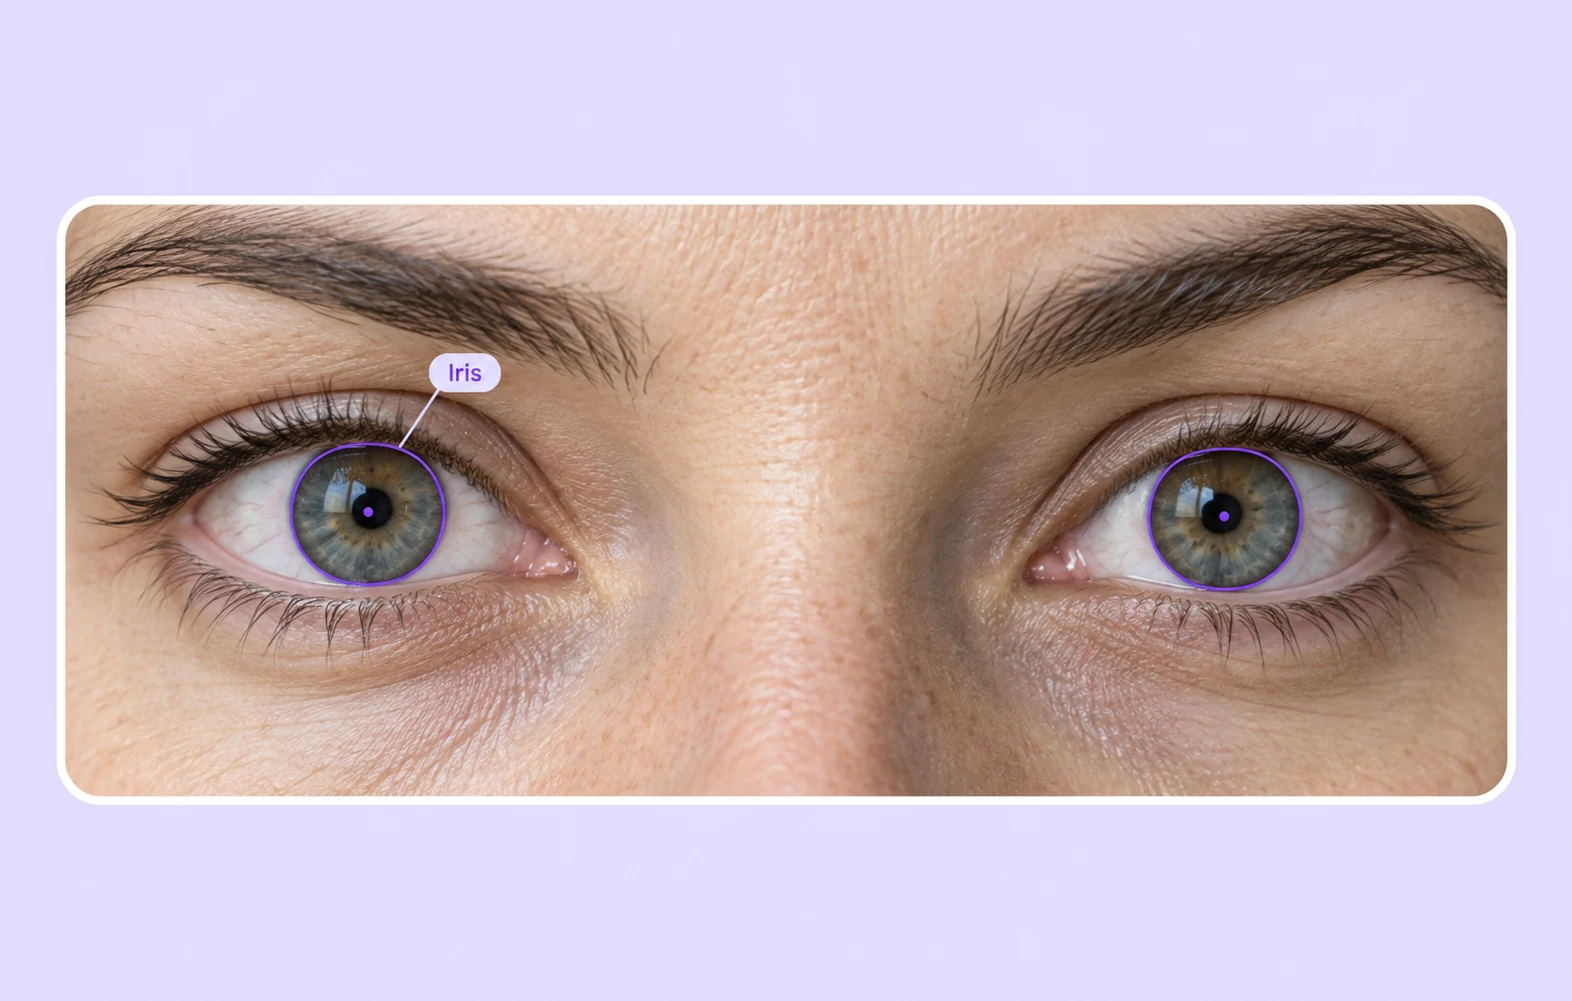
눈 영역 세부 사항
과제 지침에서 요구하는 경우 보이는 눈 윤곽과 랜드마크를 표시하세요.
AI 팀이 Unitlab을 선택하는 이유
데이터 큐레이션, 공통 라벨 정의, 검토, 데이터셋 버전을 하나의 워크플로로 연결하세요.
15×
더 빠른 얼굴 인식 어노테이션
재사용 가능한 온톨로지와 검토 워크플로로 얼굴 랜드마크와 속성을 라벨링합니다.
60%
데이터 운영 시간 절감
얼굴 인식 데이터셋의 큐레이션, 관리, 버전 관리를 자동화합니다.
5×
학습 데이터 비용 절감
재사용 가능한 온톨로지와 체계적인 품질 관리로 반복적인 라벨링과 검토 작업을 줄입니다.
원본 맥락을 유지하는 라벨
모델의 과제에 맞는 주석 형태와 속성을 사용하세요.
얼굴 박스와 랜드마크 집합
데이터셋 전체에 하나의 랜드마크 기준을 적용하고 가시성을 일관되게 기록하세요. 가려진 특징의 위치를 추측하지 말고 어려운 자세를 검토하세요.
눈 영역 윤곽
과제에 필요한 보이는 영역만 표시하세요. 세부 주석을 검토하기 전에 눈꺼풀 가림과 이미지 흐림의 처리 기준을 정의하세요.
얼굴 인식 자주 묻는 질문
얼굴 인식 데이터 어노테이션이란 무엇인가요?
데이터 어노테이션은 모델이 특정 과제를 학습할 수 있도록 원본 데이터에 정의된 라벨을 추가하는 작업입니다. 얼굴 인식 분야에서는 얼굴 박스와 랜드마크, 얼굴 영역 마스크 등의 예제가 사용됩니다. Unitlab의 데이터 어노테이션 플랫폼에서 이러한 작업을 연결할 수 있습니다.
어떤 데이터 유형을 어노테이션할 수 있나요?
신원 확인 및 생체 인식 솔루션과 어떻게 다른가요?
이 페이지는 얼굴 박스, 얼굴 랜드마크, 보이는 영역의 마스크에 초점을 맞춥니다. 신원 확인 및 생체 인식는 더 넓은 신원 데이터 워크플로를 다룹니다. 주석은 원본에서 보이는 내용을 표시하며, 신원 라벨은 사용 권한이 있는 참조 데이터에서 제공해야 합니다.
주석 기준을 어떻게 일관되게 유지하나요?
라벨링 전에 클래스, 필수 속성, 경계 기준을 정의하세요. 얼굴 박스와 랜드마크 등의 예제로 모호한 사례를 정리하세요. 클래스 및 주석 유형 가이드를 참고하세요.
대표성 있는 학습 데이터를 어떻게 선별하나요?
데이터 큐레이션으로 예제를 확인하고 사용 가능한 메타데이터를 필터링하세요. 자세, 가림, 조명, 이미지 품질 등을 고려해 데이터 구성을 계획하고, 주석 작업 전에 부족하거나 과도하게 포함된 조건을 확인하세요.
학습 전에 주석을 어떻게 검토하나요?
데이터셋 버전과 주석 릴리스는 어떻게 다른가요?
데이터를 내보내고 학습 파이프라인에 연결할 수 있나요?
주석 과제에서 지원하는 출력 형식을 선택하고 학습 코드로 결과를 검증하세요. 자동화와 통합 방법은 내보내기 형식 가이드 및 API, SDK 및 CLI 문서에서 확인할 수 있습니다.
어노테이션 워크플로 설계에 도움이 필요하신가요?
Unitlab에 문의하기


