자율주행을 위한 LiDAR 학습 데이터

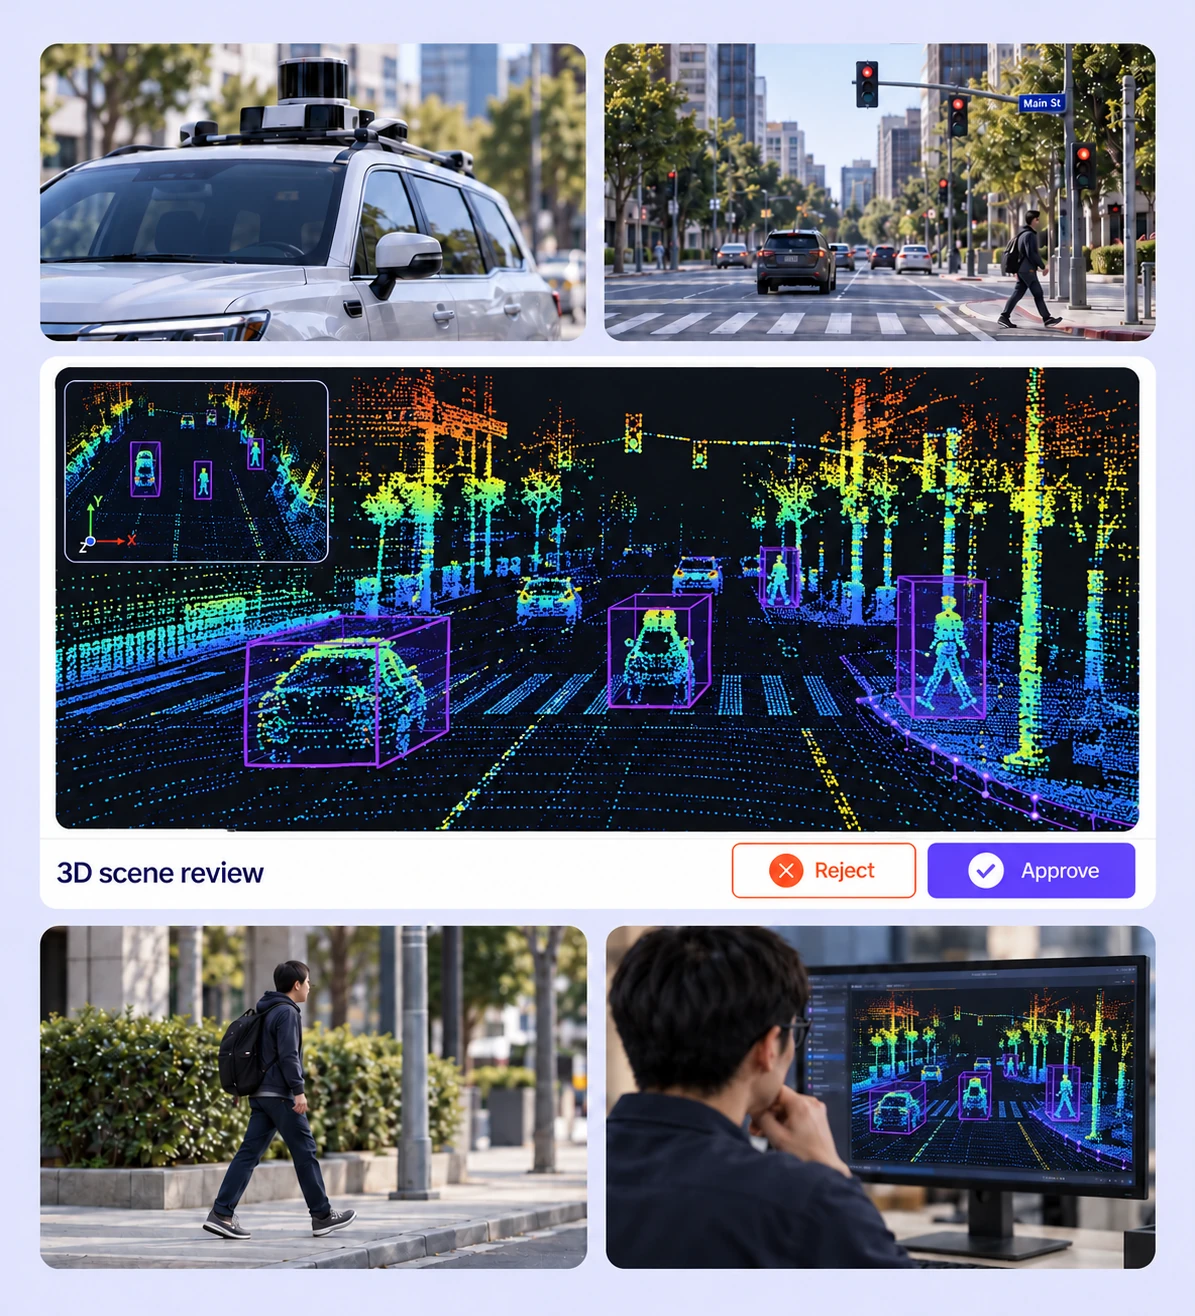
포인트 클라우드 장면에서 차량, 보행자, 자전거 이용자와 도로 구조를 라벨링하세요. 주행 인지 데이터셋을 위해 3D 도형, 객체 식별 정보, 캘리브레이션된 카메라 맥락을 유지합니다.
LiDAR street scan with height-colored laser returns and labeled vehicle and road-user cuboids.

자율주행을 위한 LiDAR 어노테이션

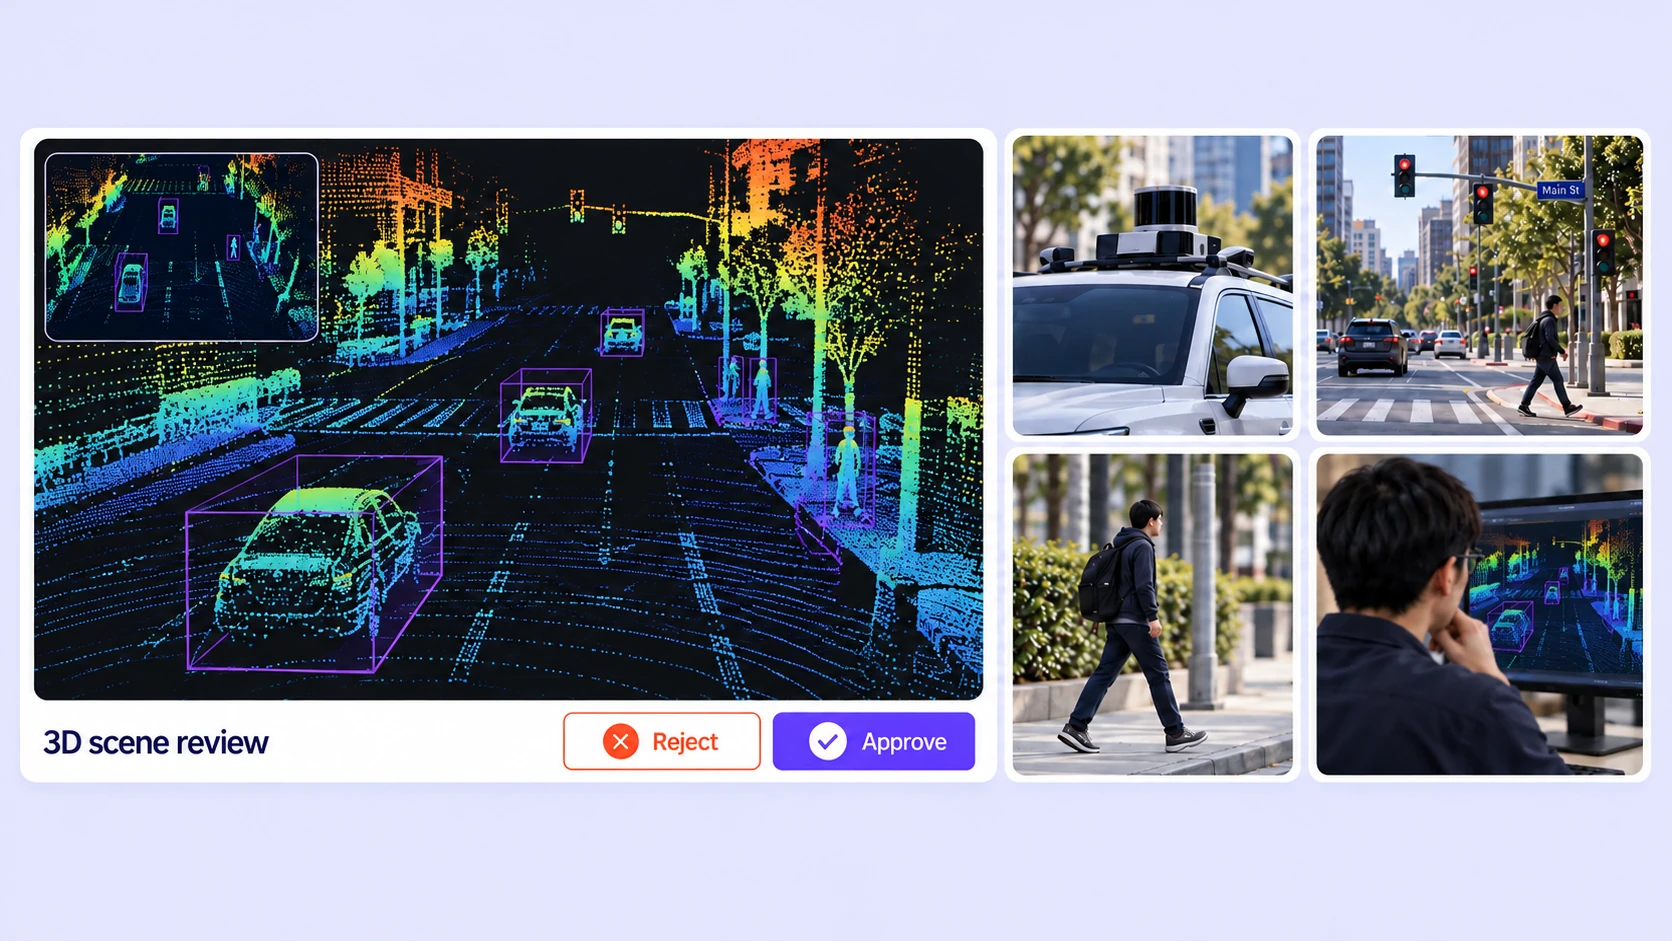
일관된 3D 도형과 카메라 정보를 활용해 도로 이용자, 도로 구조와 객체 움직임을 라벨링하세요.
LiDAR street scan with height-colored laser returns and labeled vehicle and road-user cuboids.

차량 3D 바운딩 박스

승용차, 버스, 트럭에 방향이 있는 3D 바운딩 박스를 맞추세요. 상단, 측면, 후면 뷰에서 위치, 크기와 회전을 확인합니다.
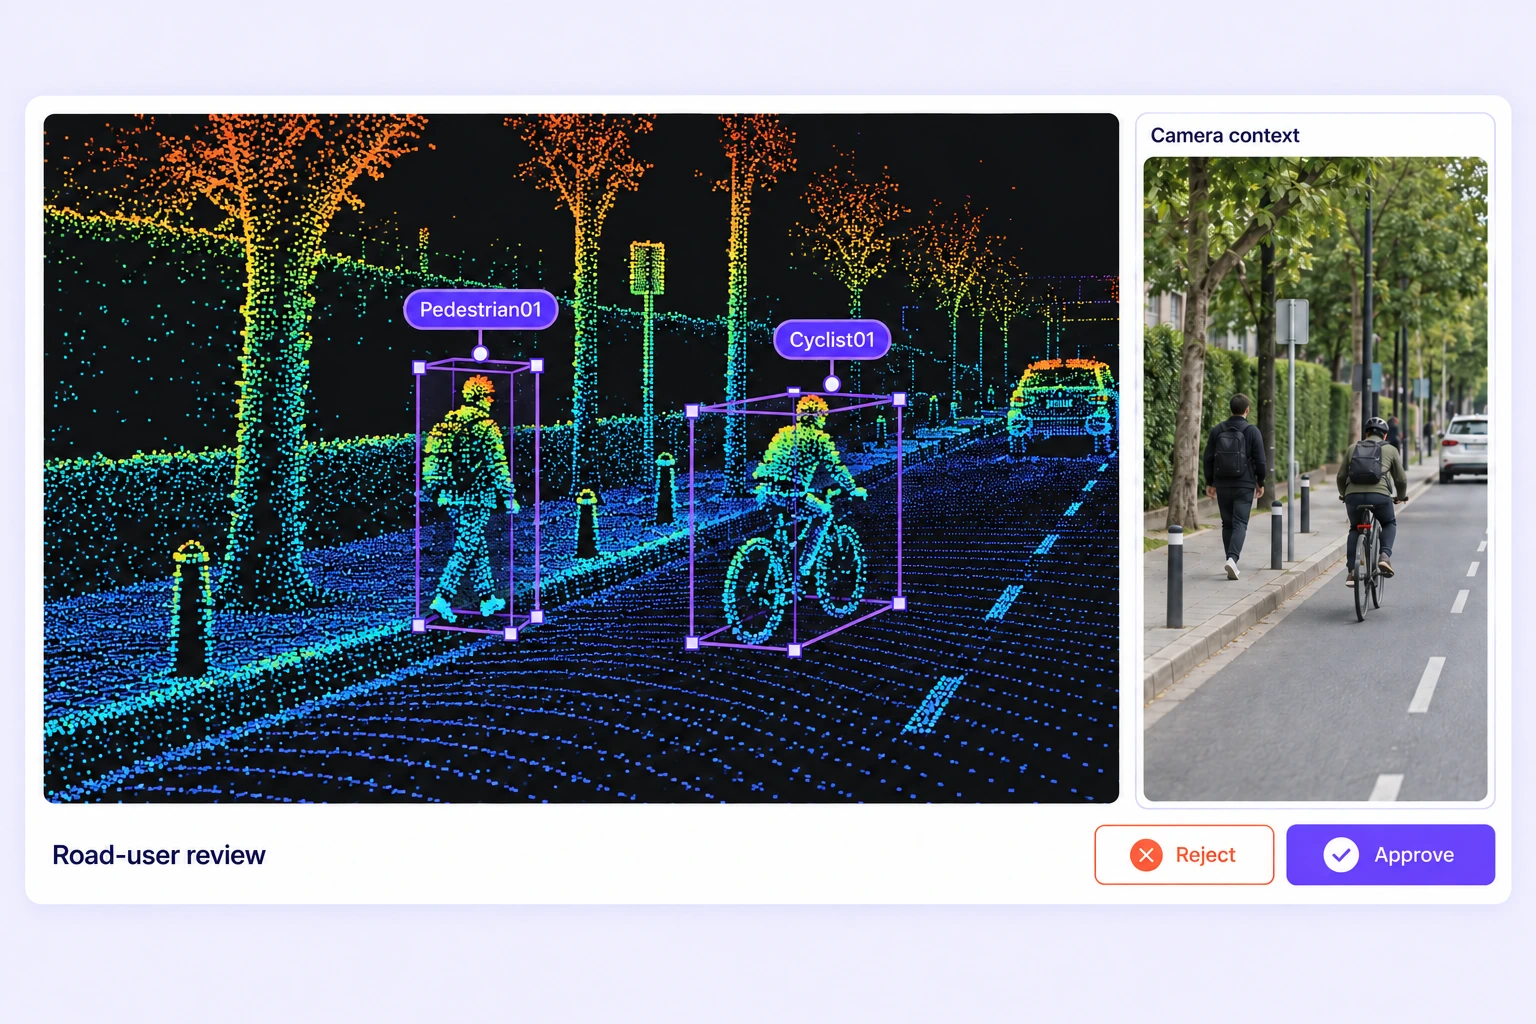
LiDAR point cloud with separate cuboids around a pedestrian and cyclist, alongside calibrated camera context.

교통약자 라벨링

보행자와 자전거 이용자를 주변 장면과 함께 라벨링하세요. 캘리브레이션된 카메라 영상으로 희소한 측정값과 부분적으로 보이는 객체를 검토합니다.
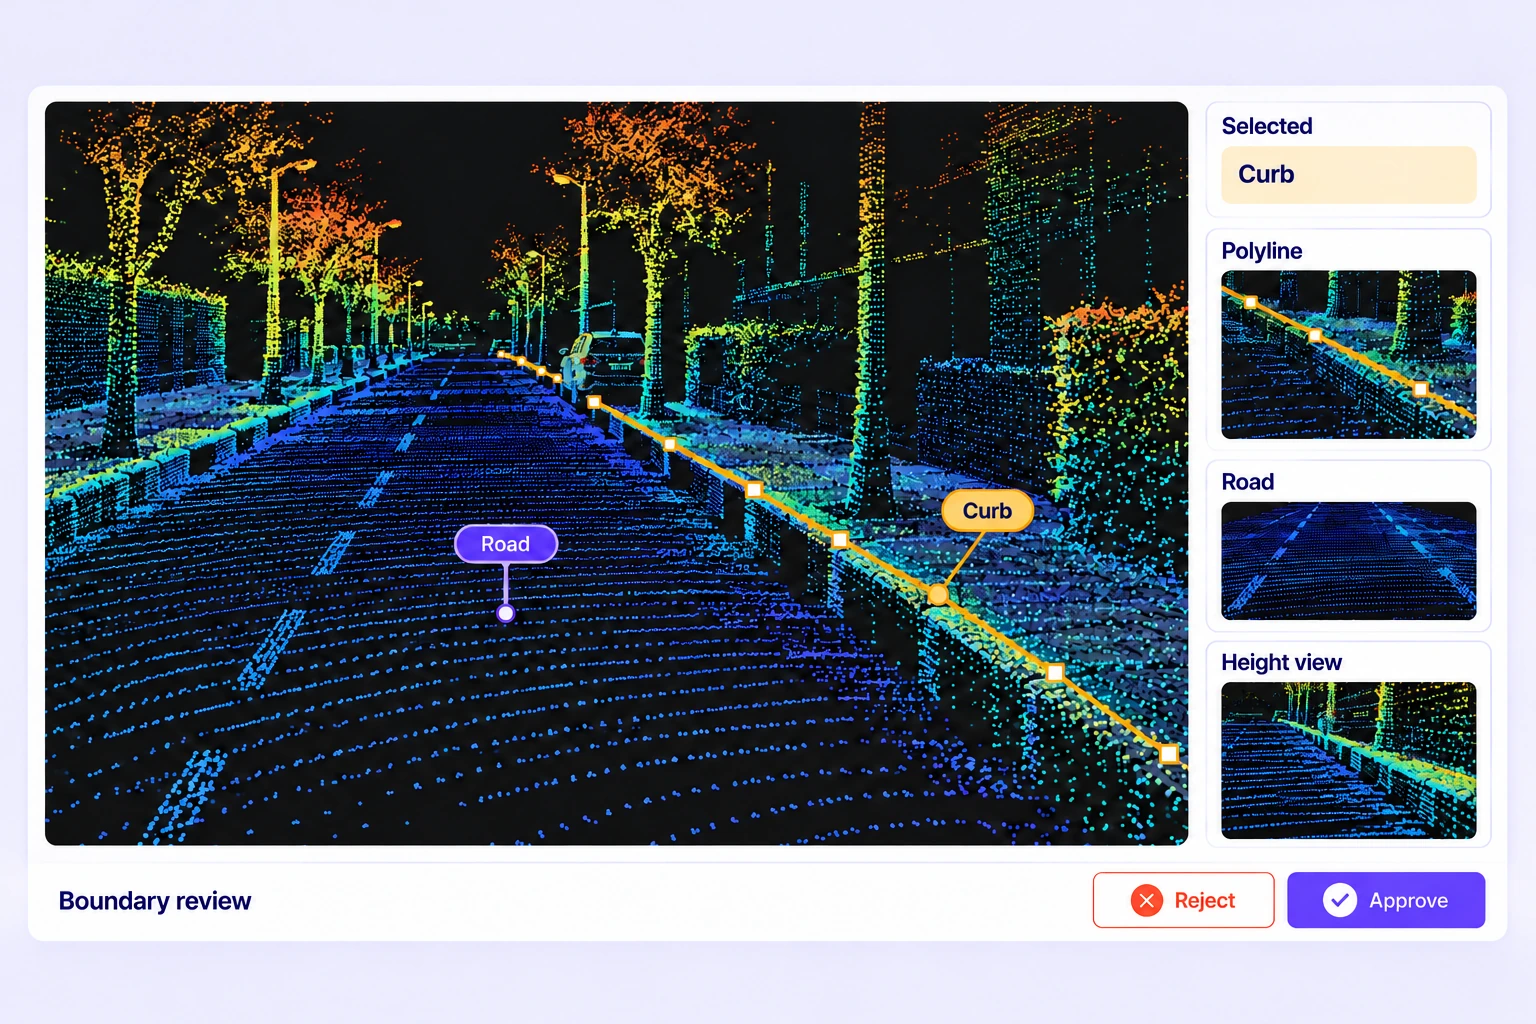
Road point cloud with labeled road points and a vertex-based polyline following the curb edge.

도로 구조와 포인트 라벨

3D 폴리라인으로 연석과 도로 경계를 표시하고, 작업에서 정의한 장면 영역의 포인트에 클래스를 지정하세요.
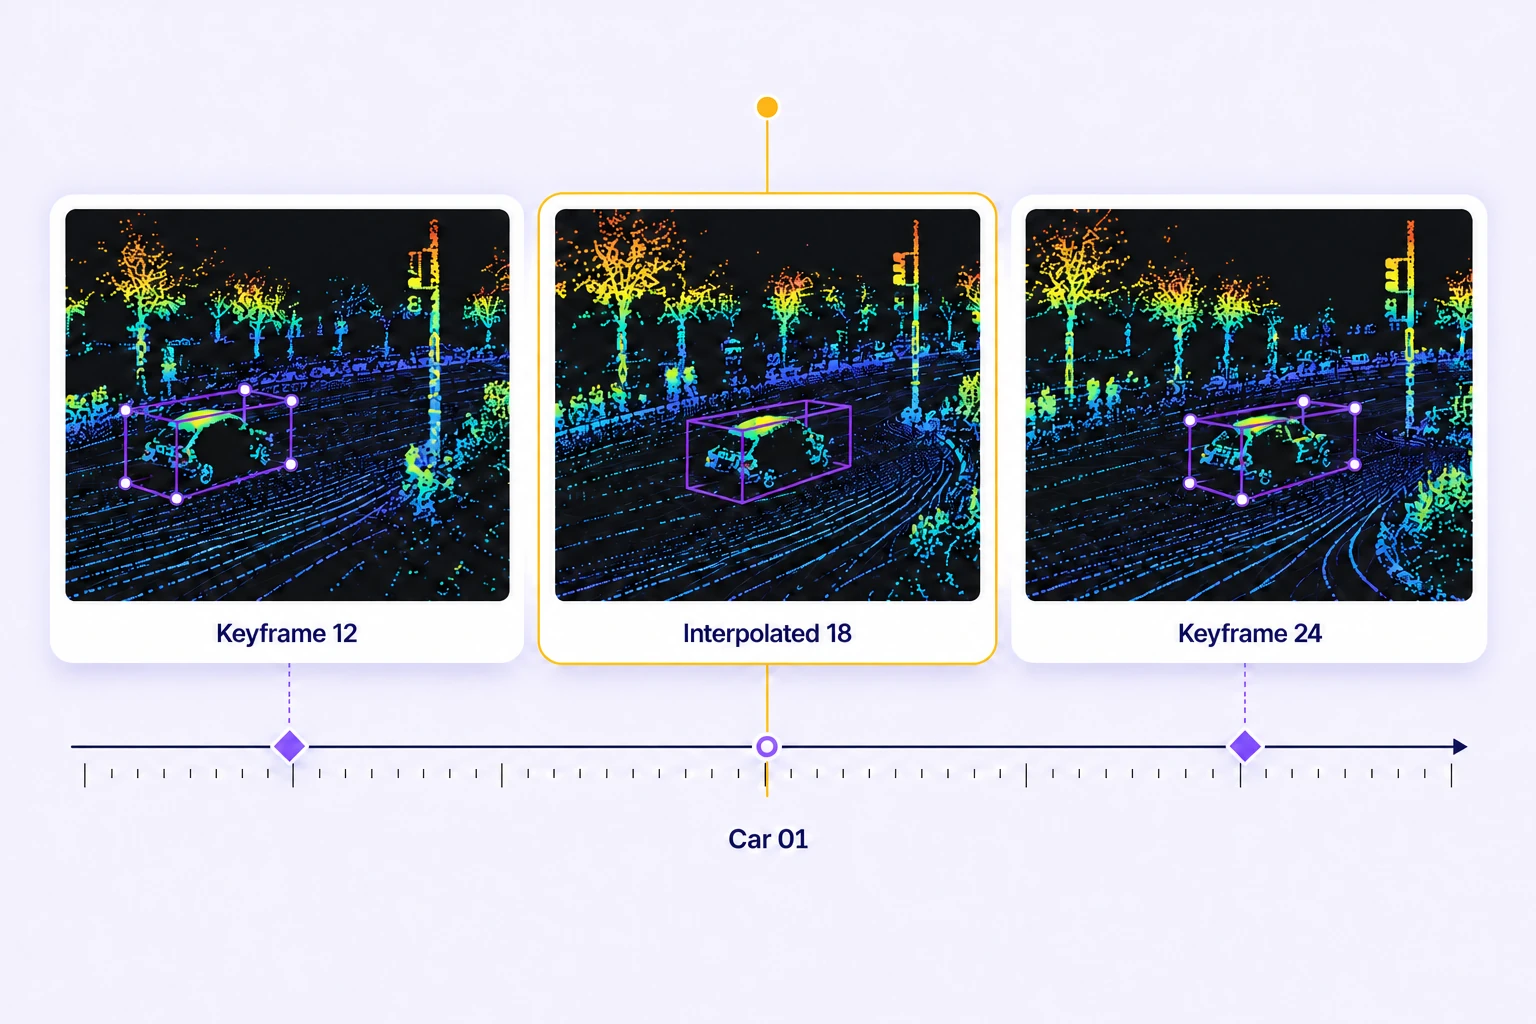
Two manually edited car cuboid keyframes surround an interpolated frame on a height-colored LiDAR sequence timeline.

시간에 따른 객체 트랙

키프레임과 가시성 구간 전반에서 객체 식별 정보를 유지하세요. 승인 전에 보간된 바운딩 박스와 카메라 기반 추적 결과를 검토합니다.

대규모 AI 데이터를 위해 설계된 플랫폼

AI 기반 자동화, 확장 가능한 워크플로, 낮은 운영 비용으로 복잡한 LiDAR 데이터셋을 더 빠르게 어노테이션합니다.
15×
더 빠른 LiDAR 데이터 어노테이션

배치 워크플로, 카메라 기반 Find Similar와 Auto-Tracking, 보간으로 반복적인 수동 LiDAR 라벨링을 줄입니다.

85%
자동화된 LiDAR 어노테이션

평균적으로 LiDAR 라벨의 85%가 자동으로 사전 라벨링되며, 이후 사람이 검토하고 다듬습니다.

15×
학습 데이터 비용 절감

큐레이션, 어노테이션, QA를 자동화하면 승인된 라벨당 비용을 최대 1/15 수준으로 낮출 수 있습니다.
자율주행 어노테이션 방법

주행 인지 모델을 위해 도로 이용자의 3D 바운딩 박스, 장면 구조와 시간에 따른 트랙을 결합하세요.
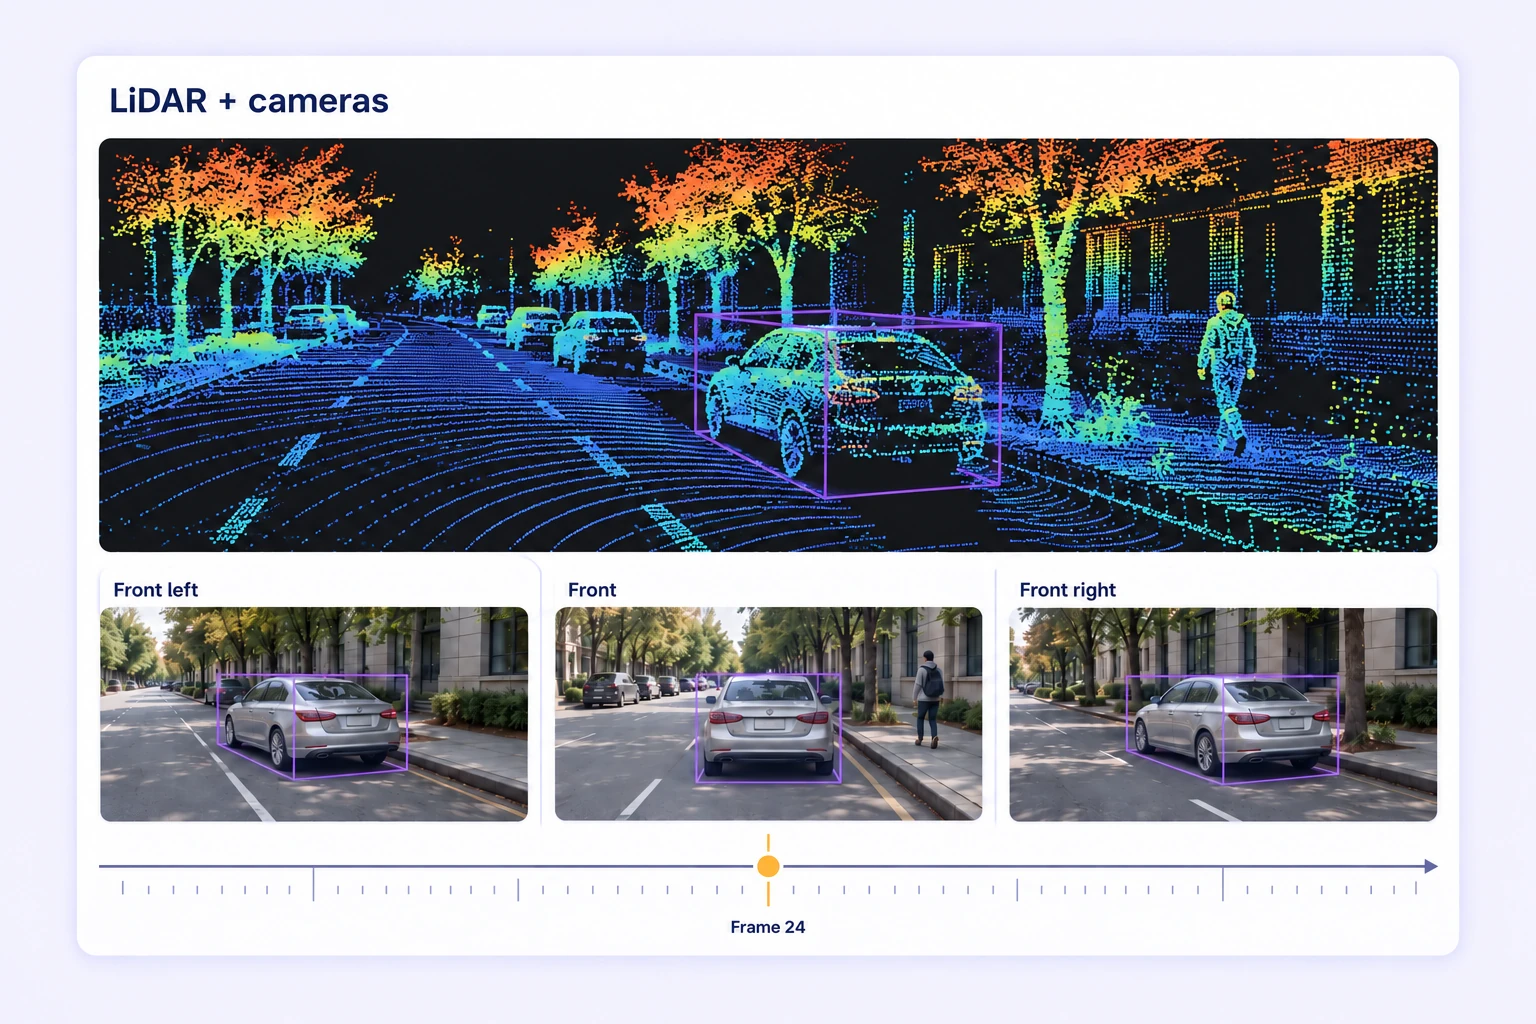
A height-colored LiDAR road scene and three synchronized camera views show the same silver car with a shared purple cuboid.

카메라 정보와 3D 바운딩 박스

포인트 클라우드와 연결된 캘리브레이션 카메라 뷰에서 도로 이용자의 바운딩 박스를 확인하세요. 3D 라벨을 기준으로 유지하면서 영상 정보로 클래스와 경계의 모호함을 해소합니다.

키프레임과 가시성 검토

움직임이나 가시성이 바뀌는 지점에서 바운딩 박스 키프레임을 다듬으세요. 인접 프레임의 보간 결과를 검토하고 프로젝트의 가림 규칙을 일관되게 적용합니다.
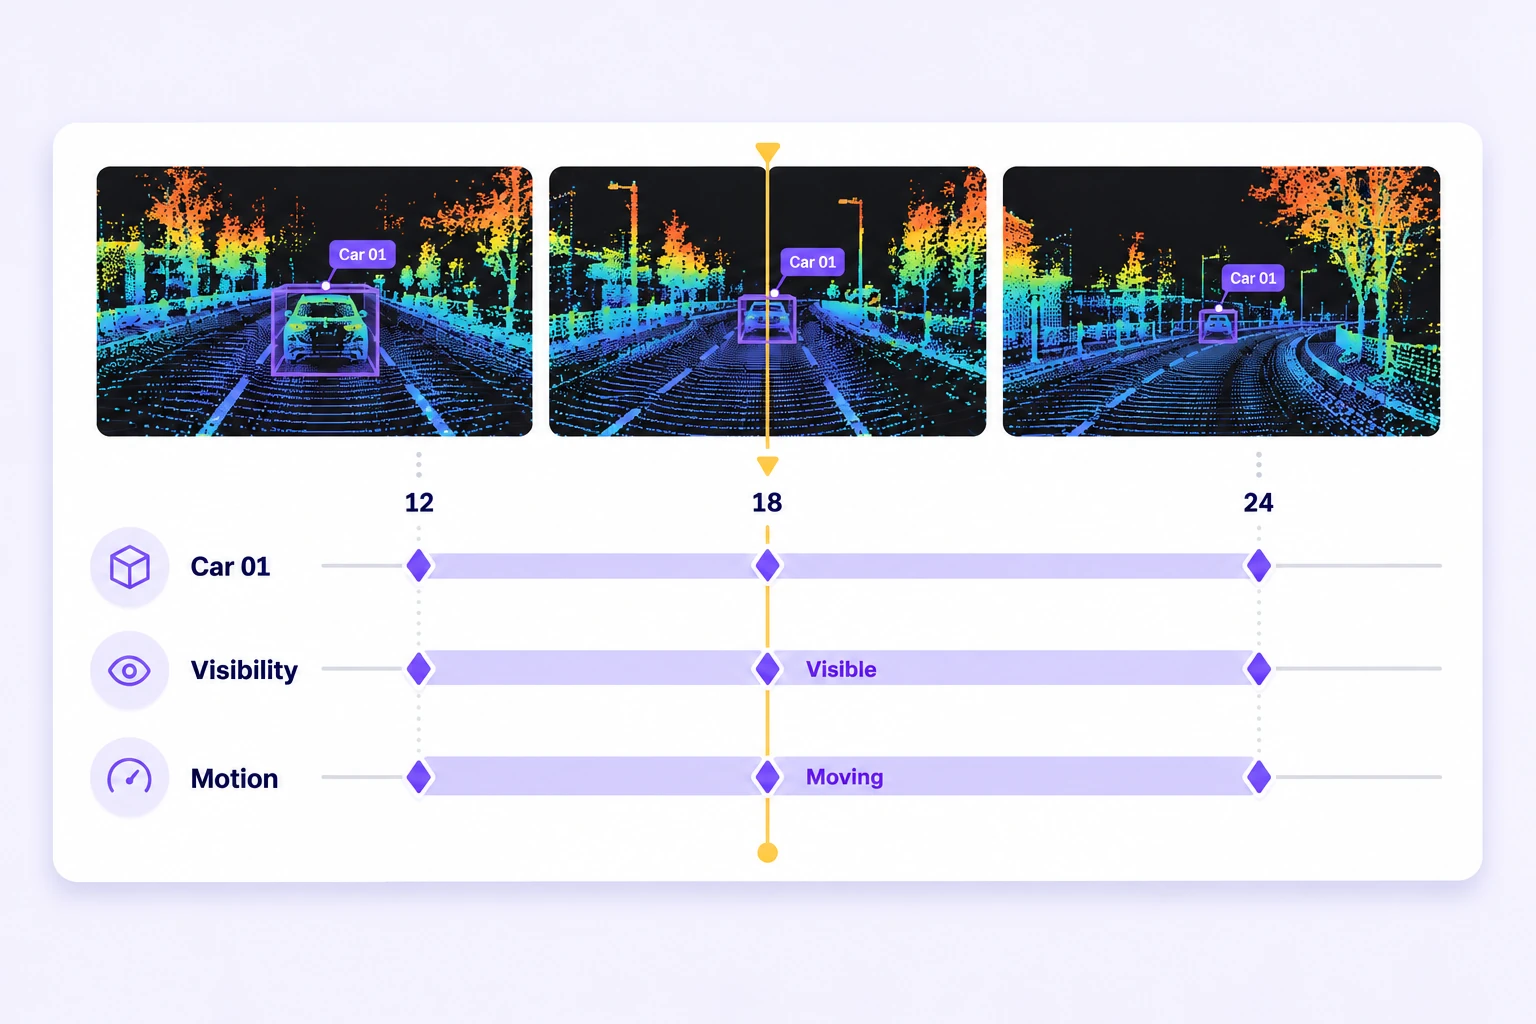
Three height-colored LiDAR frames of Car 01 align with object keyframes, visibility and motion rows on a shared annotation timeline.

자율주행 LiDAR 어노테이션 FAQ

자율주행을 위한 LiDAR 어노테이션이란 무엇인가요?

기록된 포인트 클라우드 장면의 객체와 공간 구조에 라벨을 부여해 주행 인지 학습 데이터를 준비하는 작업입니다. 라벨에는 객체의 3D 범위, 포인트 클래스, 도로 경계와 프레임 간 변화가 포함될 수 있습니다.

어떤 도로 이용자와 장면 요소를 라벨링할 수 있나요?

차량, 보행자, 자전거 이용자와 모델에 필요한 도로 요소의 클래스를 정의하세요. 객체 범위에는 3D 바운딩 박스, 경계에는 폴리라인, 클래스별 영역에는 포인트 분할을 사용합니다.

LiDAR를 카메라 영상과 함께 검토할 수 있나요?

네. 장면에 여러 포인트 클라우드 센서와 카메라 영상을 포함할 수 있습니다. 필요한 캘리브레이션과 포즈 정보를 제공하면 투영된 라벨과 연결된 카메라 바운딩 박스가 각 뷰에 일관되게 배치됩니다.

3D 바운딩 박스의 자동 추적은 어떻게 작동하나요?

카메라 기반 추적은 캘리브레이션된 카메라 시퀀스에서 투영된 객체 박스를 따라간 뒤 LiDAR 포인트에 3D 바운딩 박스를 맞춥니다. 생성된 트랙을 검토하고 키프레임을 다듬을 때 수동 수정 사항은 보존됩니다.

키프레임과 보간은 어떻게 작동하나요?

바운딩 박스 트랙은 객체 식별 정보, 도형, 키프레임과 가시성 구간을 유지합니다. 보간은 키프레임 사이의 위치, 크기와 회전을 채웁니다. 어노테이터는 결과를 포인트 클라우드와 대조하고 모호한 움직임이나 가시성 변화를 수정합니다.

어떤 LiDAR 입력 형식을 지원하나요?

Unitlab은 PCD, PLY, BIN 포인트 클라우드와 ZIP 및 폴더 기반 장면 업로드를 지원합니다. 장면 매니페스트에 센서, 프레임, 카메라 캘리브레이션과 포즈를 정의할 수 있습니다. 주행 데이터셋을 가져오기 전에 형식과 장면 구조를 확인하세요.

주행 인지 어노테이션은 어떻게 검토하나요?

공유 지침, 필수 속성, 전문가 검토, 독립 LiDAR 장면의 Consensus, Quality Gate 기준 데이터를 사용하세요. 프레임 전반에서 도형과 객체 식별 정보를 확인하고 문제를 해결한 뒤 라벨을 승인합니다.

어노테이션 전에 장면을 큐레이션할 수 있나요?

네. 폴더, 태그, 메타데이터와 제공되는 필터로 장면을 정리하세요. 대표적인 경로, 조건과 어려운 사례를 선택하고 데이터셋 버전에 기록해 어노테이션과 검토에 사용합니다.

검토된 3D 어노테이션을 내보낼 수 있나요?

검토된 LiDAR 어노테이션을 Unitlab Unified Export Format(UUEF)으로 내보내면 지원되는 도형, 트랙, 장면 메타데이터, 캘리브레이션과 포인트 라벨 배열이 유지됩니다. 사용 전에 학습 코드에 맞는 클래스 규칙과 좌표 처리를 확인하세요.