자율주행 인지를 위한 카메라 이미지 학습 데이터

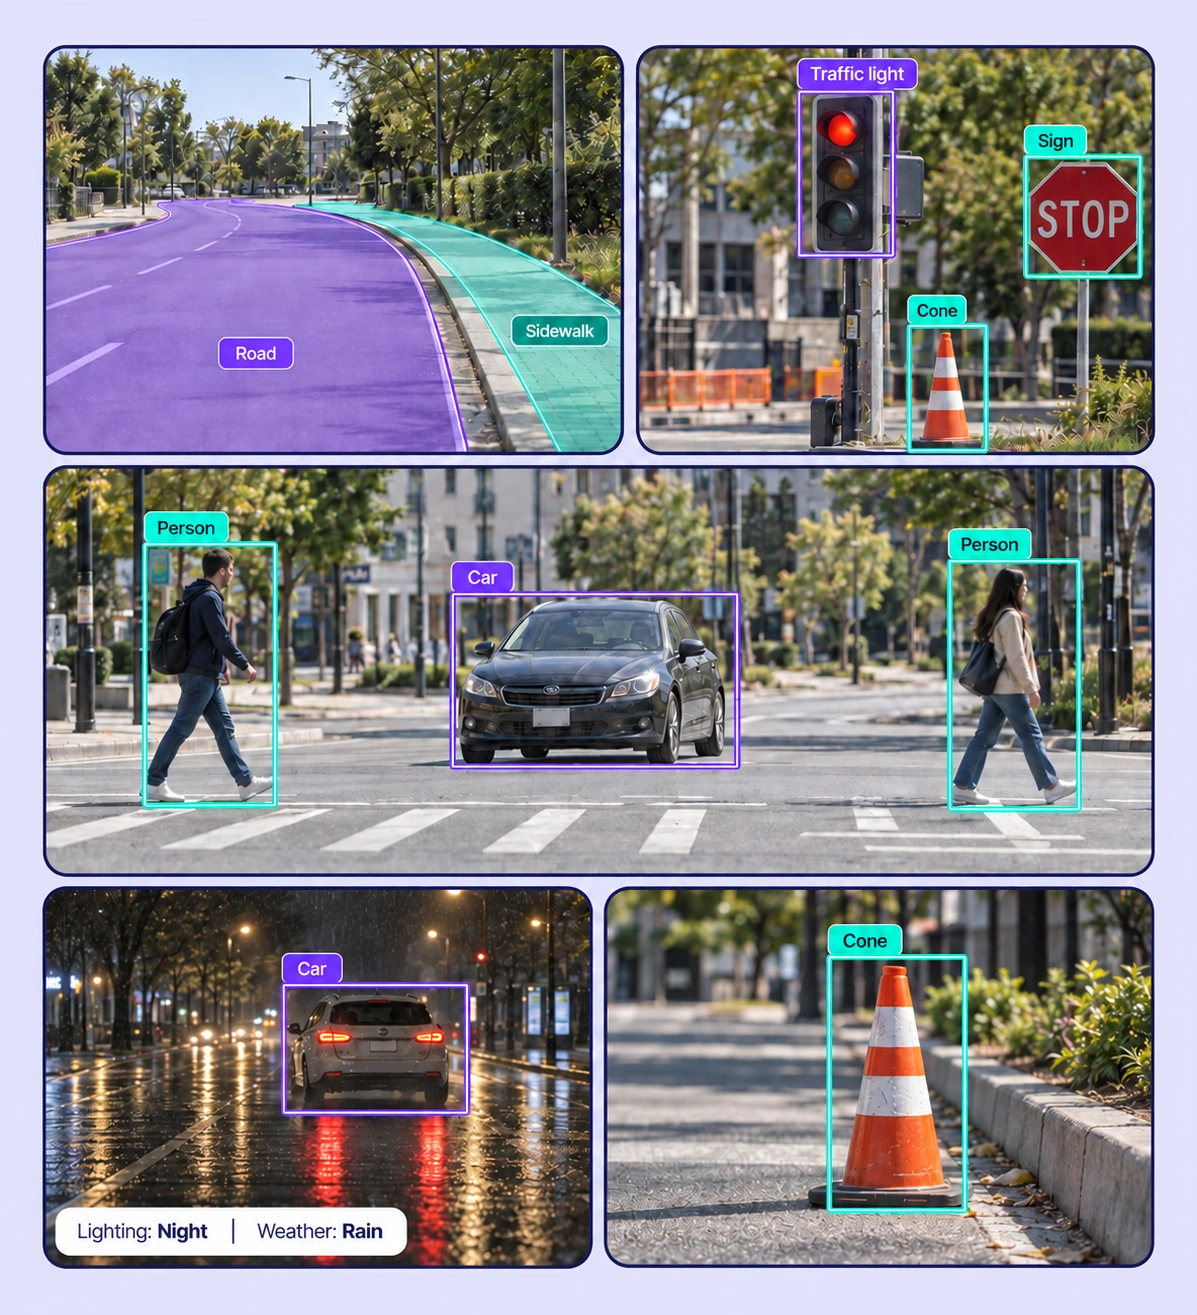
도로 이용자, 주행 가능 영역, 눈에 보이는 장애물의 검토된 2D 라벨을 준비하세요. 인지 모델이 학습하는 카메라 이미지 전반에서 클래스 정의와 장면 조건 라벨의 일관성을 유지합니다.
Annotated autonomous perception examples arranged in a five-panel collage.

자율주행 인지를 위한 데이터 어노테이션

모델이 학습해야 하는 카메라 기반 인지 작업의 라벨링된 예제를 준비하세요. 각 활용 사례에서 원본 데이터, 어노테이션 규칙, 검토된 라벨을 연결합니다.
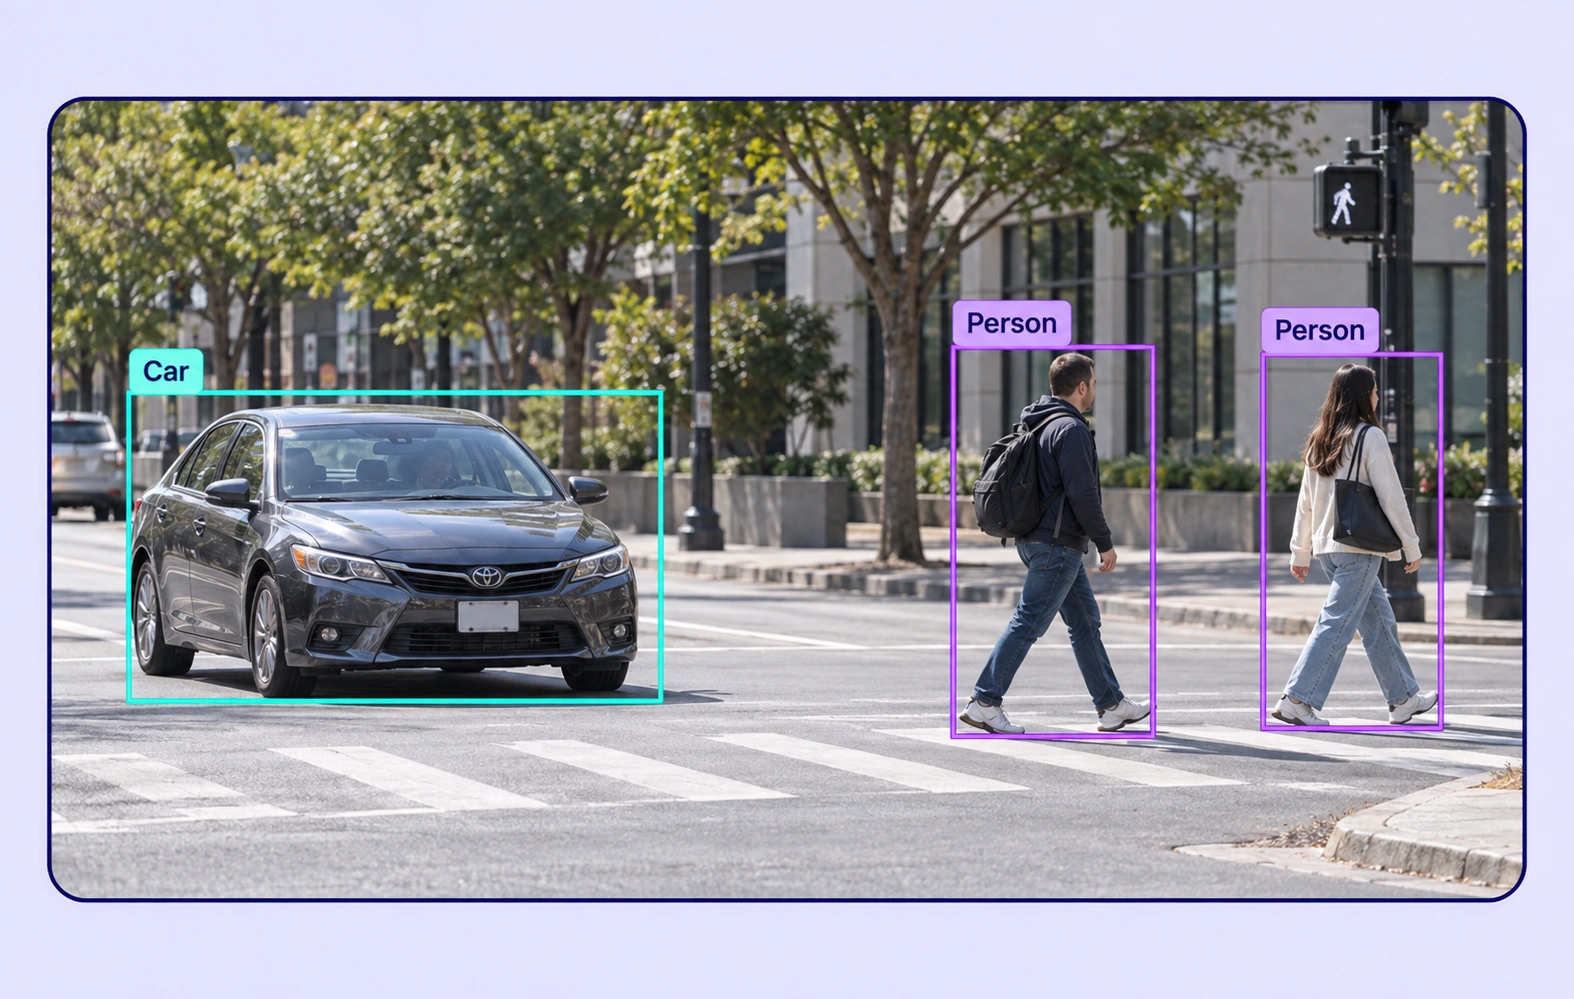
Road-User Detection annotation example showing the source data and task-specific labels.

도로 이용자 탐지

카메라 이미지에서 차량, 보행자, 자전거 이용자 등 정의된 도로 이용자의 위치를 표시하세요. 보이는 경계와 관련 객체 속성을 기록합니다.
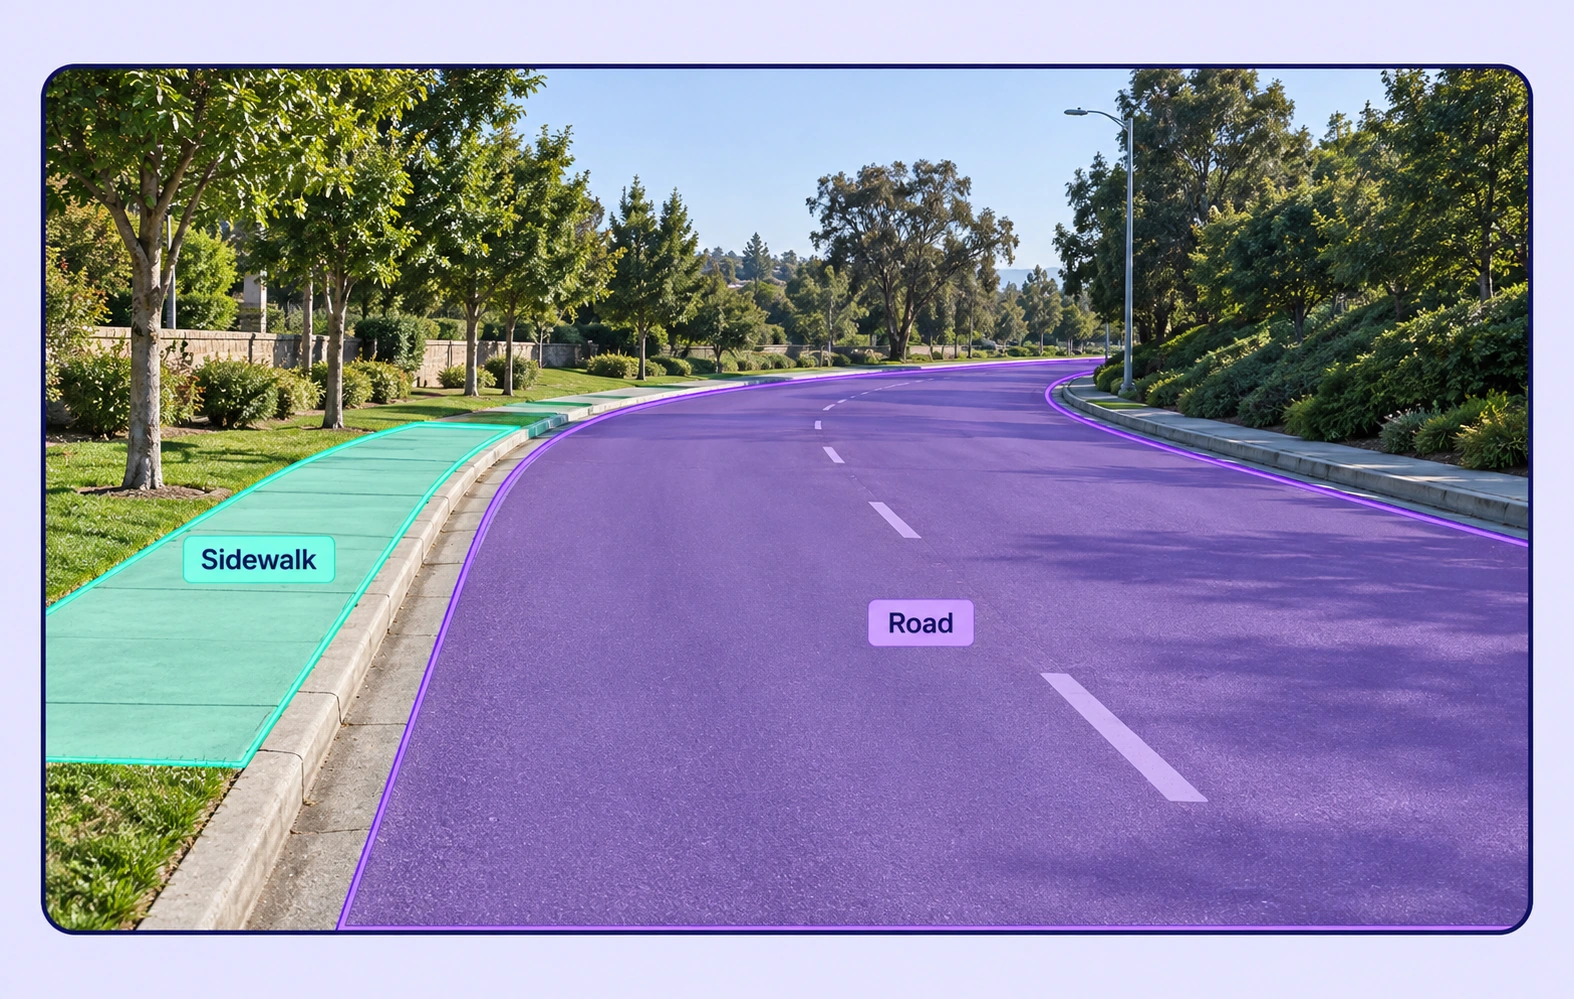
Drivable-Area Segmentation annotation example showing the source data and task-specific labels.

주행 가능 영역 분할

클래스별 폴리곤이나 마스크로 도로, 보도, 기타 장면 영역을 라벨링하세요. 교차로, 연석, 일부 가려진 경계에도 명확한 규칙을 적용합니다.
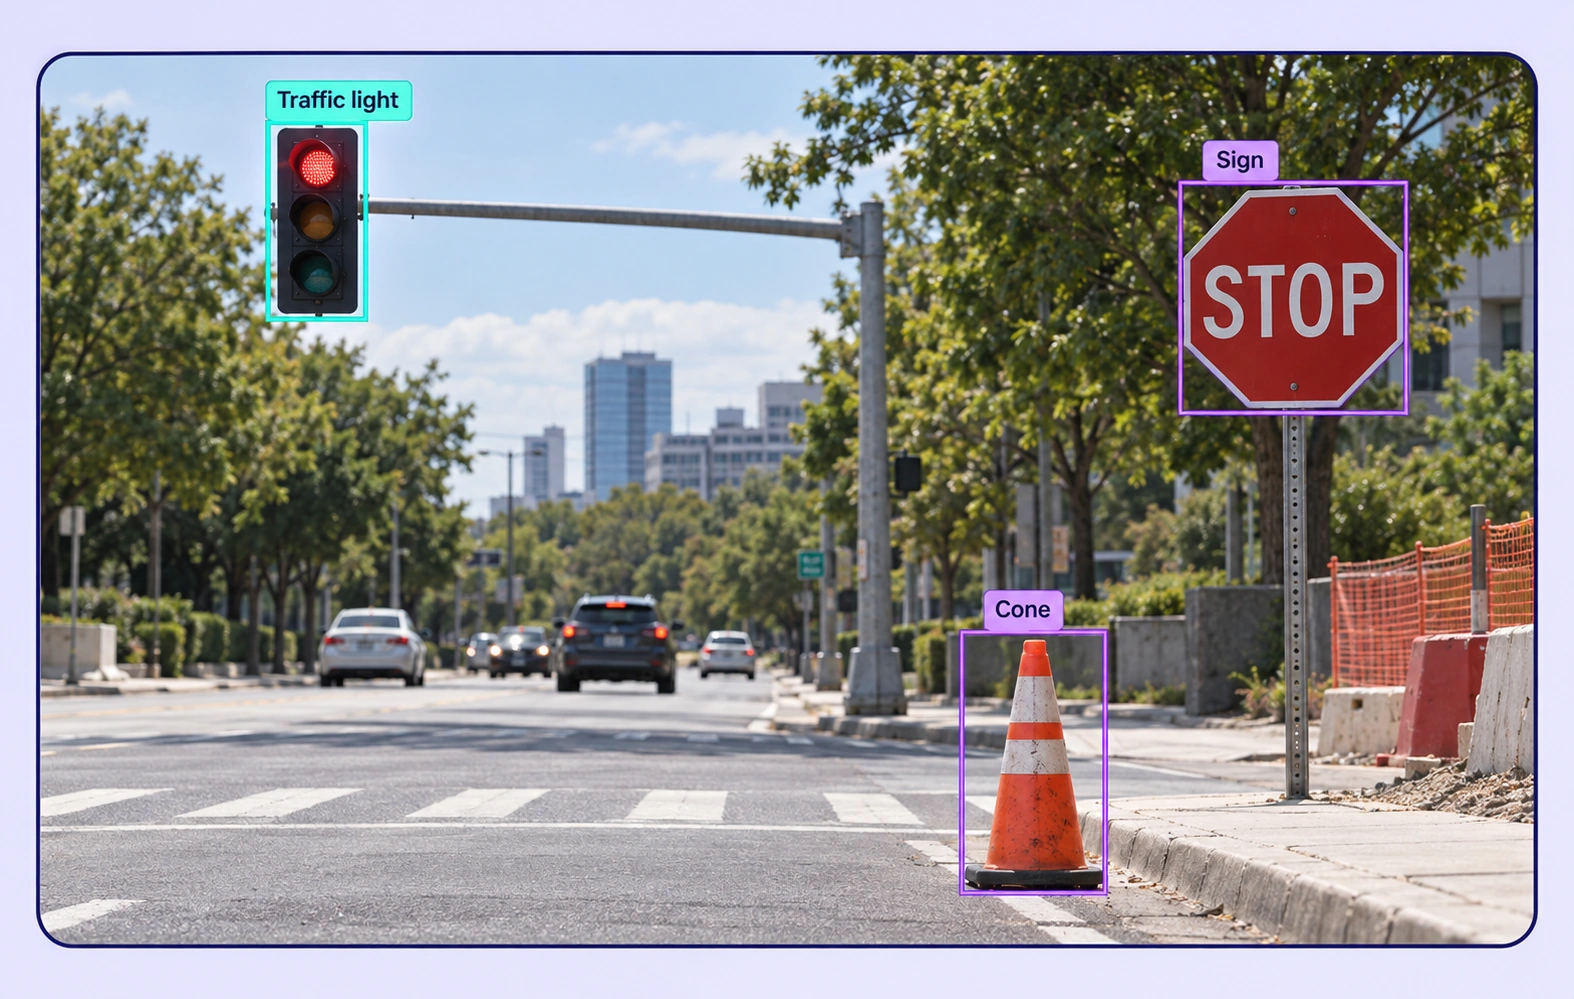
Roadside Object Recognition annotation example showing the source data and task-specific labels.

도로변 객체 인식

표지판, 신호등, 공사장 콘 등 관련 도로변 객체를 어노테이션하세요. 공유 라벨링 규칙에 따라 작거나 일부만 보이는 인스턴스도 포함합니다.
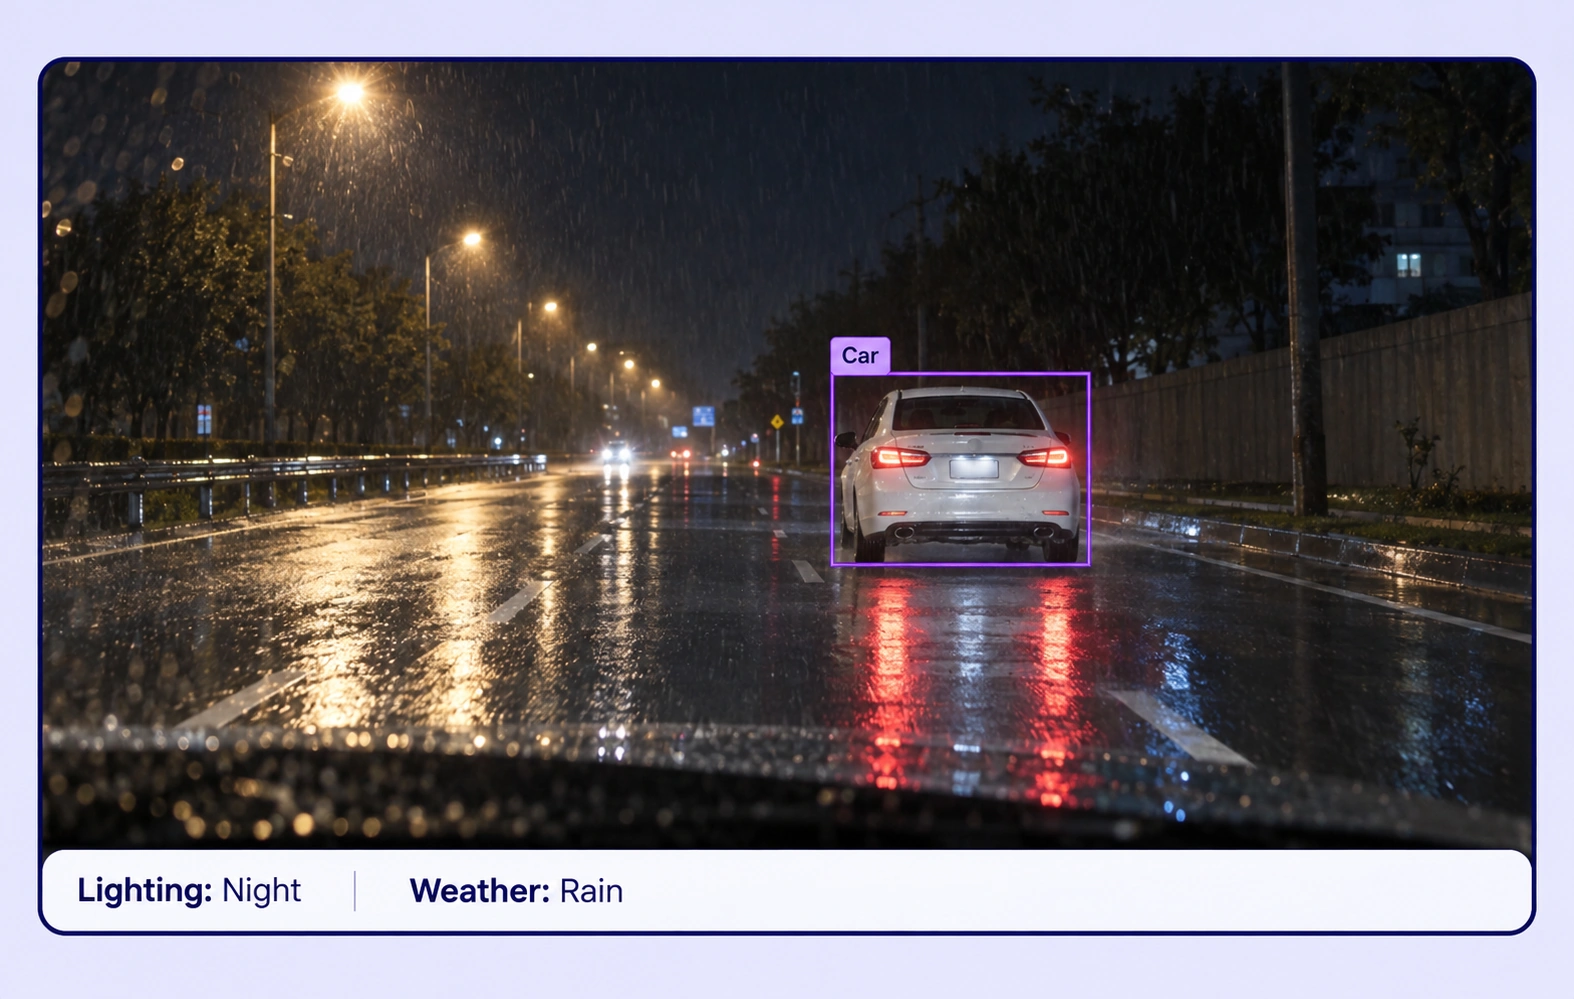
Challenging Scene Classification annotation example showing the source data and task-specific labels.

까다로운 장면 분류

구조화된 이미지 속성으로 조명, 날씨, 도로 환경, 시야 상태를 설명하세요. 중요한 운행 조건 전반의 인지 성능을 평가할 예제를 선별합니다.

AI 팀이 Unitlab을 선택하는 이유

카메라 기반 인지 데이터셋을 위한 이미지 데이터 준비, 일관된 라벨, 전문가 검토를 하나의 워크플로로 통합하세요.
15X
더 빠른 이미지 어노테이션
60%
AI 엔지니어의 시간 절약
5X
AI 개발 비용 절감

자율주행 인지를 위한 어노테이션 방법

의도한 모델 출력에 맞는 라벨 구조를 선택하세요. 도형, 시간 정보, 속성을 원본 이미지 데이터에 근거해 기록합니다.
Road-User Detection annotation example showing the source data and task-specific labels.

도로 이용자 바운딩 박스

눈에 보이는 도로 이용자에 밀착된 2D 박스를 그리고 합의된 가림 또는 가시성 속성을 기록하세요. 데이터셋 전체에 같은 객체 정의를 사용합니다.

도로 및 장면 분할

폴리곤, 마스크, 지원되는 선 도형으로 카메라에 보이는 장면을 라벨링하세요. 복잡한 경계는 원본 이미지와 대조해 검토합니다.

Drivable-Area Segmentation annotation example showing the source data and task-specific labels.

자율주행 인지 FAQ

카메라 인지 데이터 어노테이션이란 무엇인가요?

객체 탐지, 의미 분할, 장면 이해를 위해 카메라 이미지에 2D 라벨을 준비하는 작업입니다. Unitlab은 팀이 이러한 학습 예제를 선별하고 어노테이션하며 검토하도록 지원합니다.

어떤 도로 객체를 라벨링할 수 있나요?

온톨로지에 차량, 보행자, 자전거 이용자, 교통 표지판, 신호등, 공사 관련 객체, 장면 영역을 포함할 수 있습니다. 의도한 인지 작업에 맞는 클래스를 선택하세요.

가려지거나 작은 객체도 어노테이션할 수 있나요?

네. 어노테이터는 도형을 조정하고 구조화된 가시성 또는 가림 속성을 기록할 수 있습니다. 작업 전에 경계를 보이는 부분에 맞출지 다른 합의된 규칙을 따를지 정의하세요.

이 페이지는 카메라 이미지와 LiDAR 중 무엇을 다루나요?

이 워크플로는 2D 카메라 이미지와 지원되는 도형을 다룹니다. 명확한 클래스, 경계, 장면 속성이 있는 이미지 기반 인지 데이터셋을 준비할 수 있습니다.

정지 이미지와 교통 영상 데이터셋은 어떻게 다른가요?

정지 이미지 라벨은 한 프레임의 객체와 영역을 설명합니다. 시간에 따른 움직임을 이해해야 하는 모델에는 교통 영상 어노테이션으로 지속적인 트랙과 변화하는 프레임별 속성을 추가합니다.

카메라 기반 인지 라벨의 일관성을 어떻게 유지하나요?

작업 전에 공유 클래스, 구조화된 속성, 명확한 라벨링 지침을 정의하세요. 대표 예제와 맥락을 고려한 검토로 카메라 기반 인지 데이터셋의 의견 차이를 해결합니다.

불확실한 예제를 검토하고 수정할 수 있나요?

네. 이미지 어노테이션을 검토 및 재작업 단계로 보내세요. 검토자는 원본 데이터를 확인하고 라벨을 수정하며 추가 작업이 필요한 항목을 돌려보낼 수 있습니다.

어노테이션 전에 이미지 데이터를 큐레이션할 수 있나요?

네. 데이터셋 검색, 메타데이터, 태그, 사용 가능한 필터로 관련 이미지 자산을 선택하세요. 준비 워크플로에서 대표 조건과 어려운 예제를 확인할 수 있도록 유지합니다.

검토된 어노테이션을 모델 파이프라인에 어떻게 전달하나요?

라벨 유형에 적합한 지원 형식으로 검토된 이미지 어노테이션을 내보내세요. 데이터셋 버전으로 준비된 예제 중 어떤 항목이 학습 또는 평가 릴리스에 포함되는지 확인할 수 있습니다.
카메라 기반 인지 학습 데이터 준비에 도움이 필요하신가요?Unitlab에 문의하기