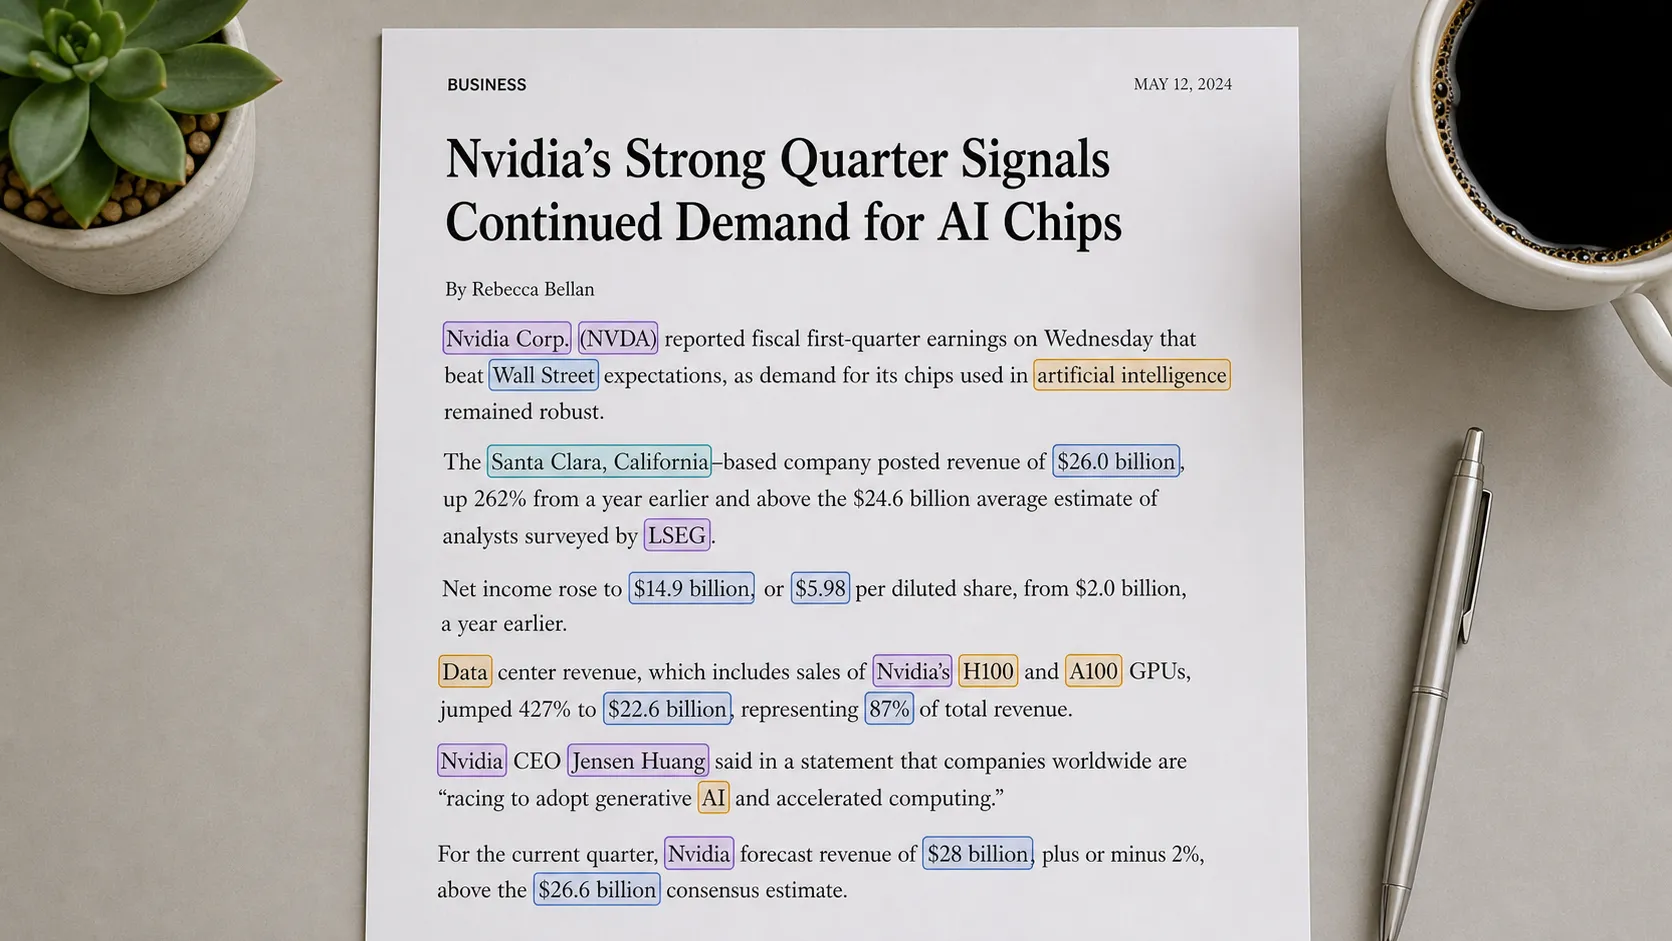
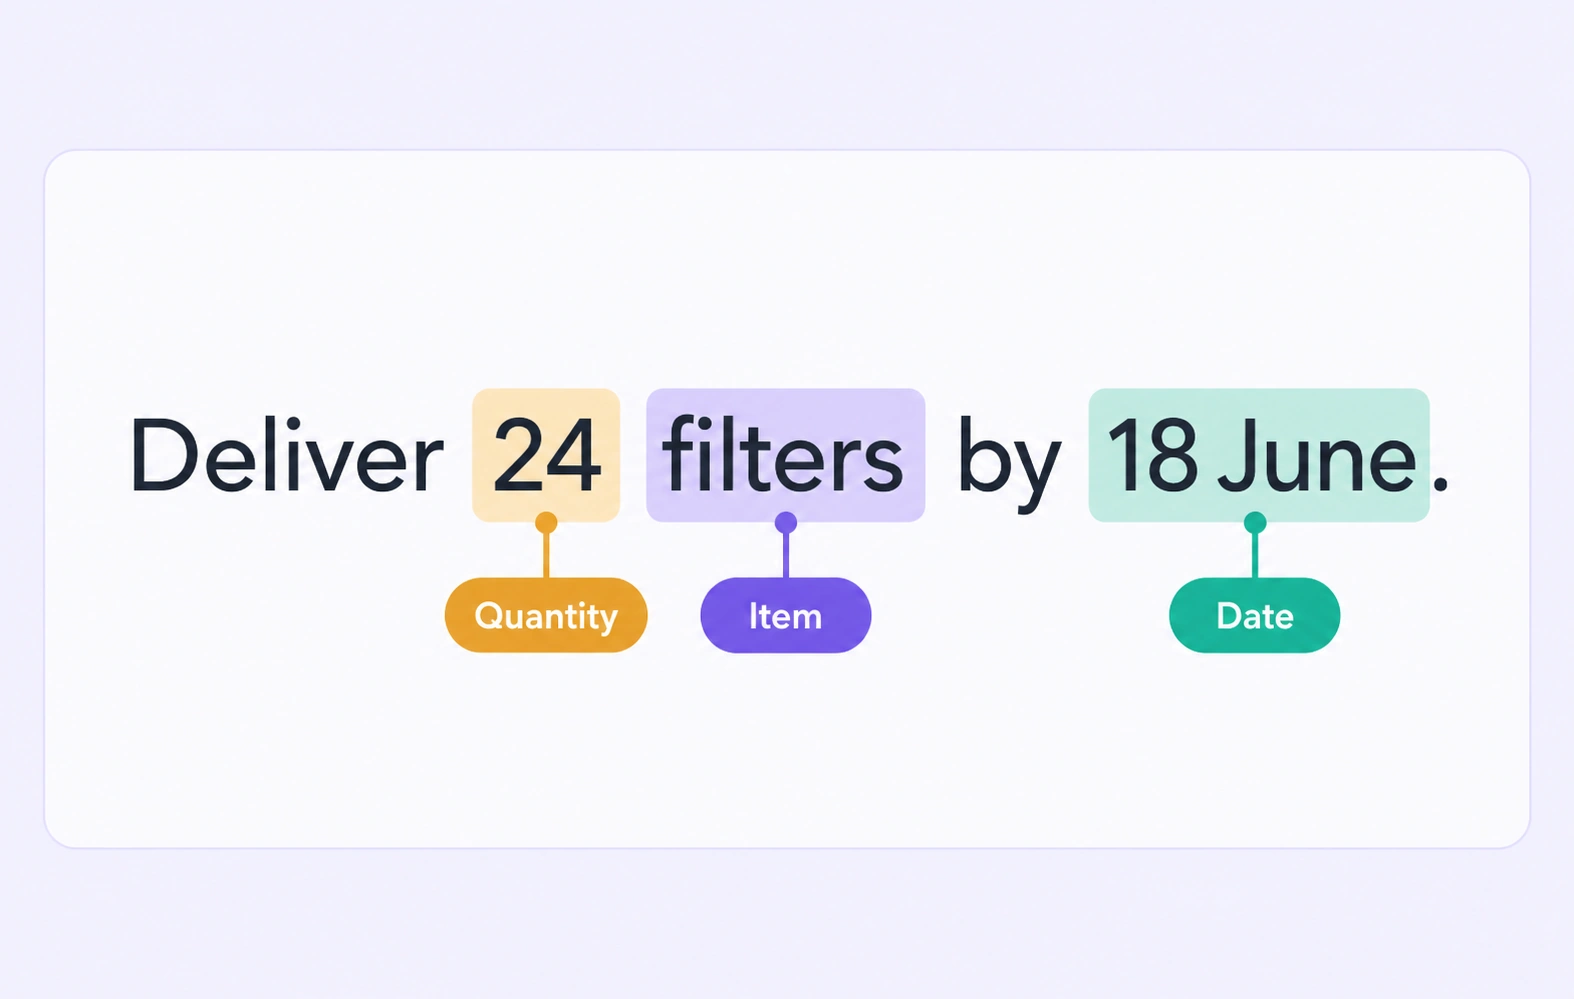
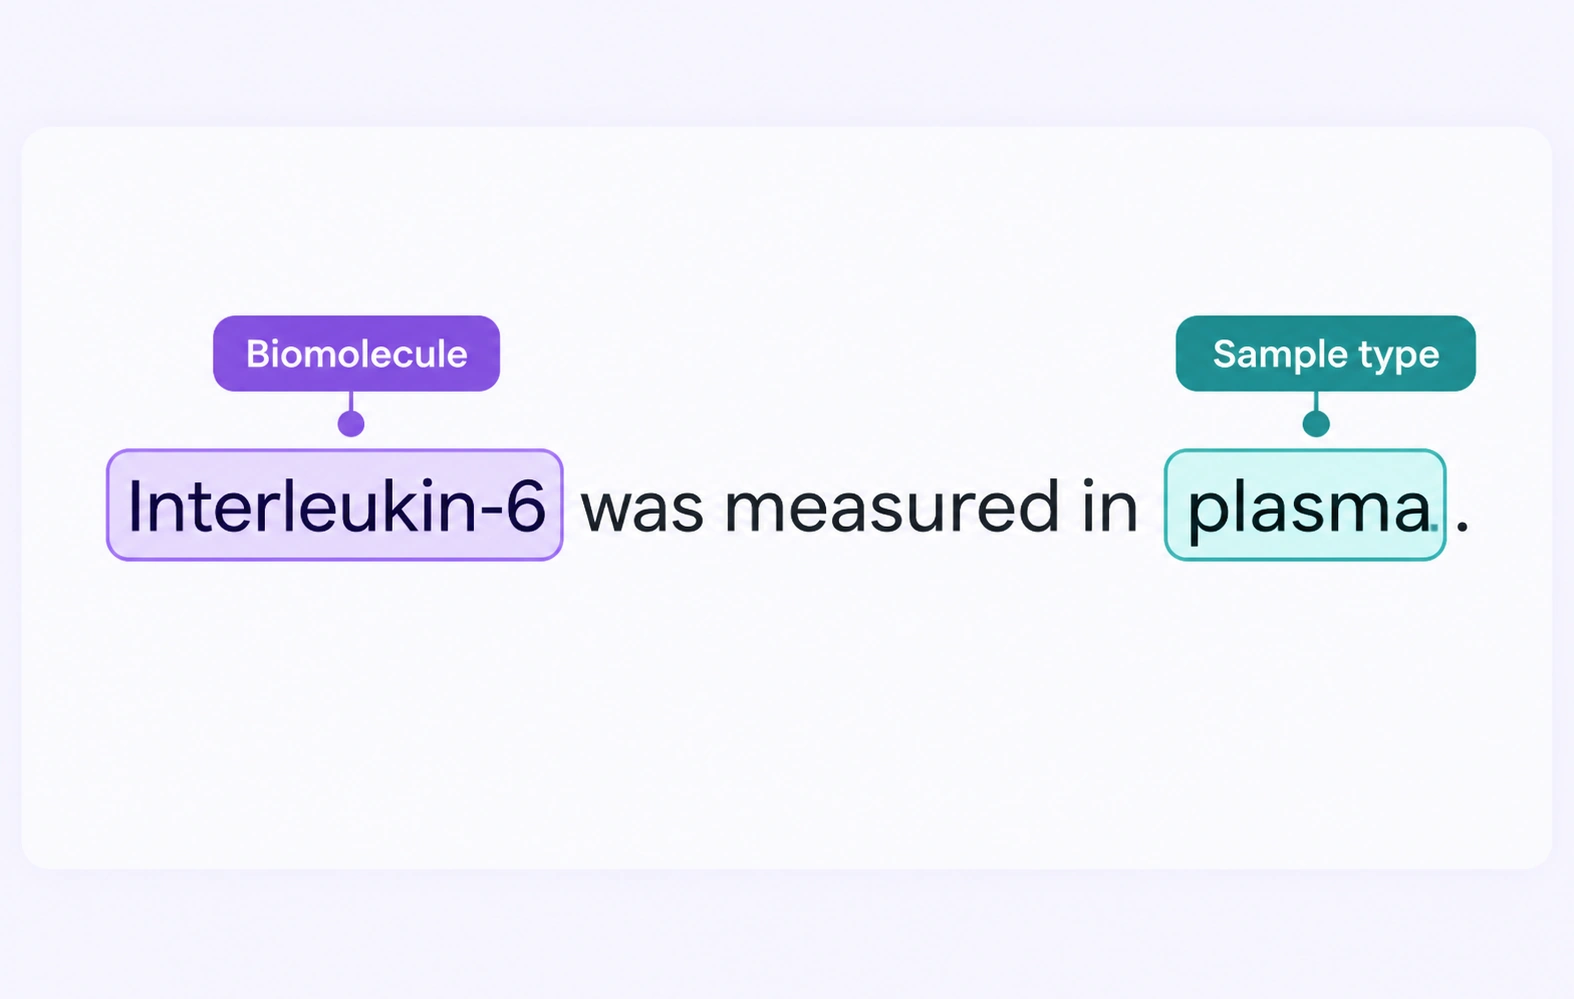
개체를 구성하는 정확한 문자를 선택하고 클래스를 지정하며 원본 텍스트의 맥락을 유지합니다.
온톨로지에 정의된 선택 항목으로 개체 하위 유형이나 어노테이션 확실성 등 구조화된 속성을 추가합니다.
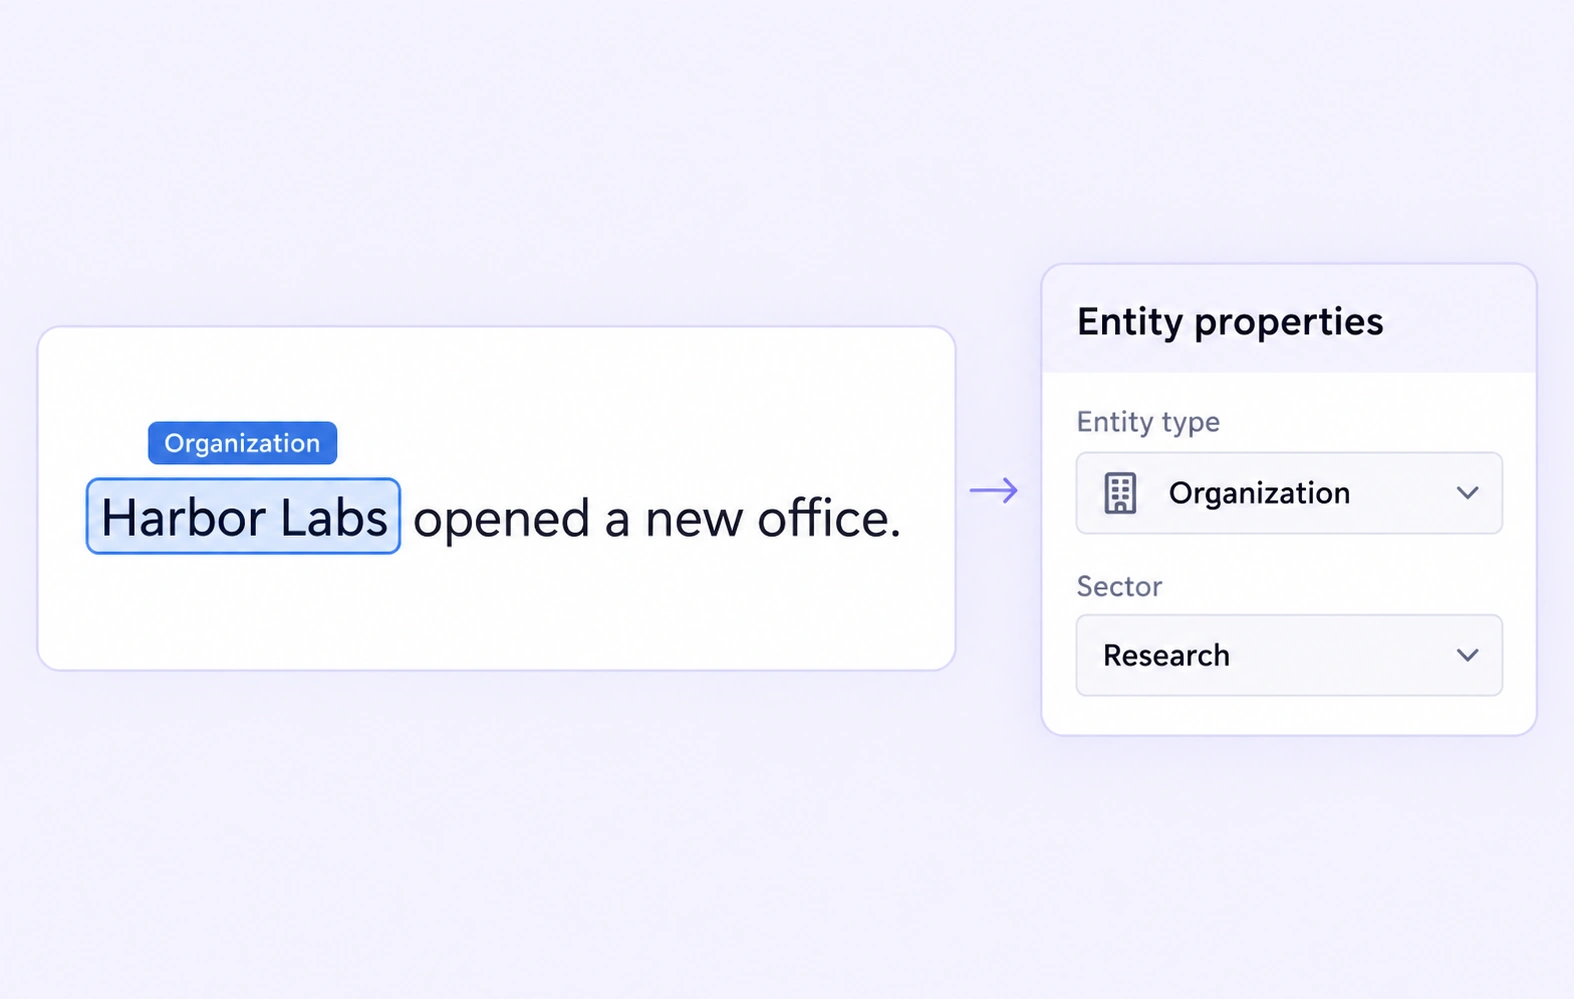
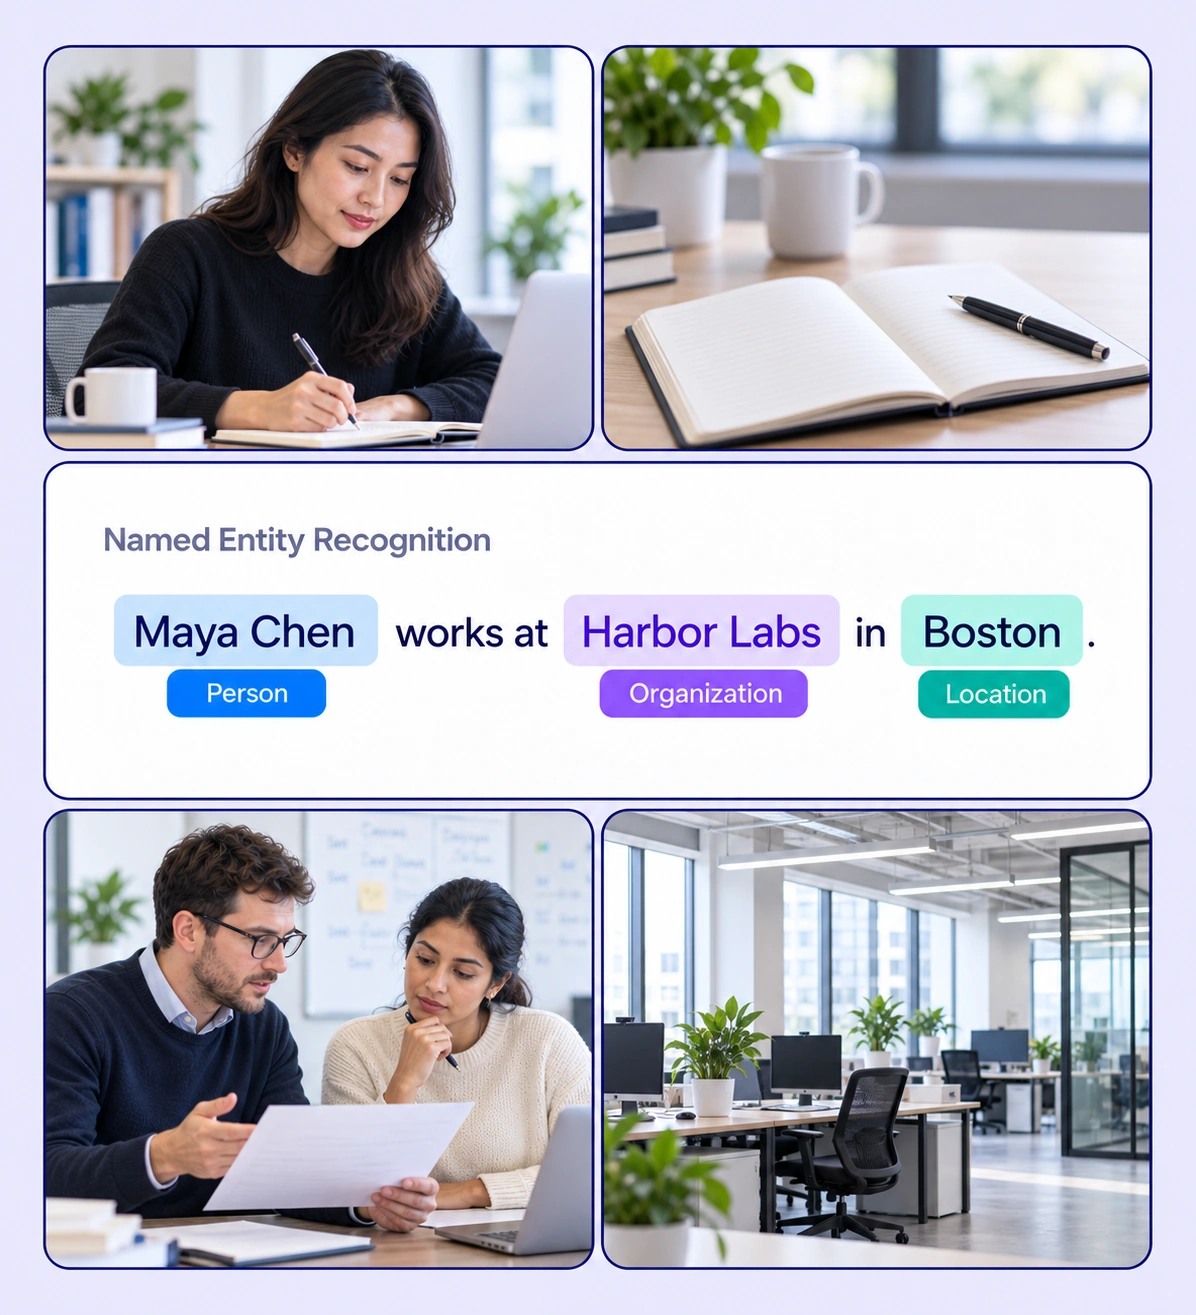
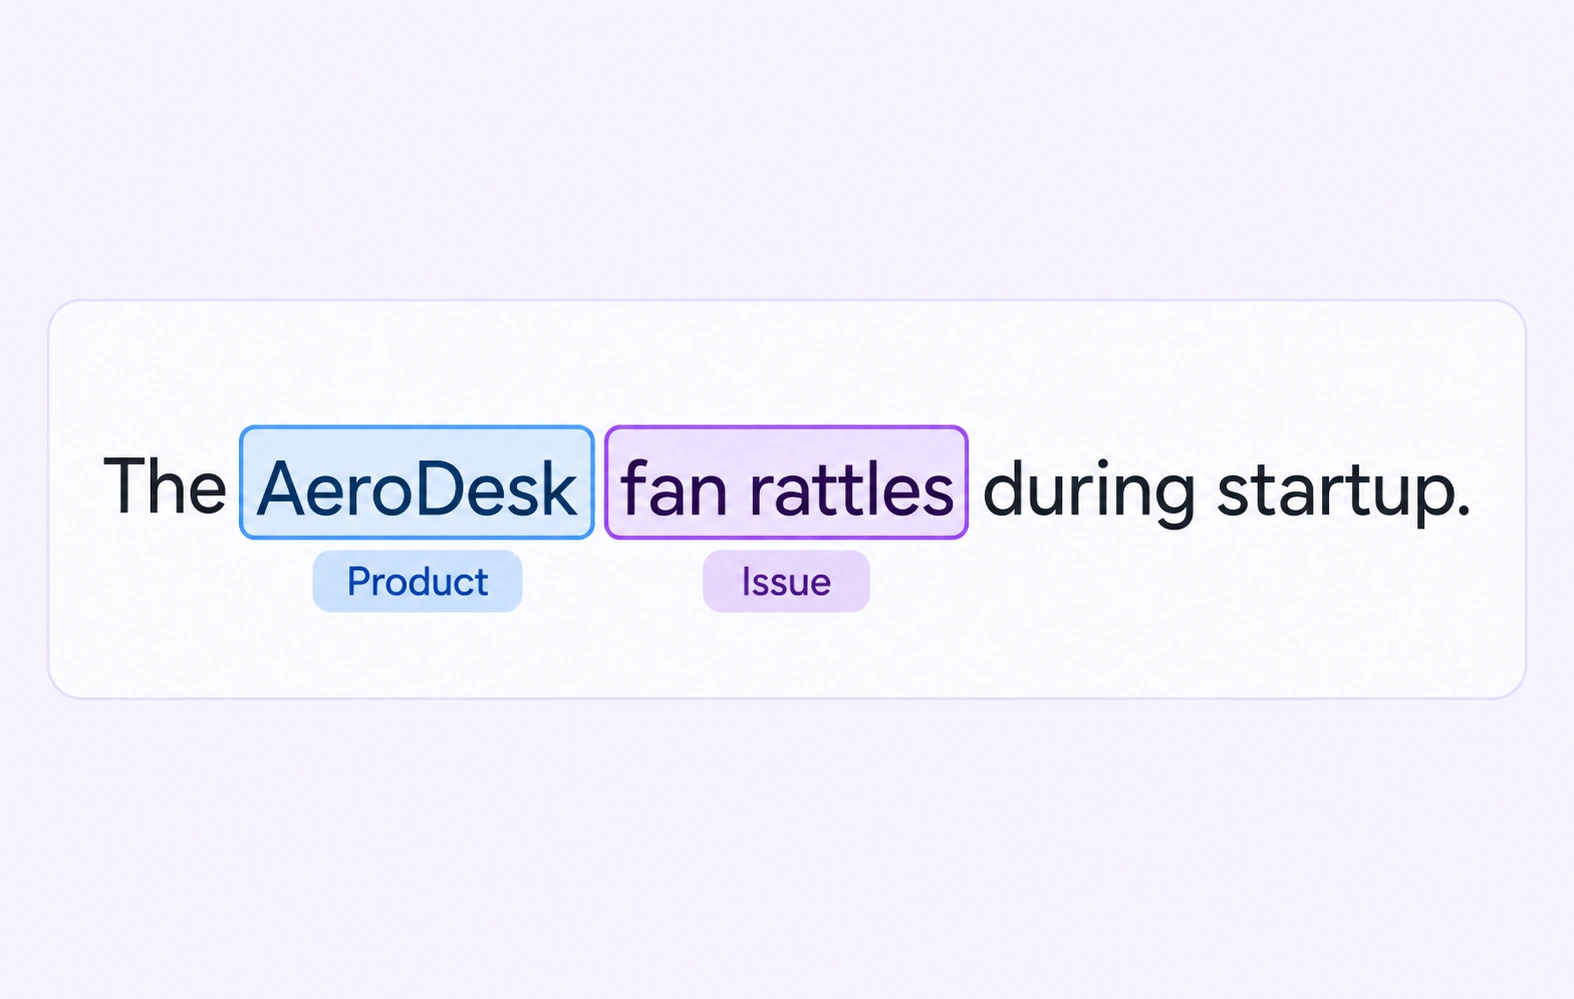
NER 어노테이션은 텍스트에서 이름이 있는 개체나 도메인별 개체를 표시해 모델이 어떤 문자가 인물, 조직, 장소, 제품 또는 정의된 개념을 가리키는지 학습하도록 합니다.
네. 전문 제품, 과학, 비즈니스 용어 등 작업에 중요한 개체의 클래스를 만드세요. 속성으로 추가 맥락을 기록할 수 있습니다.
어노테이터는 문장 전체에만 라벨을 붙이는 것이 아니라 구체적인 텍스트 구간을 선택합니다. 선택된 문자와 개체 클래스가 어노테이션에 저장됩니다.
네. 온톨로지와 지침에서 맥락에 따른 클래스 결정 기준을 정의합니다. 개체 언급이 모호하면 검토자가 주변 문장을 확인할 수 있습니다.
네. 지원되는 개체 관계로 텍스트 안의 라벨링된 언급을 연결해 개체 인식 데이터셋에 정보 추출 작업에 필요한 연결을 추가할 수 있습니다.
라벨링 지침에 예제를 정의하고 검토 과정에서 어려운 사례를 논의하세요. 릴리스를 만들기 전에 데이터셋 전체에 같은 경계 규칙을 적용합니다.
기본 언어 어노테이션에는 일반 텍스트 파일을 사용합니다. 팀이 라벨링할 텍스트와 작업에 맞춰 개체 클래스, 관계, 항목 속성을 정의하세요.
어노테이션된 텍스트를 검토 단계로 보내 맥락 안에서 댓글과 수정 사항을 해결합니다. 데이터셋을 릴리스하기 전에 구성된 합의 평가나 승인된 기준 데이터로 일관성을 확인합니다.
네. 텍스트는 JSONL과 Unitlab 통합 내보내기 형식을 지원합니다. 학습 파이프라인에 필요한 개체, 관계, 속성을 보존하는 내보내기 형식을 선택하세요.