음성 인식을 위한 검토된 오디오 학습 데이터

정확한 전사, 명확한 구간 경계, 녹음 맥락을 갖춘 시간 정렬 음성 데이터셋을 구축하세요. ASR 모델용 라벨링 예제를 내보내기 전에 원본 오디오와 전사 내용을 대조해 검토합니다.
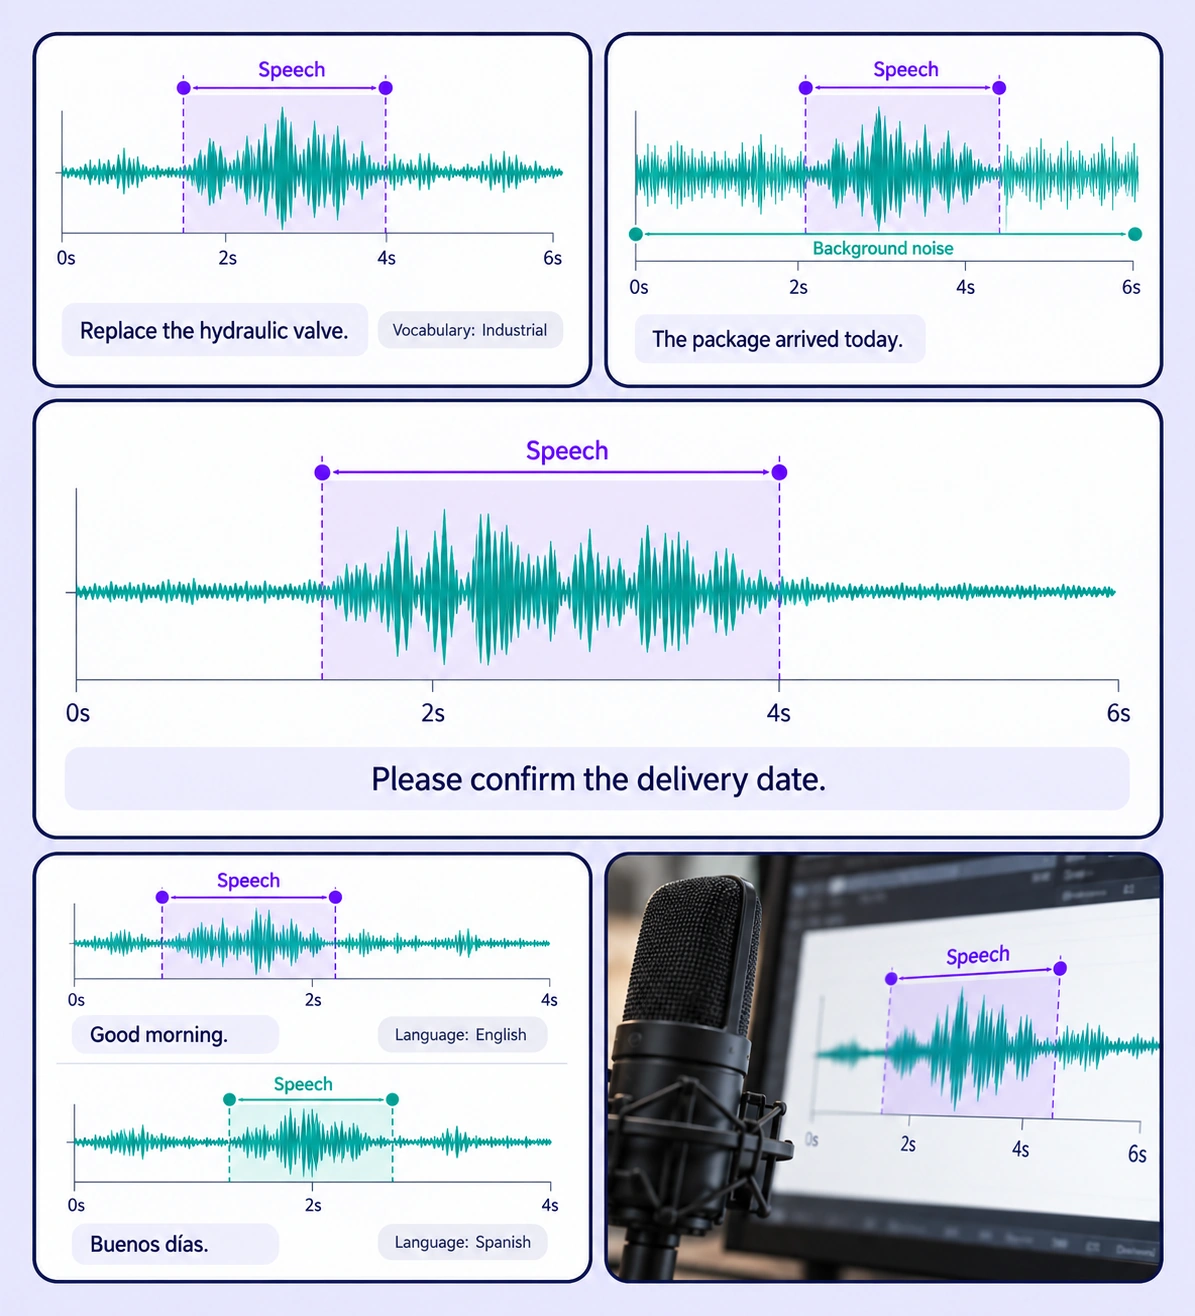
Annotated speech recognition and transcription examples arranged in a five-panel collage.

음성 인식 및 전사를 위한 데이터 어노테이션

모델이 학습해야 하는 음성 인식 작업에 맞춰 라벨링 예제를 준비하세요. 각 활용 사례에서 원본 데이터, 어노테이션 규칙, 검토된 라벨의 연결을 유지합니다.
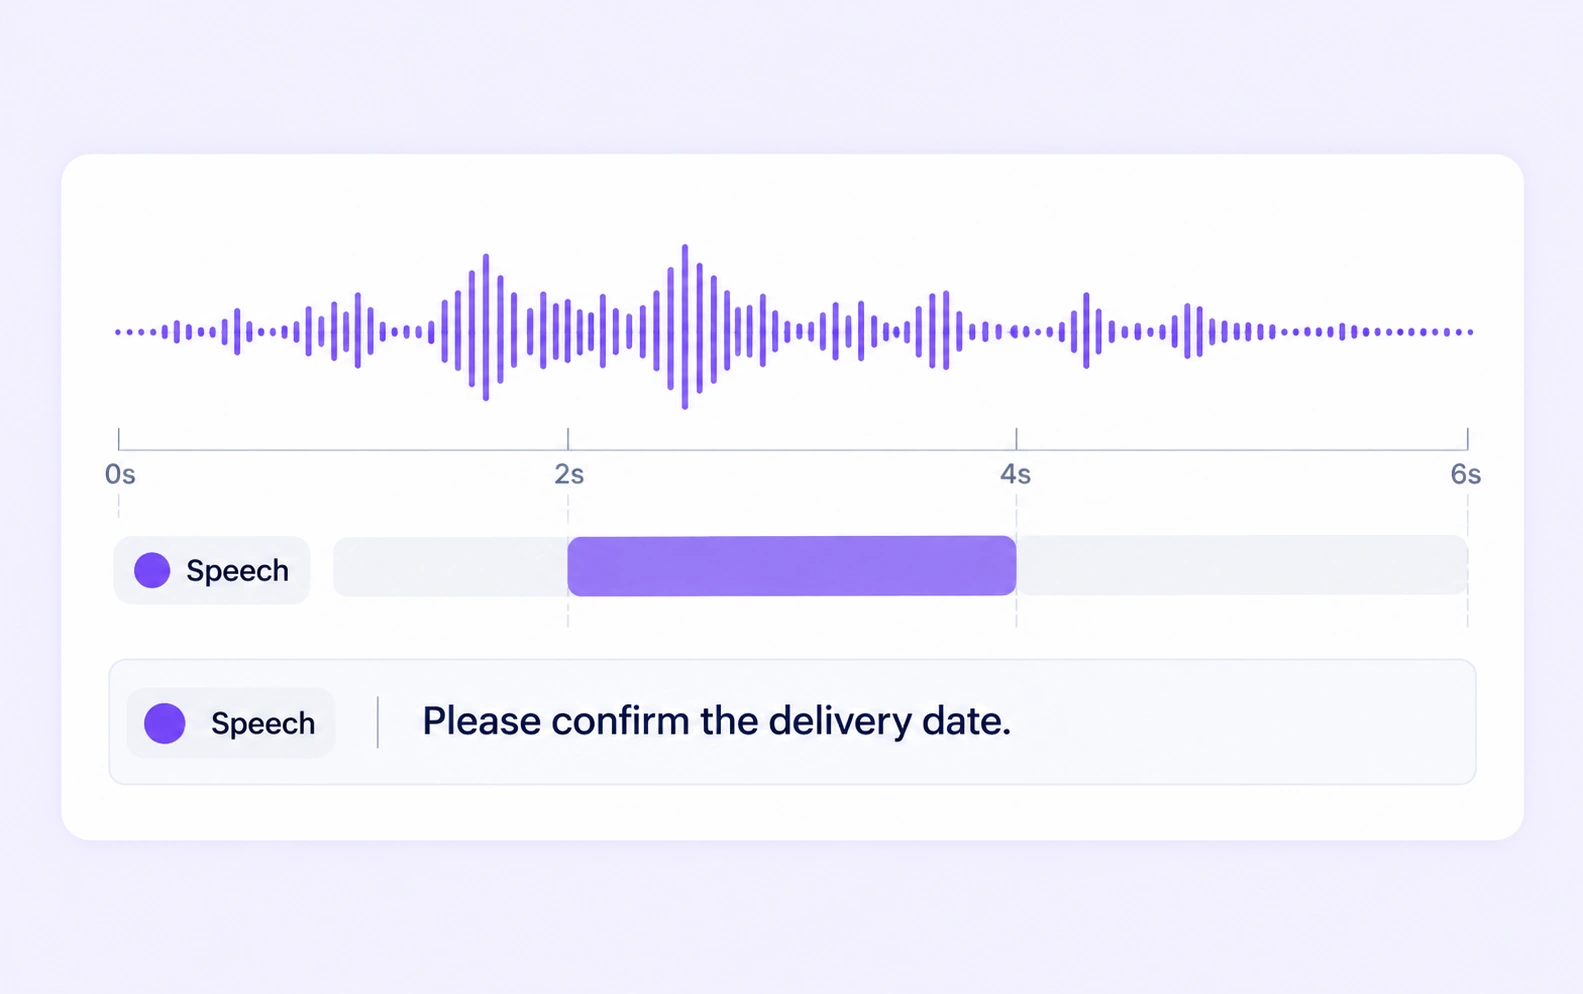
A speech interval and its transcript align with a single source waveform.

대화 음성 전사

통화, 인터뷰, 대화 녹음의 자연스러운 발화를 전사합니다. 텍스트를 올바른 오디오 구간에 연결하고 미완성 발화나 중간에 끊긴 문장을 검토합니다.
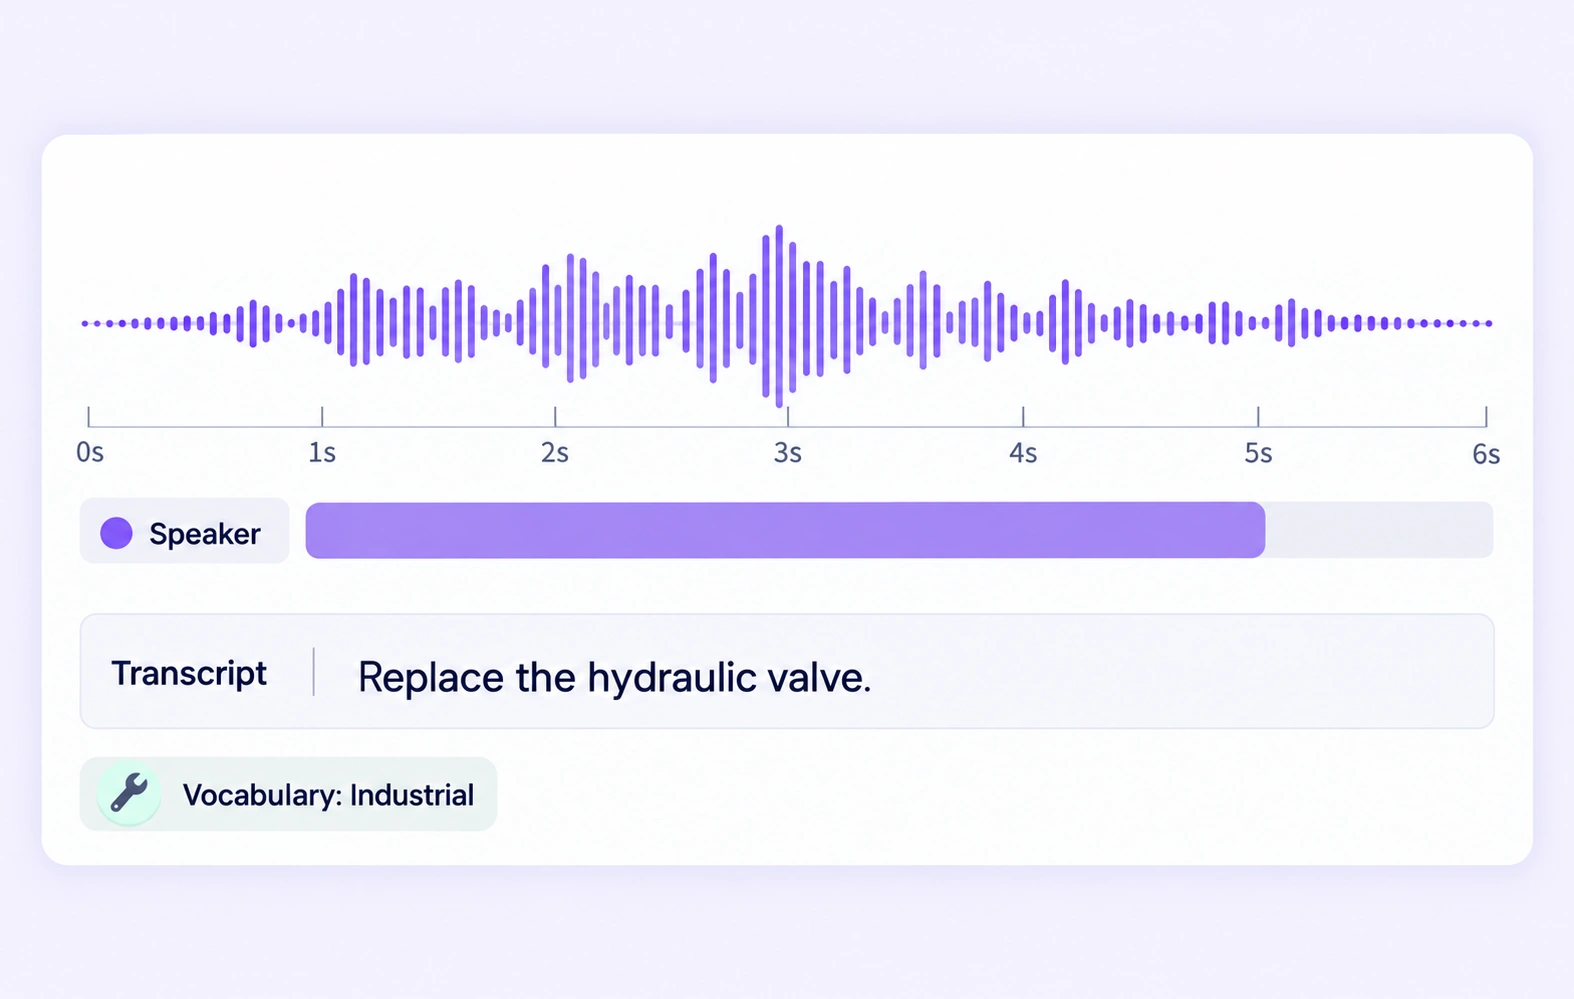
An industrial vocabulary transcript accompanies an annotated speech interval.

도메인 어휘 데이터셋

전문 용어, 제품명, 작업별 표현에 대한 전사본을 작성하고 검토합니다. 익숙하지 않은 용어에는 합의된 전사 규칙을 적용합니다.
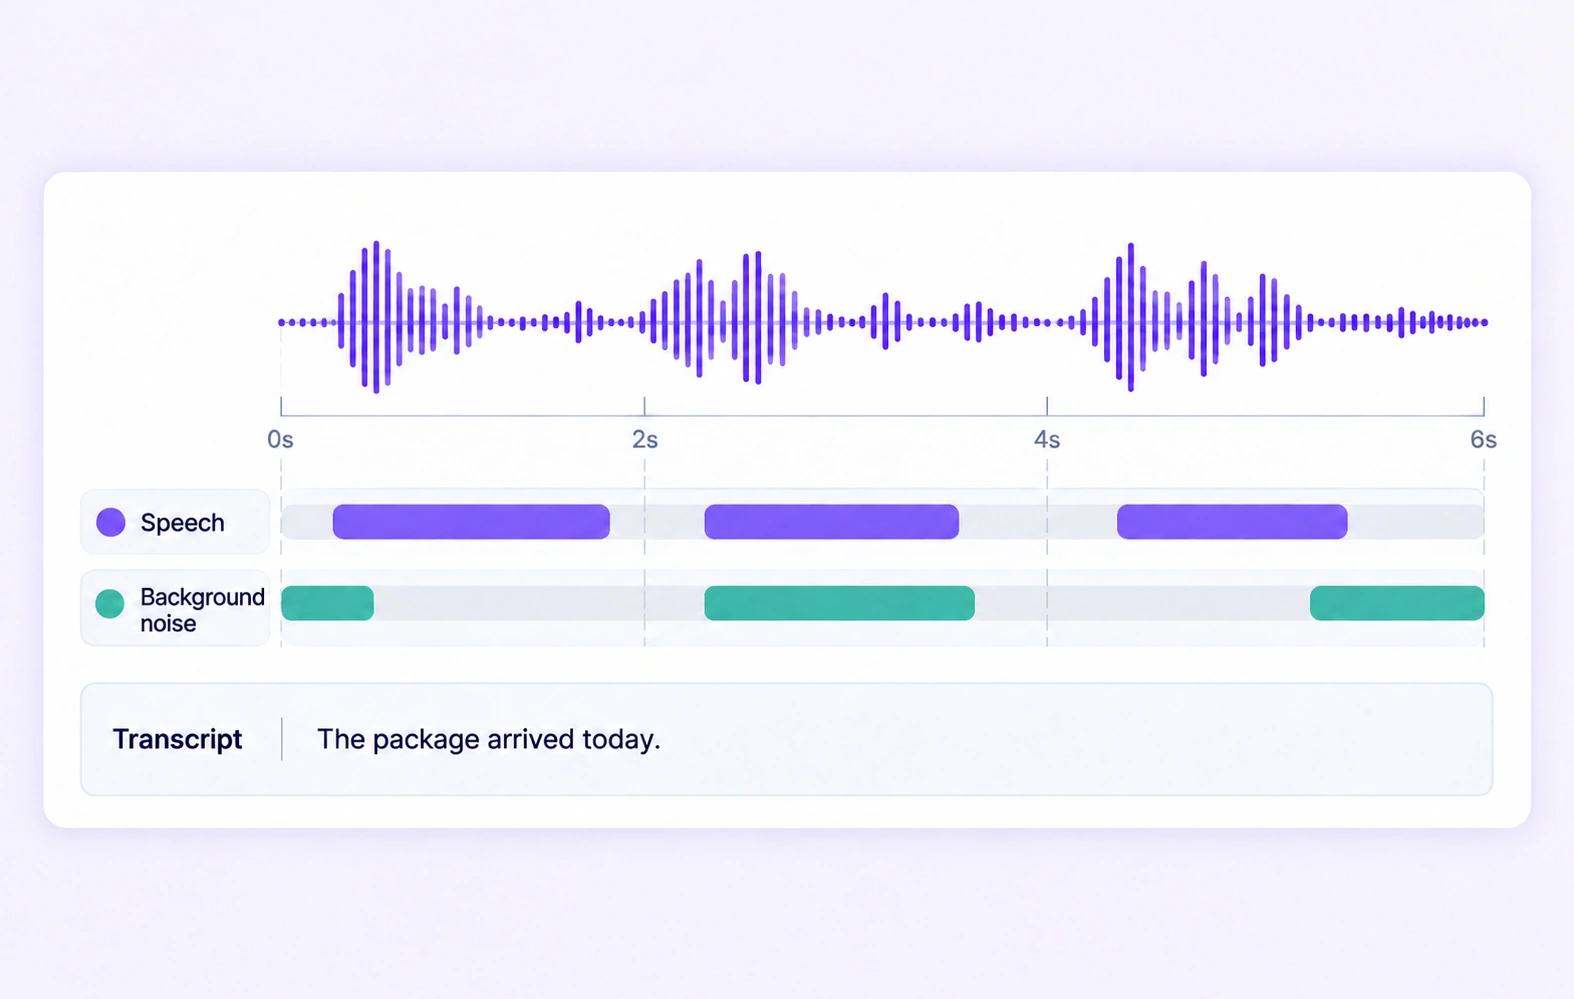
Speech and background-noise intervals share one source waveform and transcript.

소음 환경의 음성

식별 가능한 음성을 라벨링하고 정의된 소음 또는 품질 속성을 함께 기록합니다. 실제 음향 조건을 포함하고 불명확한 구간은 녹음과 대조해 검토합니다.
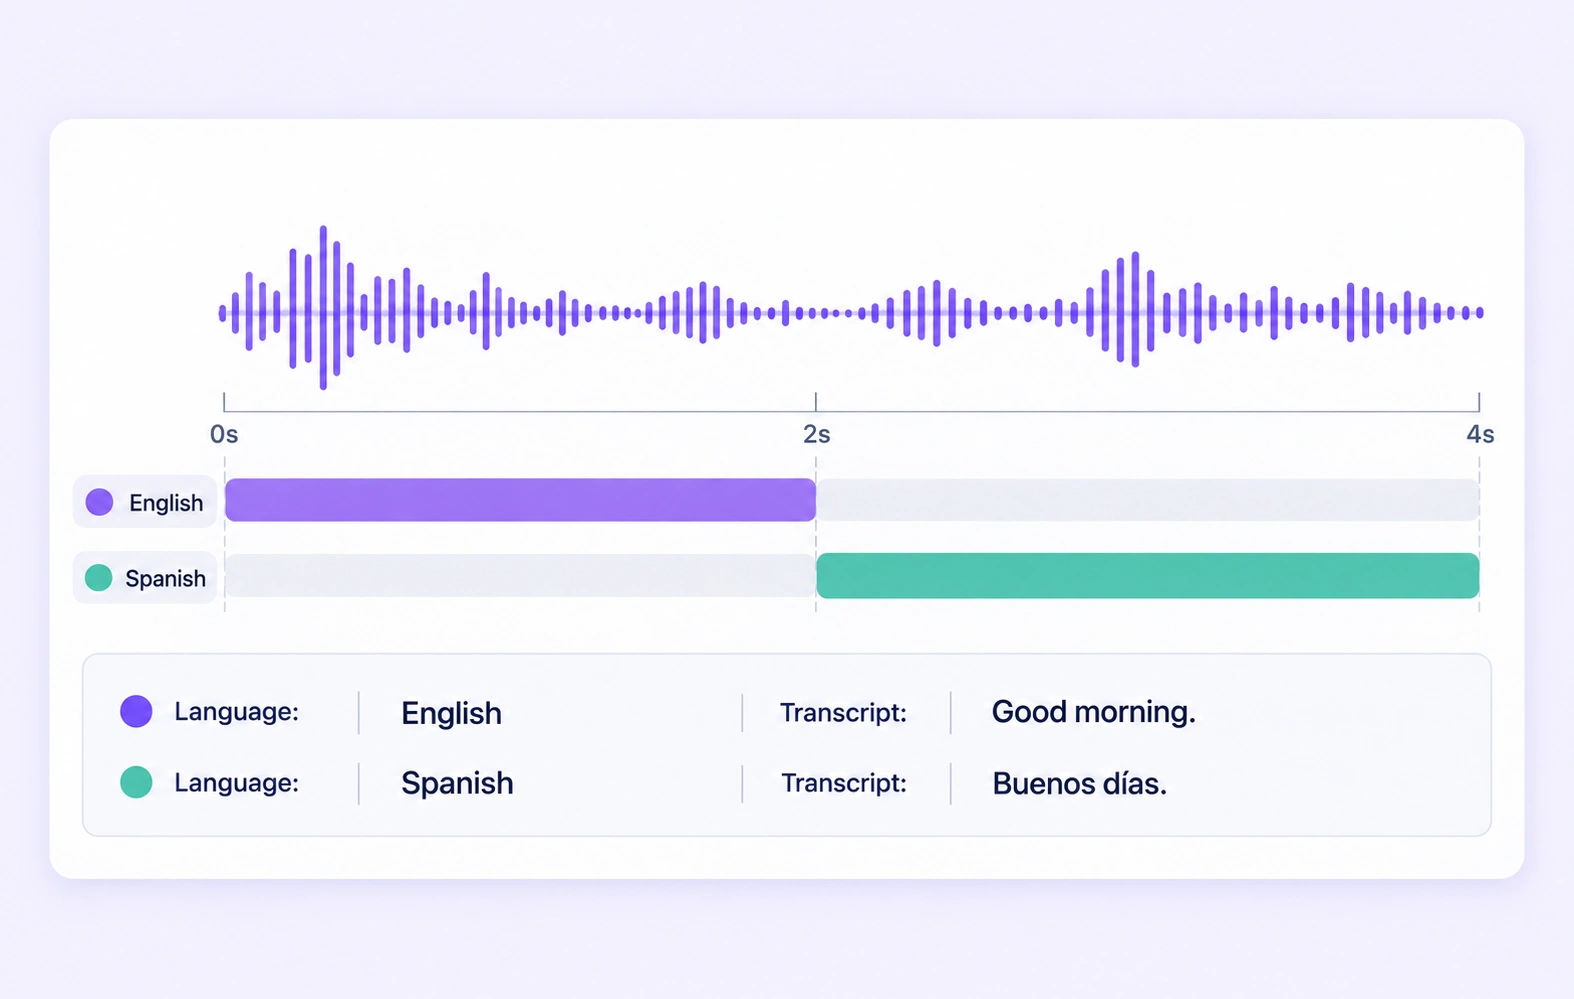
English and Spanish transcript segments align with one bilingual recording.

다국어 음성 코퍼스

해당 녹음에 맞는 언어별 전사본과 구조화된 언어 라벨을 준비합니다. 언어와 전사 정책을 이해하는 검토자에게 예제를 배정합니다.

AI 팀이 Unitlab을 선택하는 이유

음성 인식 데이터셋을 위한 오디오 데이터 준비, 일관된 라벨링, 전문가 검토를 하나의 워크플로로 연결합니다.
15X
더 빠른 오디오 어노테이션
60%
AI 엔지니어의 시간 확보
5X
AI 개발 비용 절감

음성 인식 및 전사의 어노테이션 방법

모델의 목표 출력에 맞는 라벨 구조를 선택하세요. 도형, 시간 정보, 속성은 원본 오디오 데이터를 근거로 작성합니다.
A speech interval and its transcript align with a single source waveform.

음성 구간과 전사

파형에서 음성 구간을 정의하고 전사 텍스트를 어노테이션 속성으로 입력합니다. 실제 녹음을 확인하며 시작점과 끝점을 세밀하게 조정합니다.

녹음 맥락과 품질

언어, 음향 조건, 전사의 불확실성을 구조화된 속성으로 기록합니다. 원본 오디오와 데이터셋 정책에 근거해 라벨을 작성합니다.

Speech and background-noise intervals share one source waveform and transcript.

음성 인식 및 전사 FAQ

ASR 학습 데이터 어노테이션이란 무엇인가요?

오디오 구간마다 발화 내용과 필요한 맥락 라벨을 준비하는 작업입니다. Unitlab은 시간 기반 오디오 어노테이션, 전사, 구조화된 속성, 검토 워크플로를 지원합니다.

전사 텍스트를 특정 오디오 구간에 정렬할 수 있나요?

네. 전사 텍스트를 시간 정보가 있는 음성 어노테이션에 연결할 수 있습니다. 어노테이터는 구간을 조정하고 해당 내용을 원본 녹음과 대조해 검토할 수 있습니다.

불명확한 음성은 어떻게 라벨링하나요?

알아들을 수 없거나 불확실한 음성에는 합의된 규칙을 적용하고 관련 품질 속성을 기록합니다. 검토자는 전사 결과를 승인하기 전에 오디오를 확인해야 합니다.

다국어 학습 데이터를 준비할 수 있나요?

네. 언어 속성을 정의하고 데이터셋에 포함된 언어별로 적절한 전사 지침을 적용하세요. 해당 예제를 검증할 전문성을 갖춘 검토자를 배정합니다.

전사와 화자 분리는 어떻게 다른가요?

전사는 무엇을 말했는지 기록합니다. 화자 분리는 각 시간 구간에 어떤 화자 라벨이 해당하는지 기록합니다. 후속 음성 작업에 필요하다면 하나의 데이터셋에 두 가지를 모두 포함할 수 있습니다.

팀은 음성 인식 라벨의 일관성을 어떻게 유지하나요?

작업 전에 공통 클래스, 구조화된 속성, 명확한 라벨링 지침을 정의합니다. 대표 예제와 맥락을 확인하는 검토를 통해 음성 인식 데이터셋의 의견 차이를 해결합니다.

불확실한 예제를 검토하고 수정할 수 있나요?

네. 오디오 어노테이션을 검토 및 재작업 단계로 전달합니다. 검토자는 원본 데이터를 확인하고 라벨을 수정하며, 추가 작업이 필요하면 항목을 돌려보낼 수 있습니다.

어노테이션 전에 오디오 데이터를 큐레이션할 수 있나요?

네. 데이터셋 검색, 메타데이터, 태그, 사용 가능한 필터로 관련 오디오 자산을 선택합니다. 준비 과정에서 대표적인 조건과 어려운 예제를 확인할 수 있도록 유지합니다.

검토된 어노테이션은 모델 파이프라인에 어떻게 전달하나요?

어노테이션 작업에 따라 지원되는 Audio JSON, RTTM 또는 UUEF 형식으로 검토된 오디오 라벨을 내보냅니다. 데이터셋 버전을 통해 팀은 준비된 예제 중 어떤 항목이 특정 릴리스에 포함되는지 확인할 수 있습니다.
음성 인식 학습 데이터 준비에 도움이 필요하신가요?Unitlab에 문의하기