面向语音识别的已审核音频训练数据

构建时间对齐的语音数据集,确保转写准确、片段边界清晰,并保留录音上下文。导出用于 ASR 模型的标注样本前,对照原始音频审核每段文字。
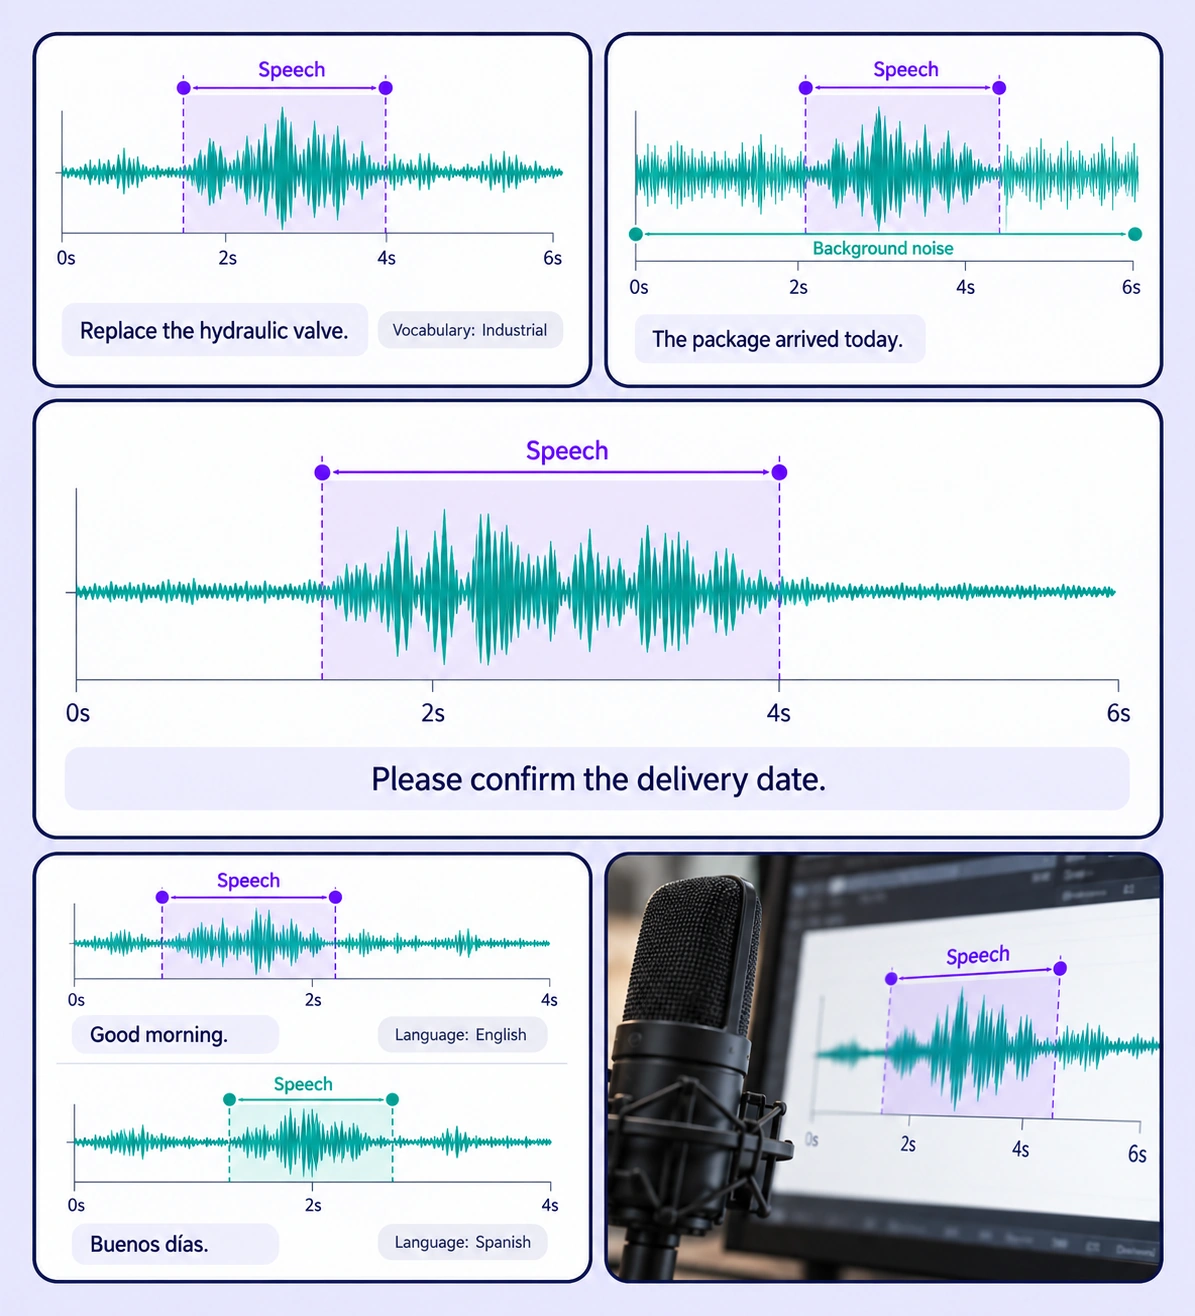
Annotated speech recognition and transcription examples arranged in a five-panel collage.

语音识别与转写数据标注

为模型需要学习的语音识别任务准备标注样本。在各类应用中,保持源数据、标注规则和已审核标签之间的关联。
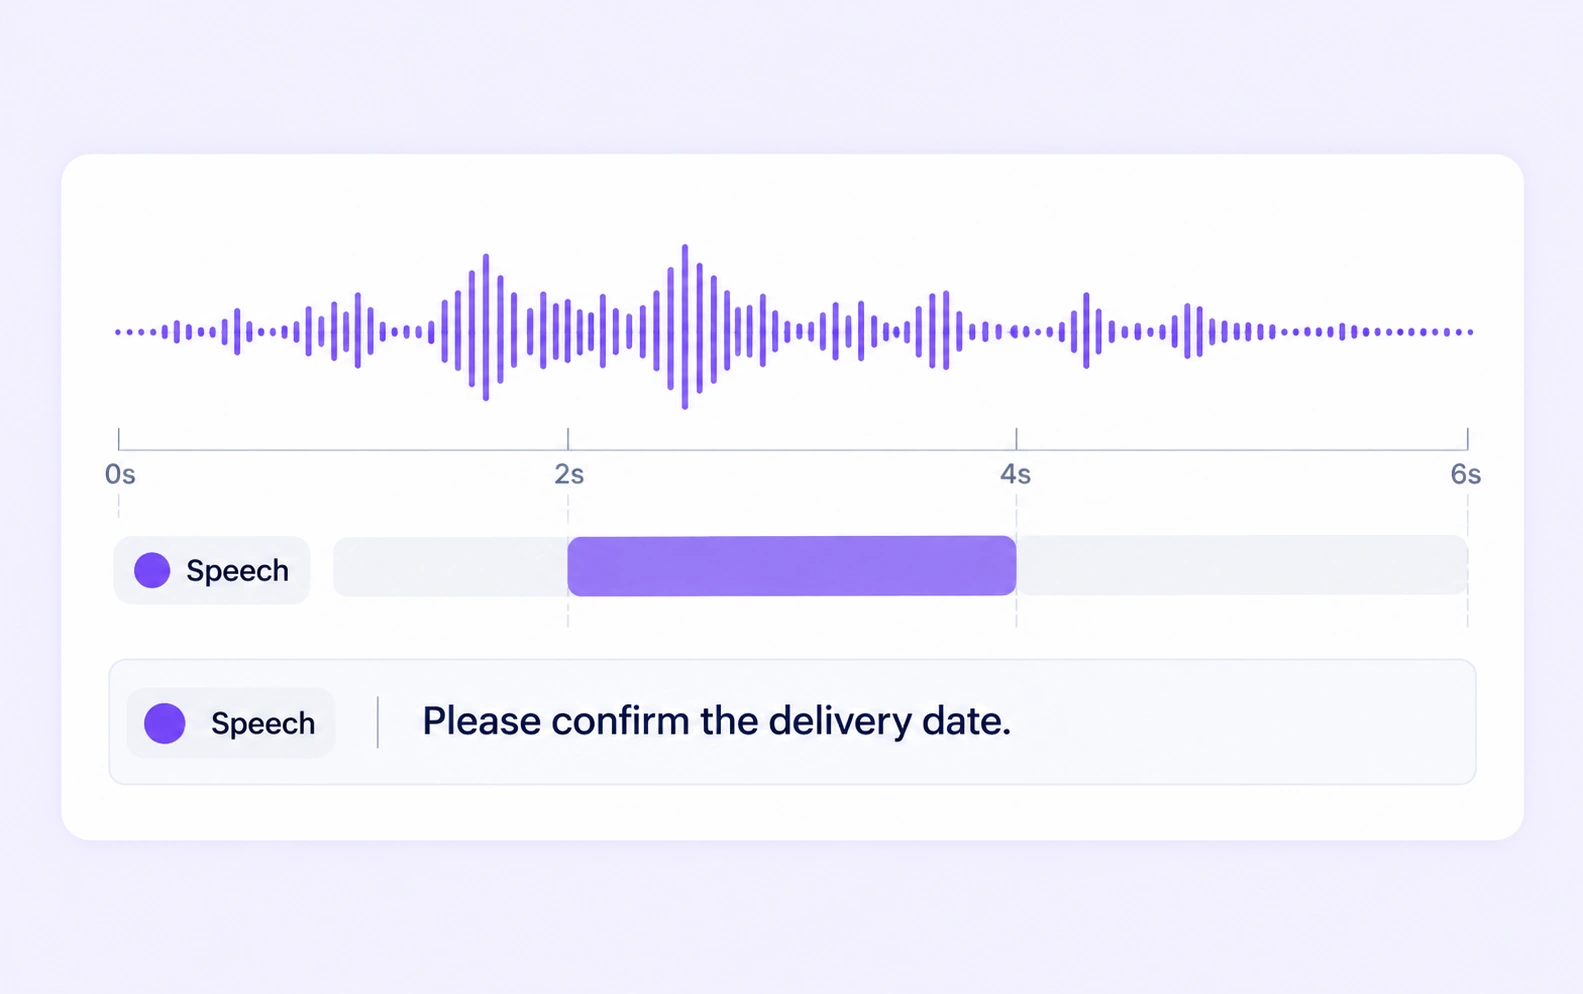
A speech interval and its transcript align with a single source waveform.

对话语音转写

转写通话、访谈和对话录音中的自然语音。将文字关联到正确的音频区间,并审核未说完或被打断的语句。
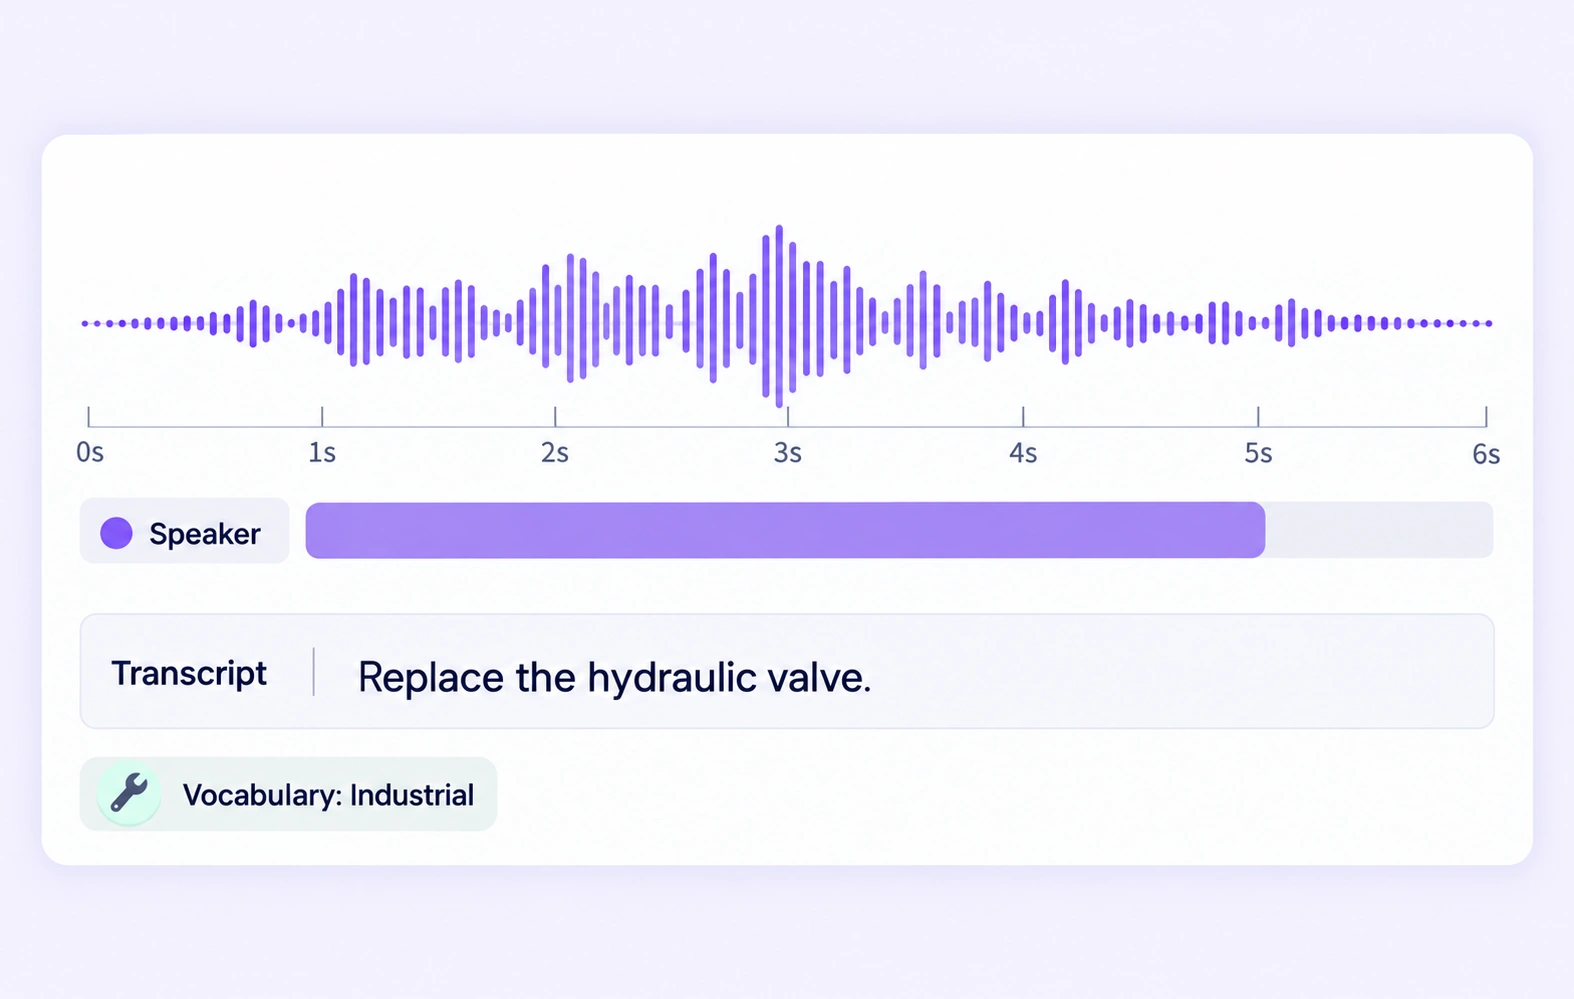
An industrial vocabulary transcript accompanies an annotated speech interval.

领域词汇数据集

为专业术语、产品名称和任务相关用语创建经过审核的转写文本。对不熟悉的词语采用团队约定的转写规范。
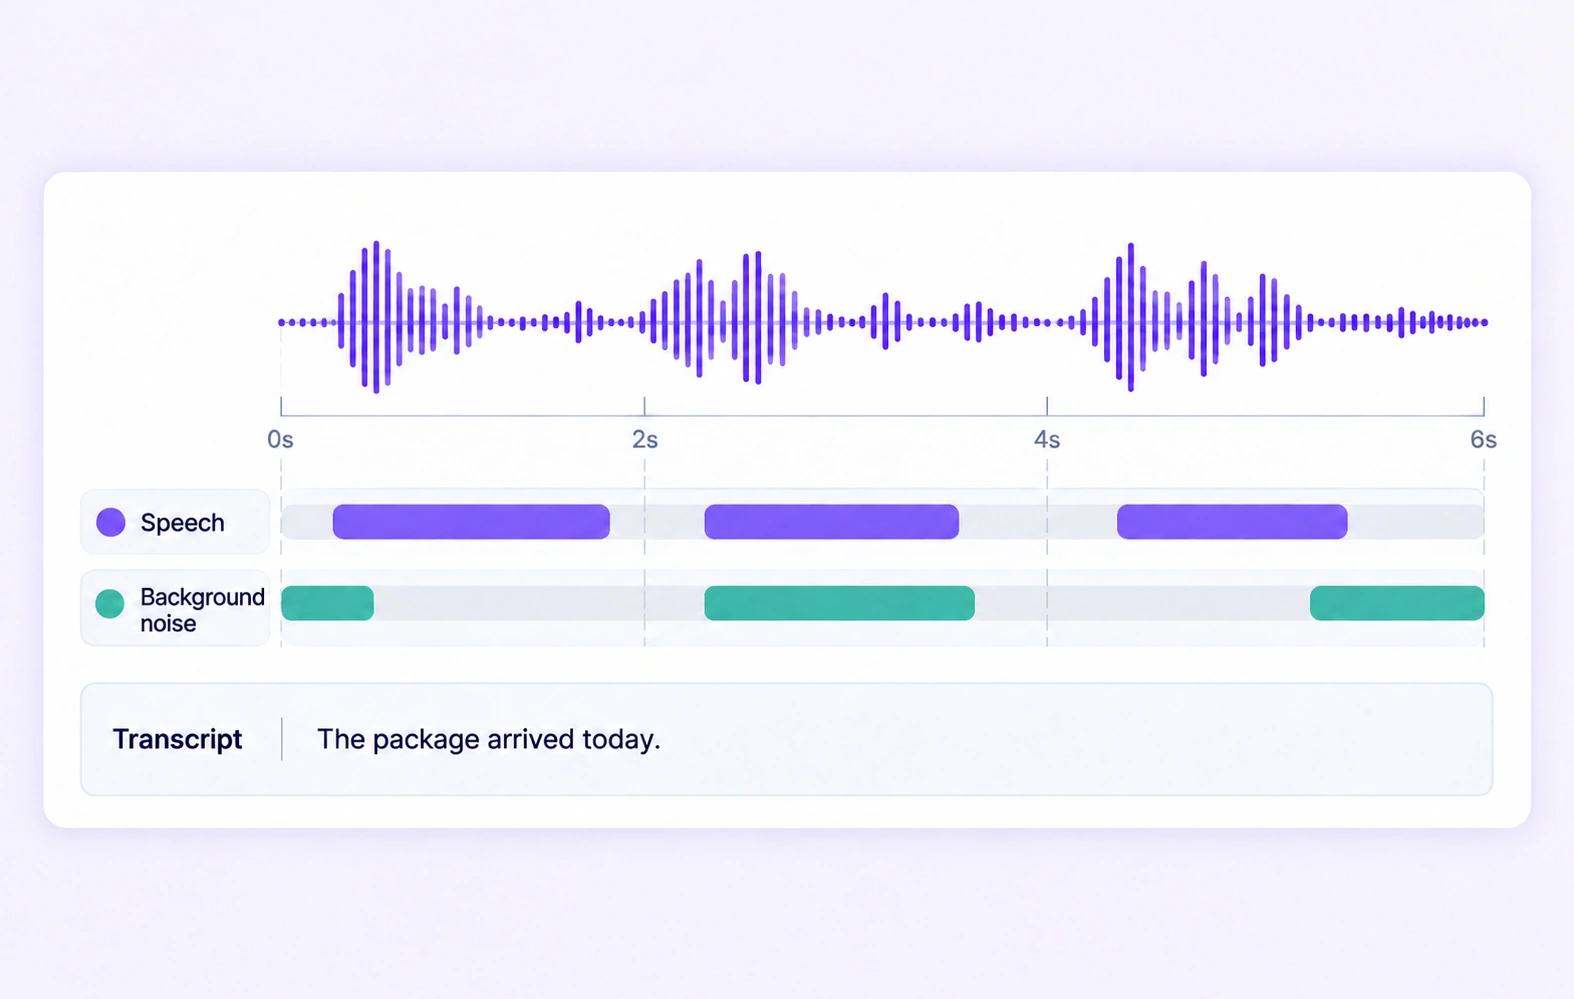
Speech and background-noise intervals share one source waveform and transcript.

噪声环境中的语音

标注可辨识的语音,并记录预先定义的噪声或质量属性。覆盖真实声学条件,对照录音审核模糊不清的区间。
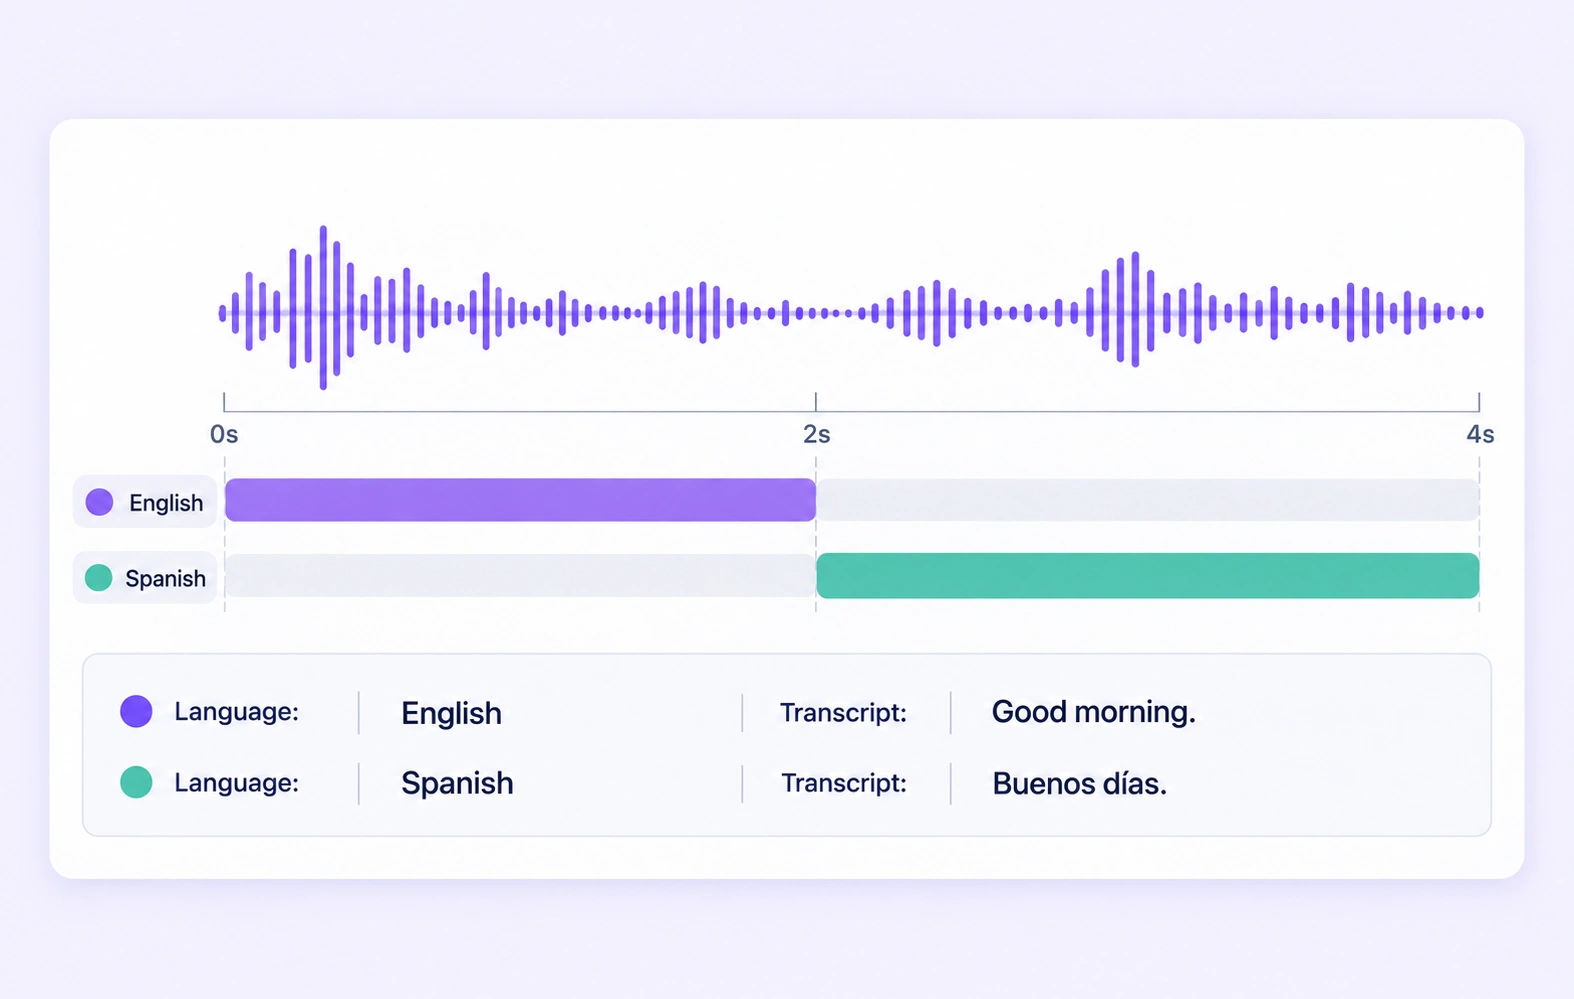
English and Spanish transcript segments align with one bilingual recording.

多语言语音语料库

为相关录音准备对应语言的转写文本和结构化语言标签。将样本分配给熟悉该语言及转写规范的审核人员。

AI 团队为何选择 Unitlab

将音频数据准备、一致的标注规范和专家审核整合到语音识别数据集的统一工作流中。
15X
加快音频标注
60%
释放 AI 工程师时间
5X
降低 AI 开发成本

语音识别与转写的标注方法

根据模型的预期输出选择标签结构。几何信息、时间信息或属性均应以原始音频数据为依据。
A speech interval and its transcript align with a single source waveform.

语音区间与转写文本

在波形上定义语音片段,并将转写文本填写为标注属性。对照实际录音细化片段的起止边界。

录音上下文与质量

通过结构化属性记录语言、声学条件或转写的不确定性。确保这些标签符合源音频和数据集规范。

Speech and background-noise intervals share one source waveform and transcript.

语音识别与转写常见问题

什么是 ASR 训练数据标注?

即为音频片段准备其中所说的文字,以及所需的上下文标签。Unitlab 支持基于时间的音频标注、转写、结构化属性和审核工作流。

转写文本能否与具体音频区间对齐?

可以。转写文本可关联到带有时间信息的语音标注。标注人员可以调整区间,并对照源录音审核相应文字。

如何标注听不清的语音?

对无法辨识或存在不确定性的语音采用统一约定,并记录相关质量属性。审核人员应在接受转写结果前检查音频。

能否准备多语言训练数据?

可以。定义语言属性,并针对数据集中的各语言采用合适的转写指南。分配具备相应专业能力的审核人员验证这些样本。

转写与说话人分离有什么区别?

转写记录说了什么,说话人分离记录每个时间区间对应哪位说话人。当下游语音任务需要时,一个数据集可以同时包含两者。

团队如何保持语音识别标签的一致性?

开始工作前定义共用类别、结构化属性和清晰的标注指南。通过代表性样本和结合上下文的审核,解决语音识别数据集中的标注分歧。

存在不确定性的样本能否审核和修正?

可以。将音频标注流转至审核和返工阶段。审核人员可以检查源数据、修正标签,并在需要进一步处理时退回该数据项。

能否在标注前整理音频数据?

可以。利用数据集搜索、元数据、标签和可用筛选条件选择相关音频资产。在准备过程中保留对代表性条件和困难样本的可见性。

已审核标注如何进入模型流水线?

根据标注任务,以支持的 Audio JSON、RTTM 或 UUEF 格式导出已审核的音频标签。数据集版本有助于团队确认哪些已准备样本属于某次发布。
需要帮助准备语音识别训练数据?联系 Unitlab