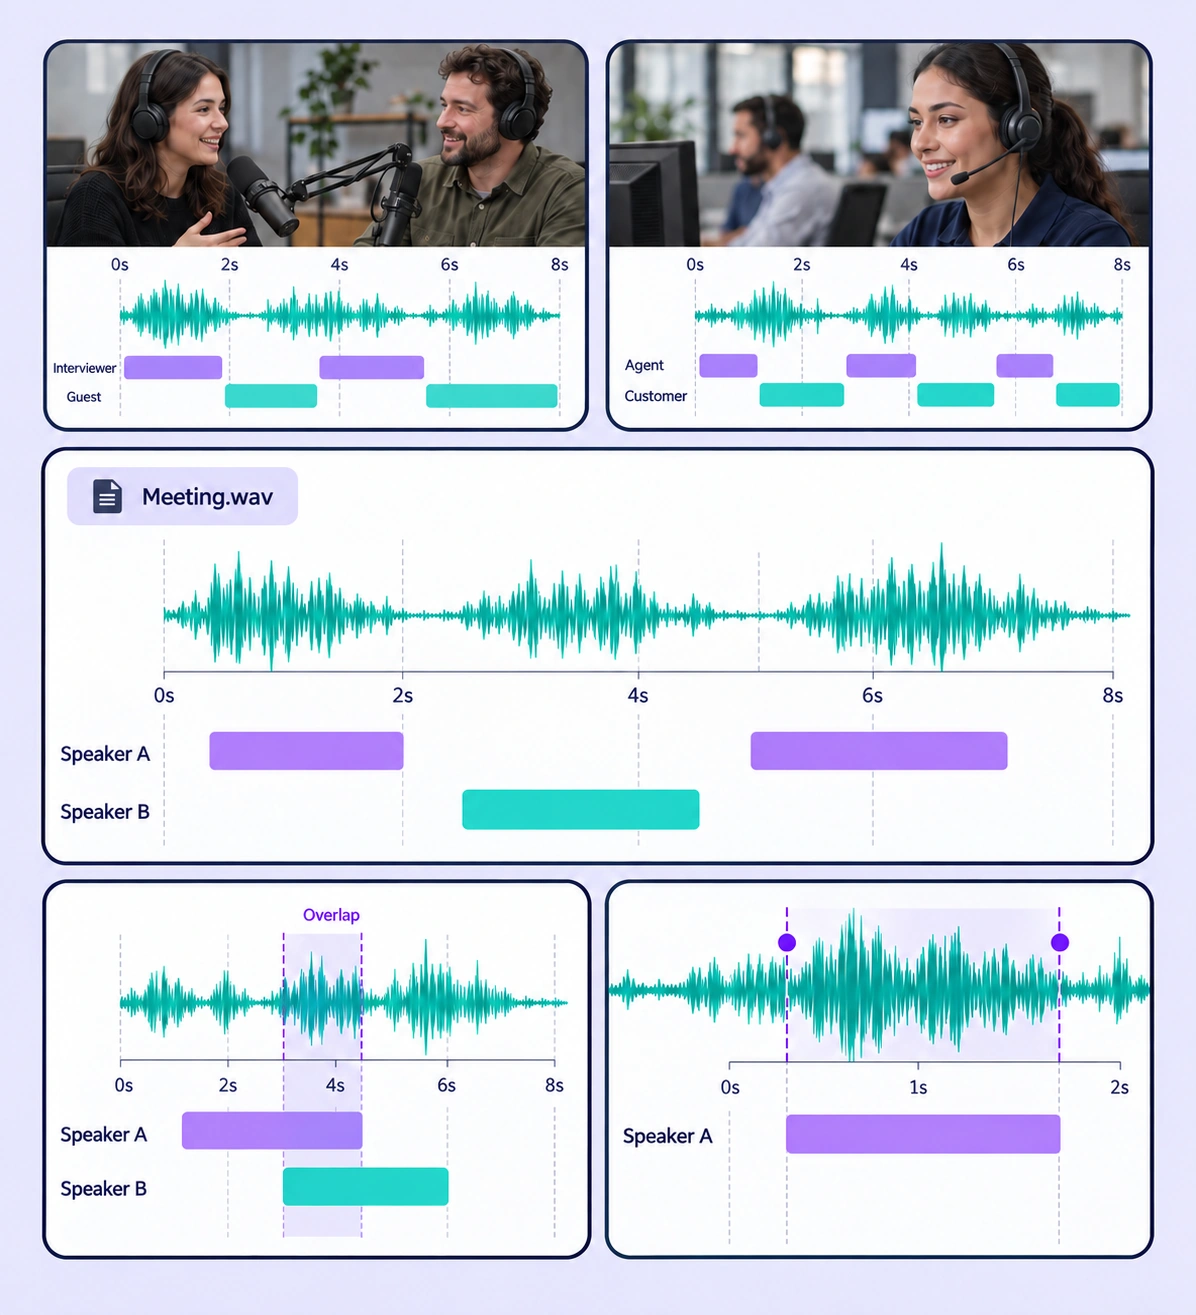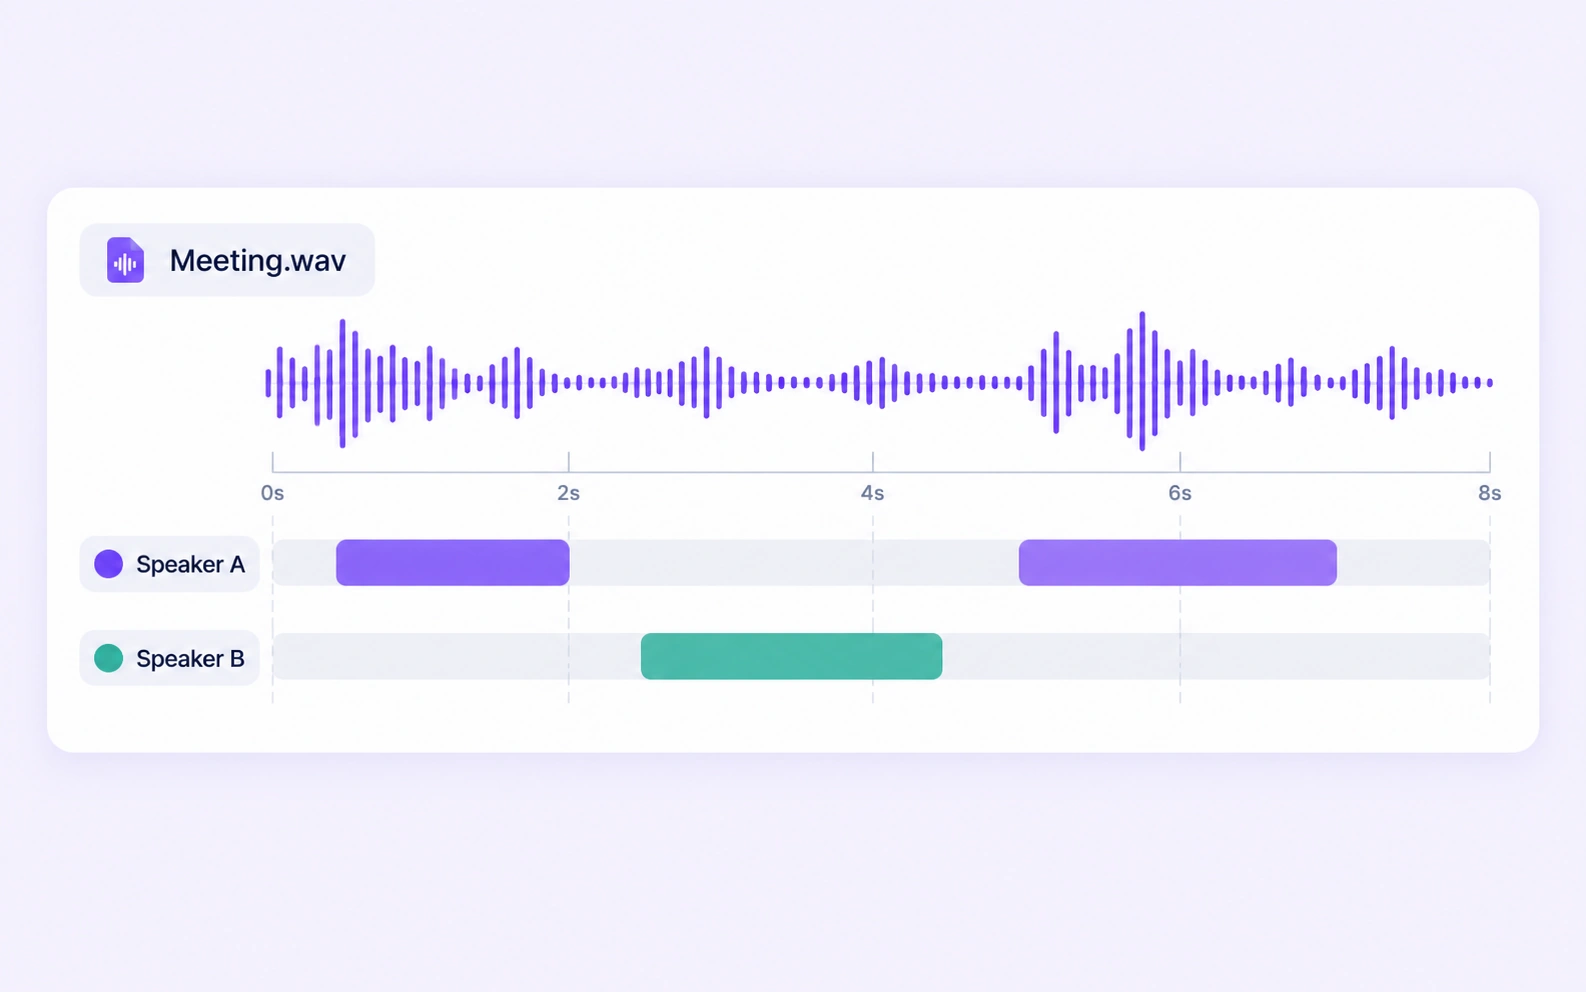
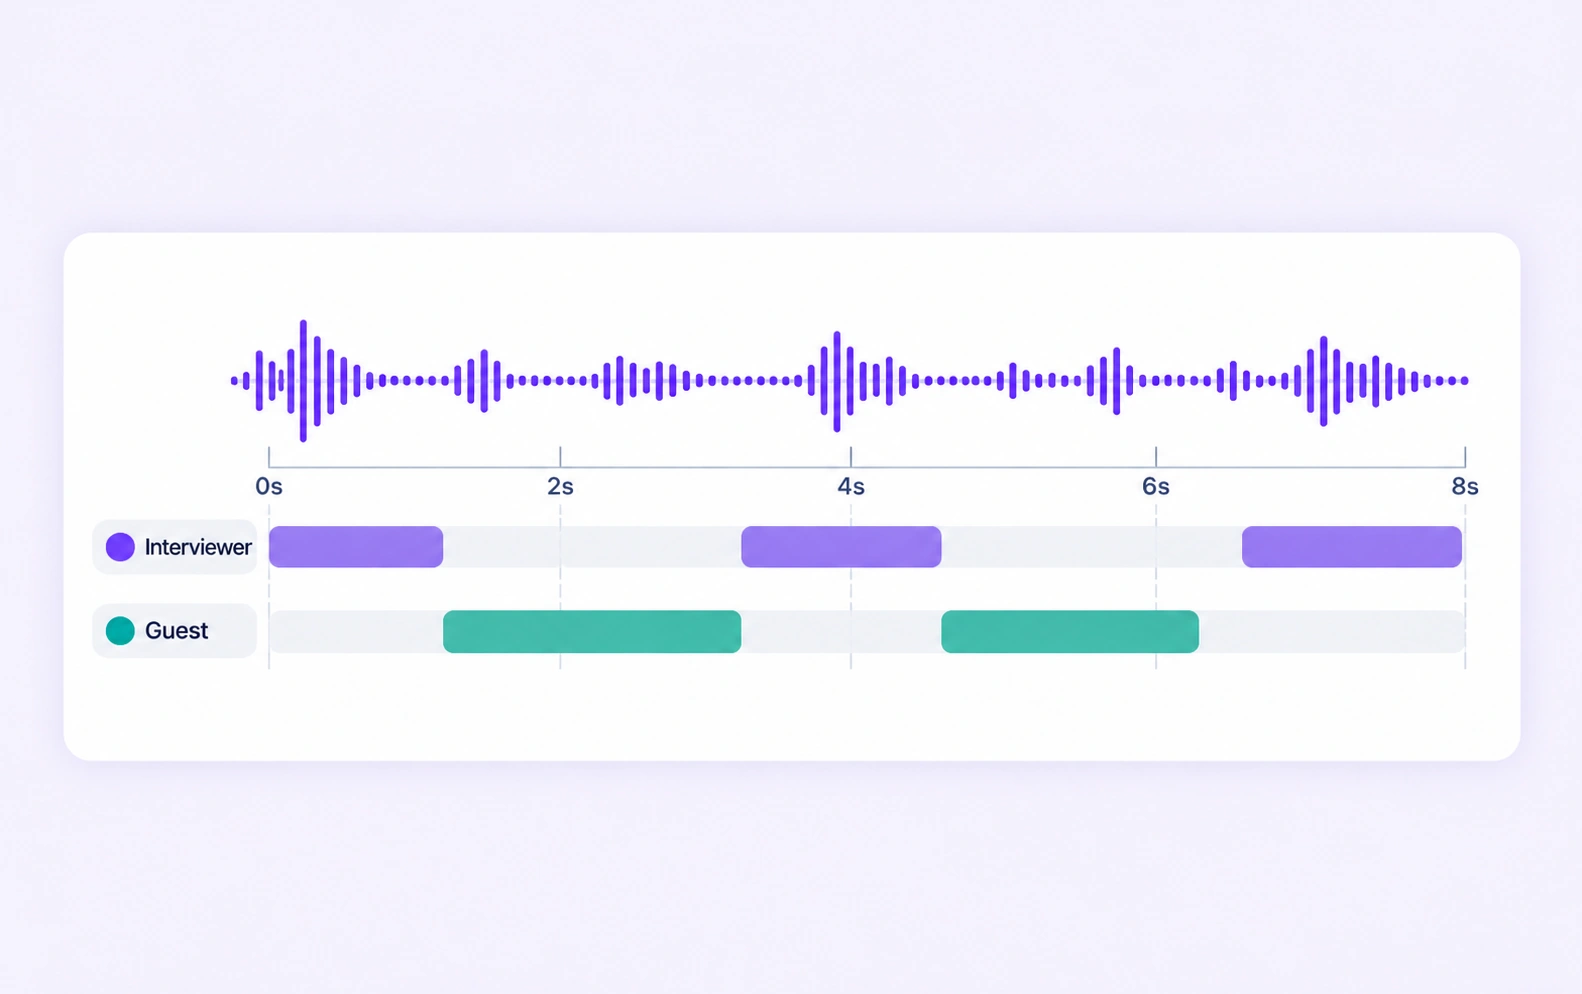
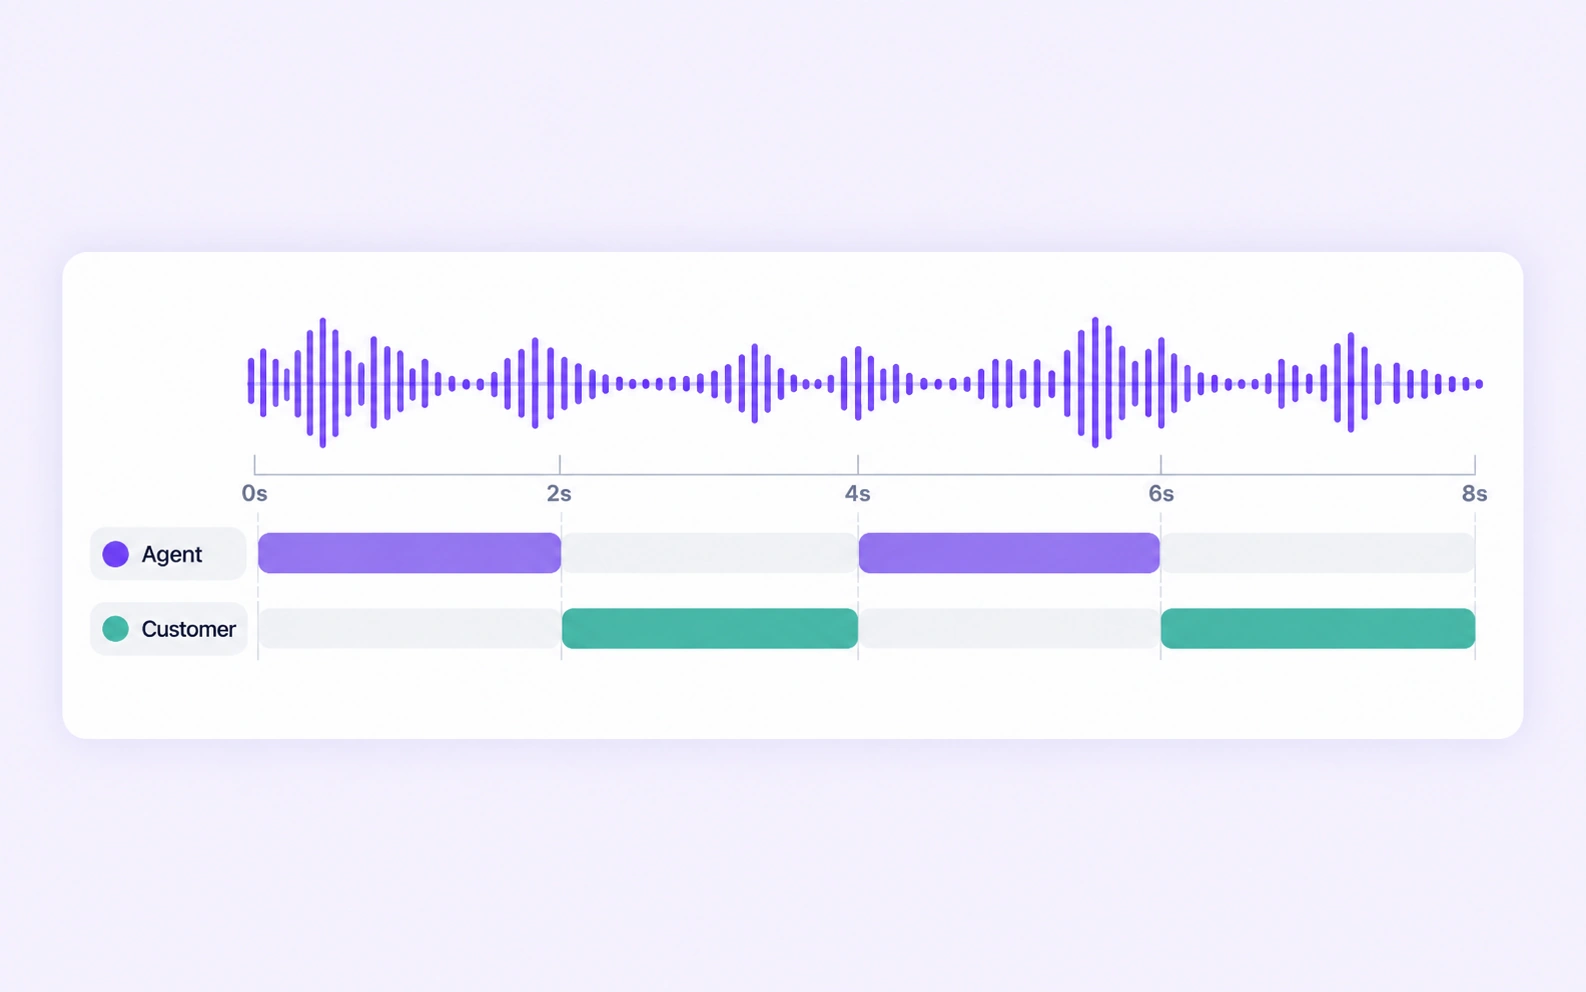
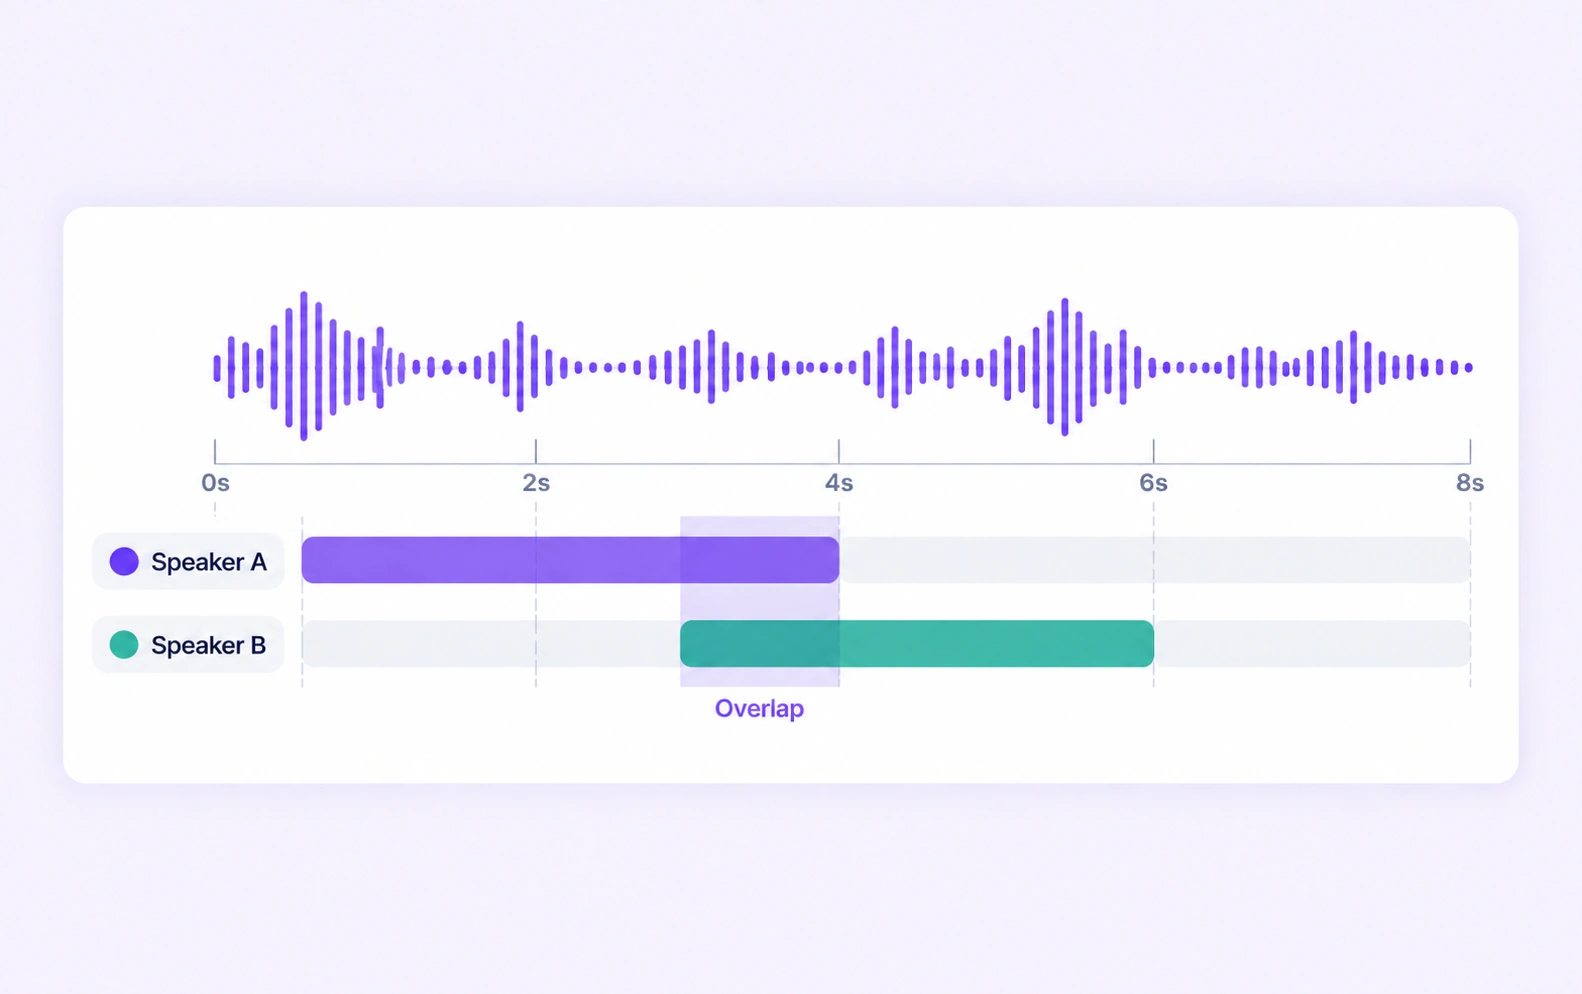
为每位说话人创建发言区间,并在其各轮发言中使用相同标签。对照波形和原始音频调整边界。
用各说话人的时间区间表示同时发言。明确的重叠语音规则有助于标注员一致地处理插话。
说话人分离标注通过音频时间区间说明谁在何时发言。标签通常区分录音中的不同声音,例如说话人 A 和说话人 B,而不是识别真实世界中的个人身份。
可以。定义说话人类别或属性,并在相关区间重复使用。审核人员可以检查整段录音中各轮发言的标签一致性。
按照数据集规则,为重叠部分中听到的各位说话人创建对应时间区间,并对照录音审核准确边界和简短插话。
可以。在录音提供相应信息时使用角色标签或属性,并在本体中明确角色归属和说话人身份的标注规则。
可以。受支持的可见时间段说话人标注可导出为 RTTM,包含录音标识、开始时间、持续时长、声道上下文和说话人标签。
开始标注前,定义共享类别、结构化属性和清晰的标注说明。使用代表性样本和结合上下文的审核来解决数据集中的分歧。
可以。将音频标注送入审核和返工阶段。审核人员可以检查源数据、修正标签,并在需要继续处理时退回任务。
可以。通过数据集搜索、元数据、标签及可用筛选条件选择相关音频资产,在数据准备过程中保留代表性场景和困难样本。
根据标注任务,将已审核的音频标签导出为受支持的 Audio JSON、RTTM 或 UUEF 格式。数据集版本记录源样本的组成,项目标注发布版则固定交付的标注输出。