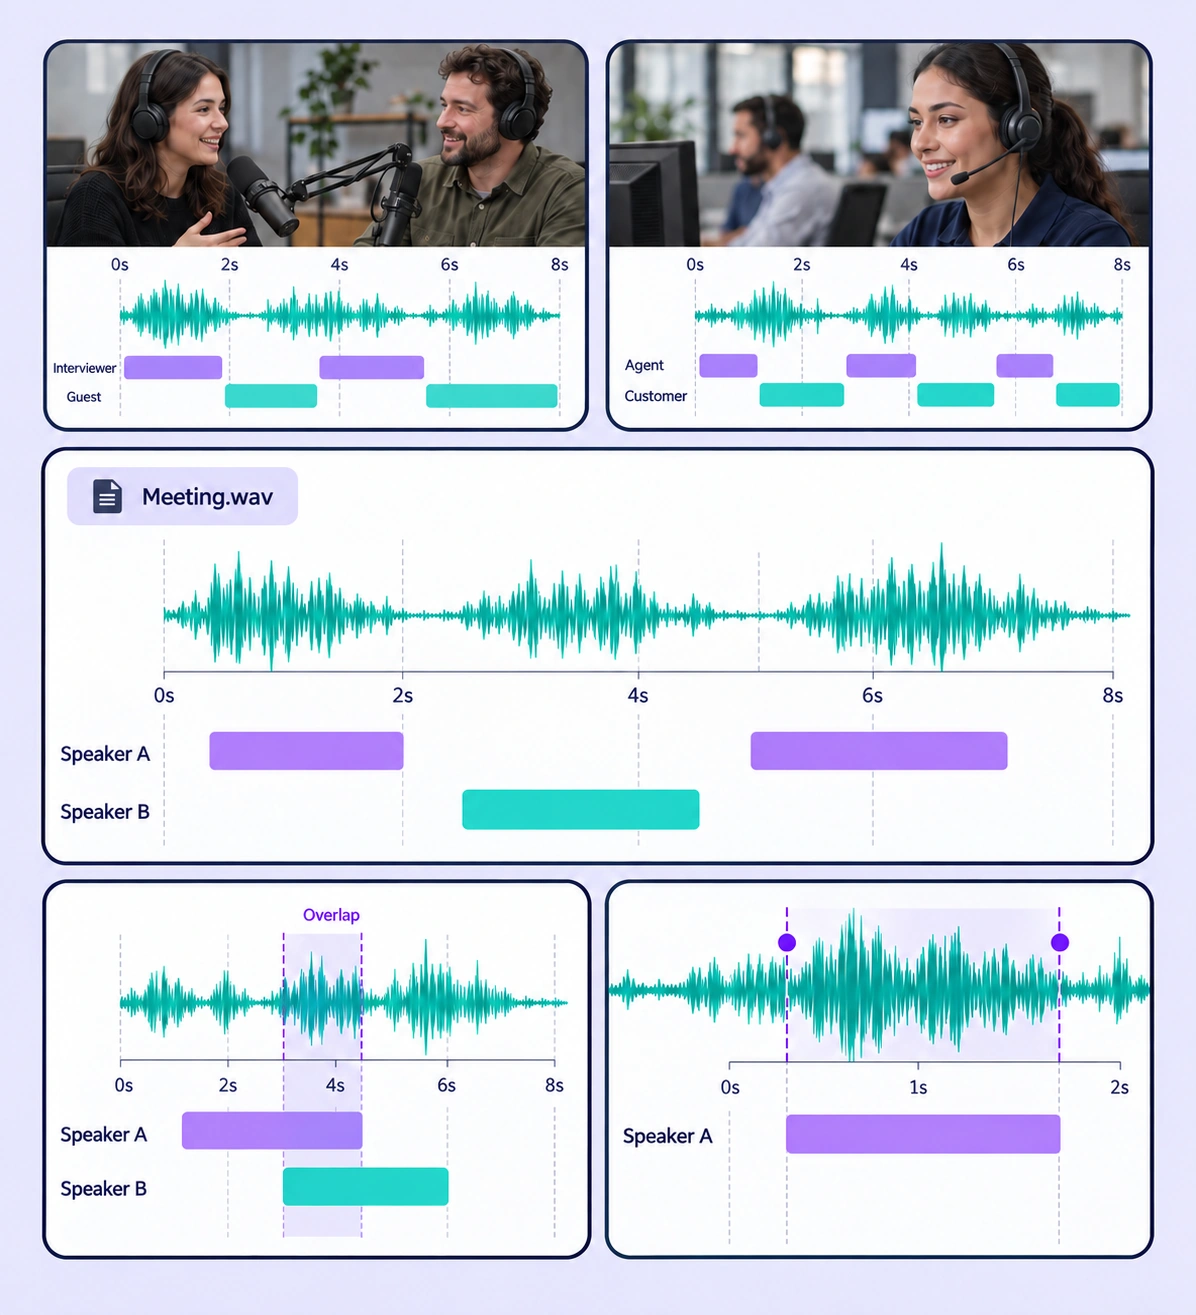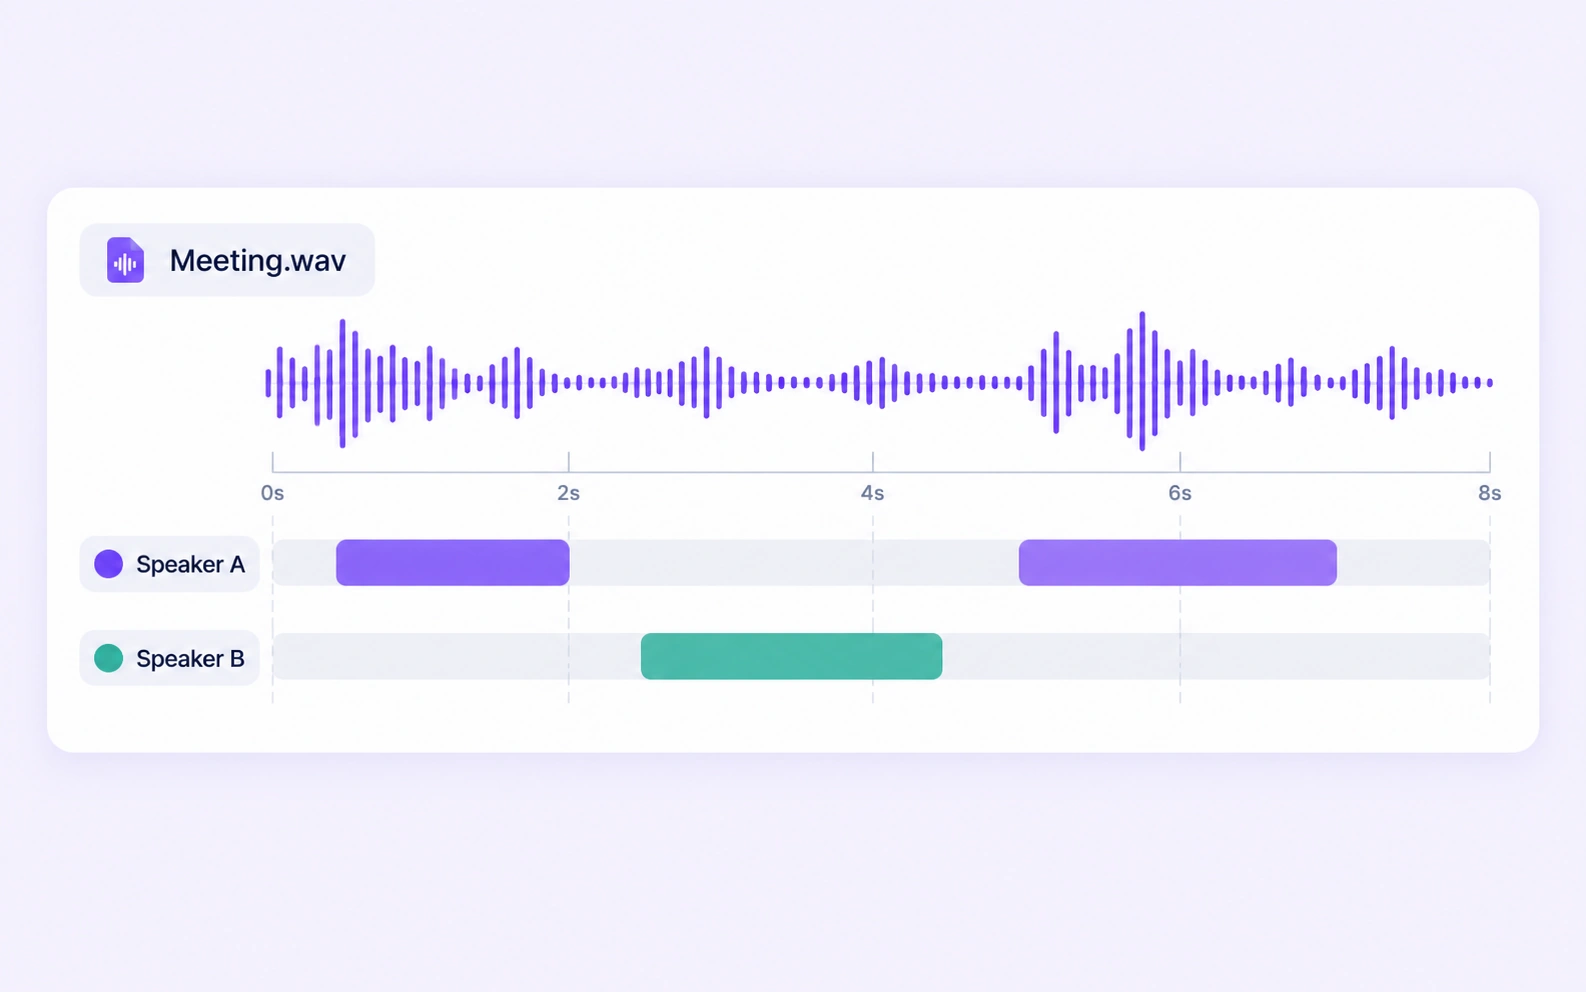
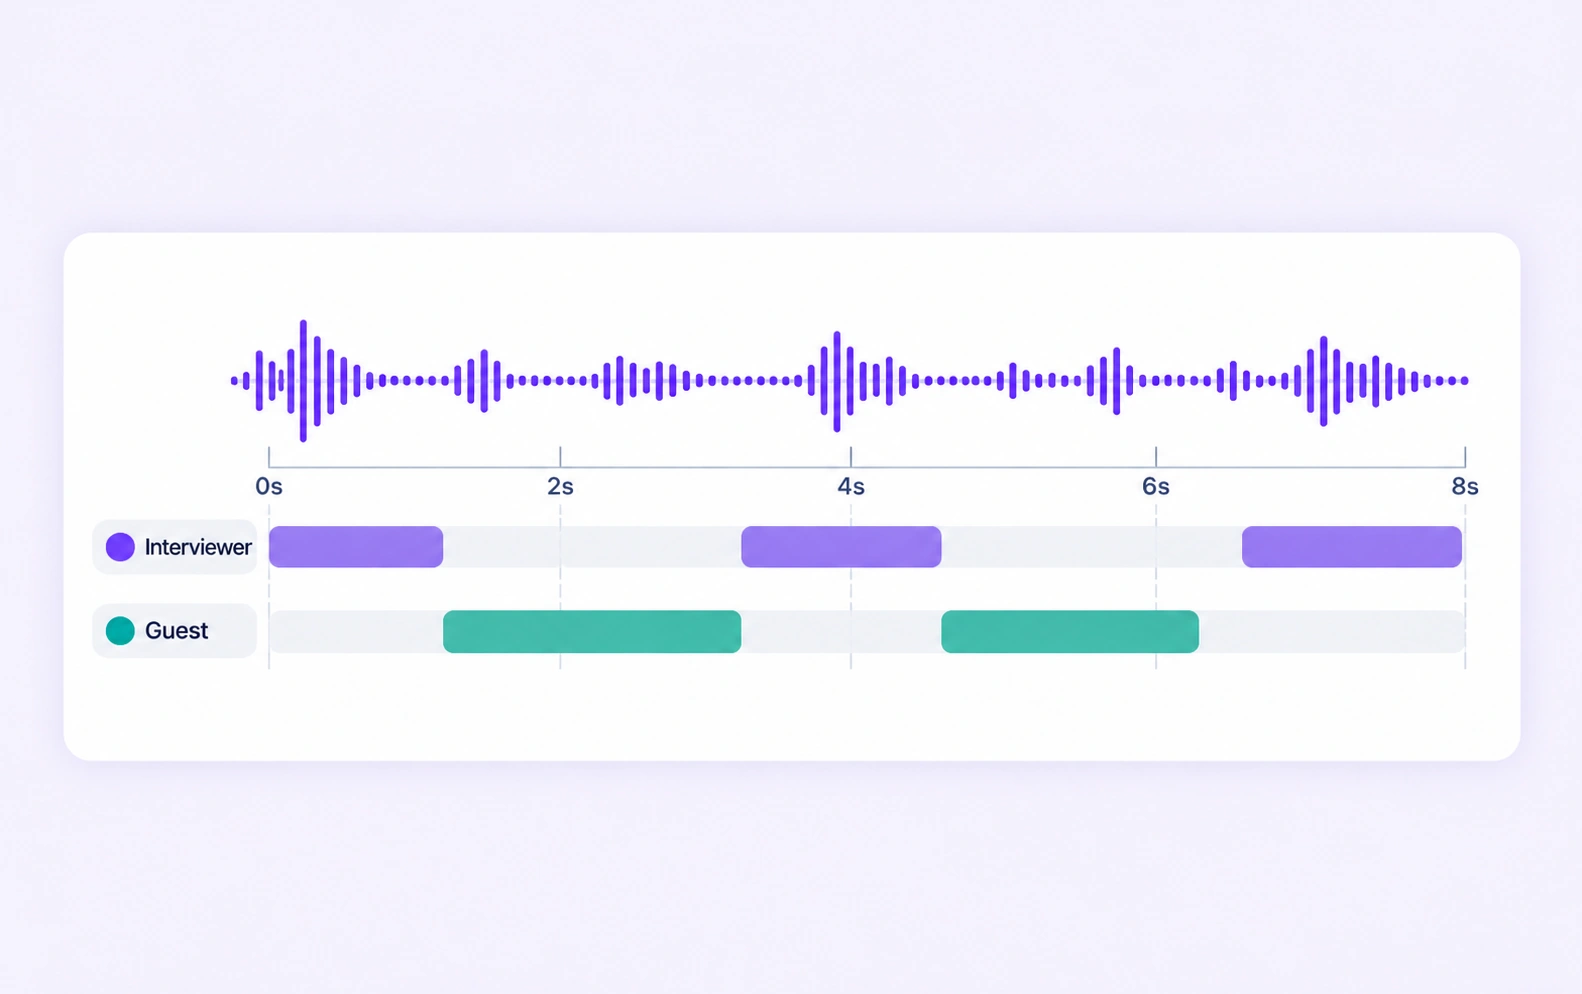
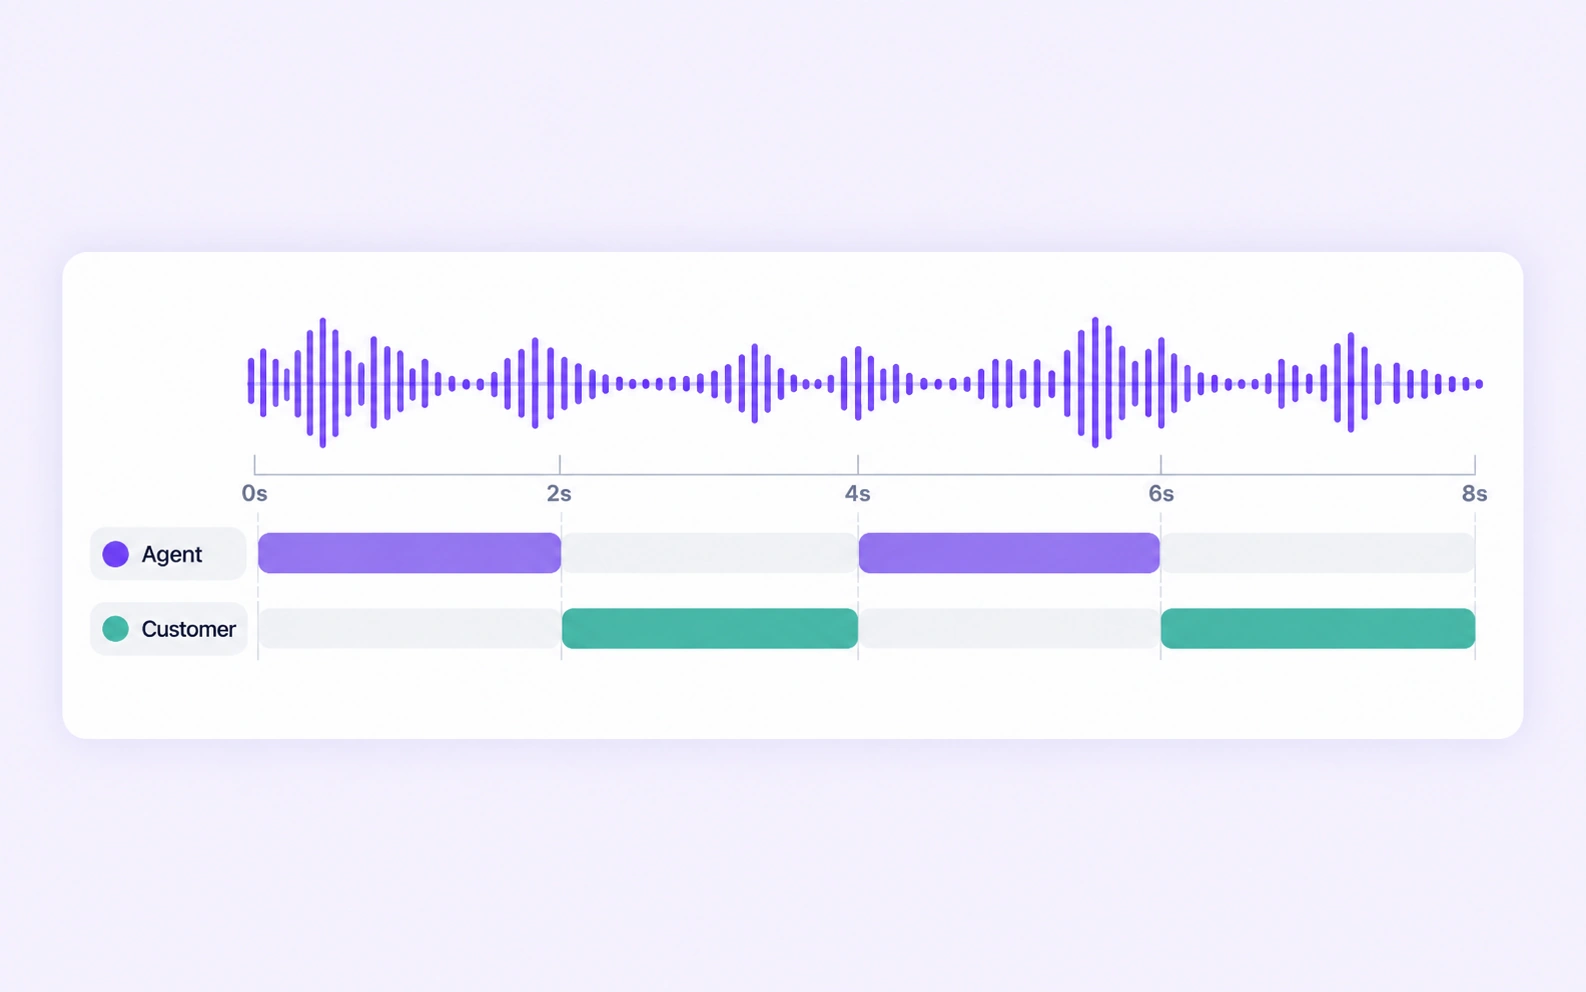
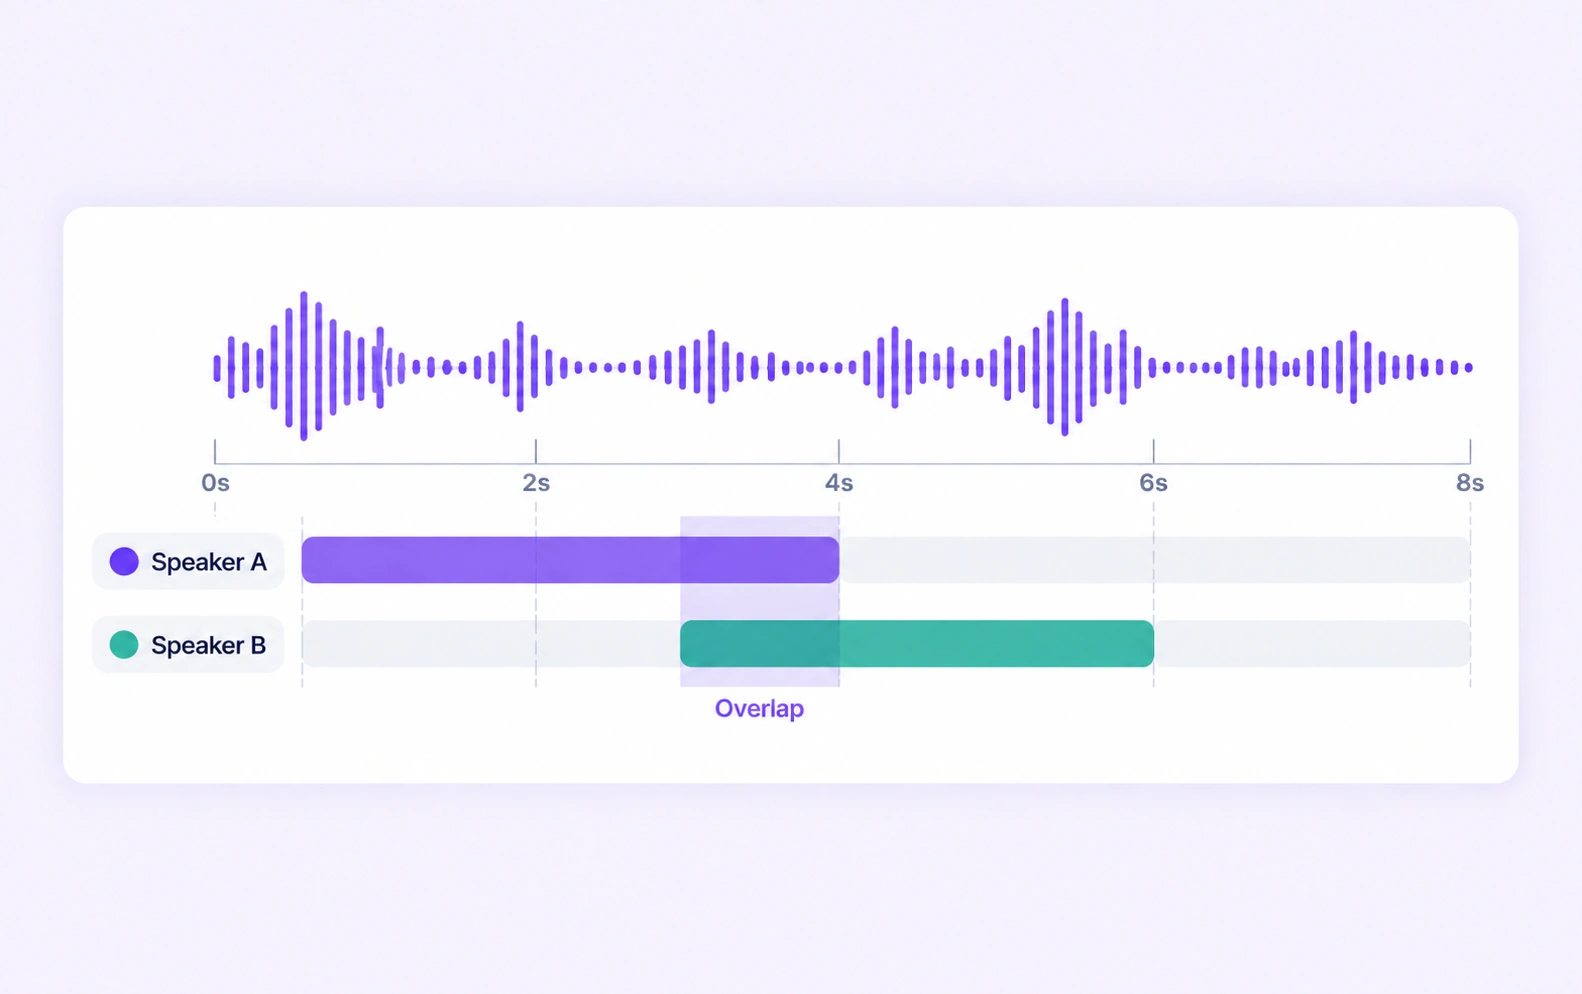
각 화자의 발화 구간을 만들고 모든 발화에서 동일한 라벨을 유지하세요. 파형과 원본 오디오를 확인하며 경계를 조정합니다.
동시에 발화하는 화자의 시간 구간을 각각 표시하세요. 명확한 중첩 음성 정책은 어노테이터가 끼어들기를 일관되게 처리하는 데 도움이 됩니다.
오디오의 시간 구간에 라벨을 붙여 누가 언제 말했는지 표시하는 작업입니다. 화자 A, 화자 B처럼 녹음 안의 서로 다른 목소리를 구분하며, 일반적으로 실제 개인의 신원을 식별하는 것은 아닙니다.
네. 화자 클래스나 속성을 정의한 뒤 관련 구간에 반복해서 사용하세요. 검토자는 파일 전체에서 발화별 라벨의 일관성을 확인할 수 있습니다.
데이터셋 정책에 따라 겹치는 부분에서 들리는 각 화자의 시간 구간을 만드세요. 녹음을 확인하며 정확한 경계와 짧은 끼어들기를 검토합니다.
네. 녹음에서 해당 정보를 확인할 수 있다면 역할 기반 라벨이나 속성을 사용하세요. 온톨로지에 역할 구분과 화자 식별 규칙을 명확히 정의합니다.
네. 지원되는 표시 상태의 시간 구간 화자 어노테이션을 RTTM으로 내보낼 수 있습니다. 녹음 식별자, 시작 시간, 지속 시간, 채널 정보, 화자 라벨이 포함됩니다.
작업 전에 공통 클래스, 구조화된 속성, 명확한 라벨링 지침을 정의하세요. 대표 사례와 맥락을 고려한 검토를 통해 데이터셋 내 의견 차이를 해결합니다.
네. 오디오 어노테이션을 검토 및 재작업 단계로 전달하세요. 검토자는 원본 데이터를 확인하고 라벨을 수정하며, 추가 작업이 필요하면 항목을 돌려보낼 수 있습니다.
네. 데이터셋 검색, 메타데이터, 태그, 사용 가능한 필터로 관련 오디오 에셋을 선택하세요. 대표적인 조건과 어려운 사례를 데이터 준비 과정에서 함께 관리합니다.
작업에 따라 검토된 오디오 라벨을 지원되는 Audio JSON, RTTM 또는 UUEF 형식으로 내보내세요. 데이터셋 버전은 원본 샘플 구성을 기록하고, 프로젝트 어노테이션 릴리스는 전달할 라벨 출력을 고정합니다.