计算机视觉数据集整理

将持续增长的图像与视频集合转化为经过筛选、可追溯的数据集。审核重复及低质量样本,查找相关案例,检查覆盖范围,并保留交付的源数据集合。
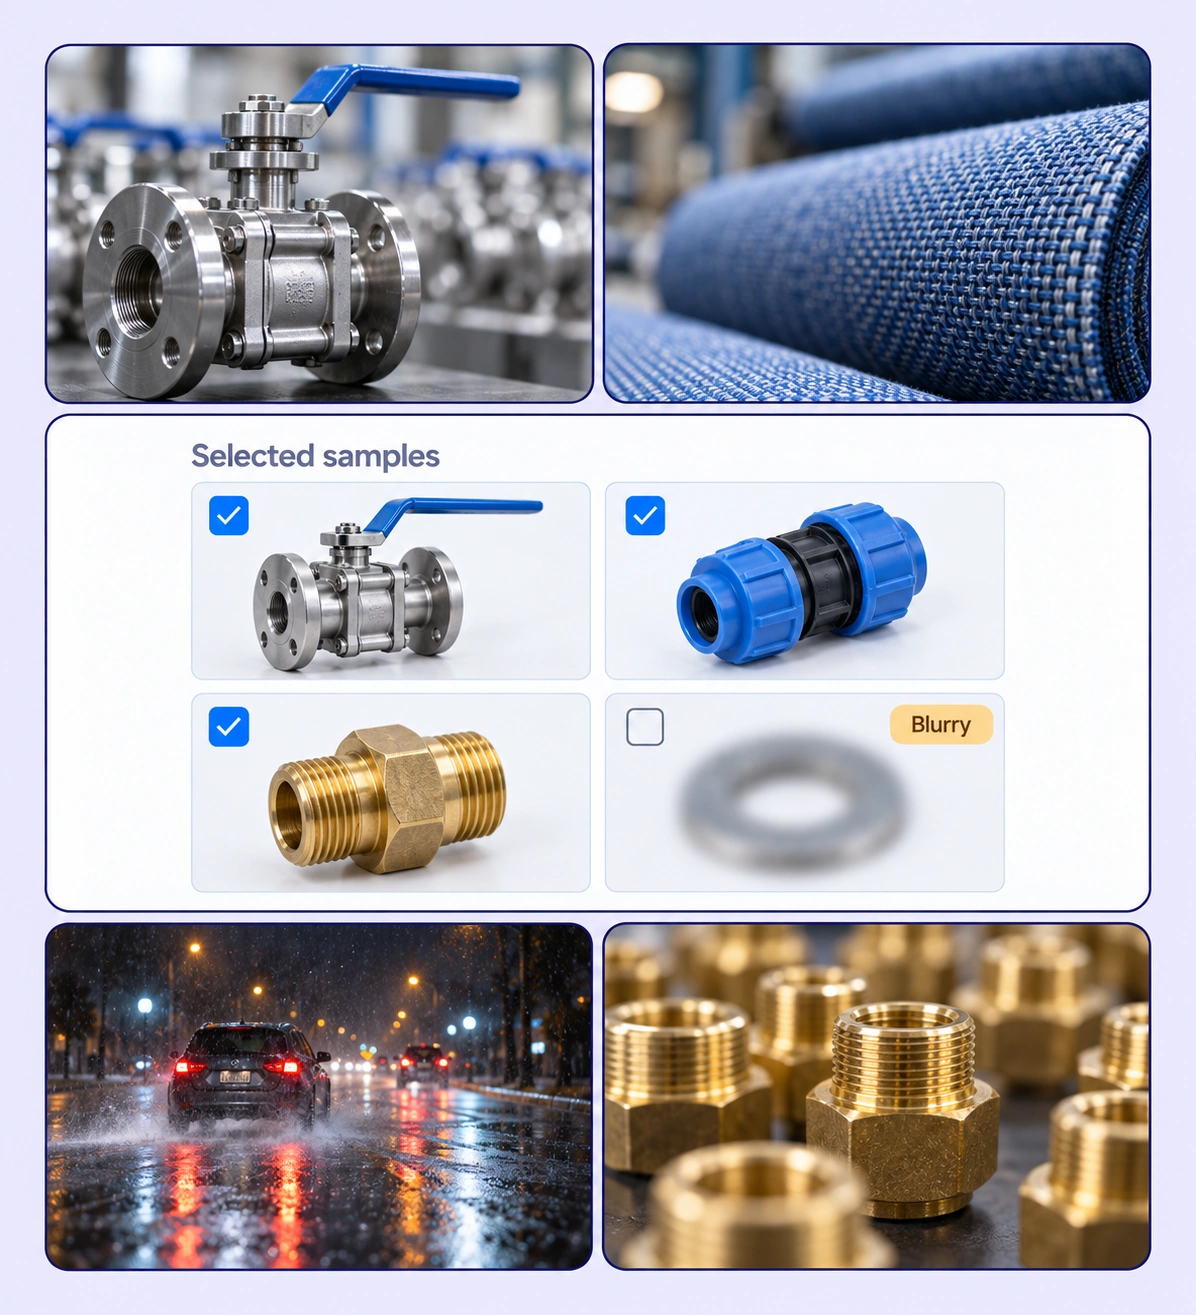
Computer vision dataset curation collage with selected visual samples and a blurred sample retained for review.

从原始视觉数据到精选数据集

通过连贯的数据整理工作流,确定应纳入数据集的内容,并为下一阶段保留筛选结果。
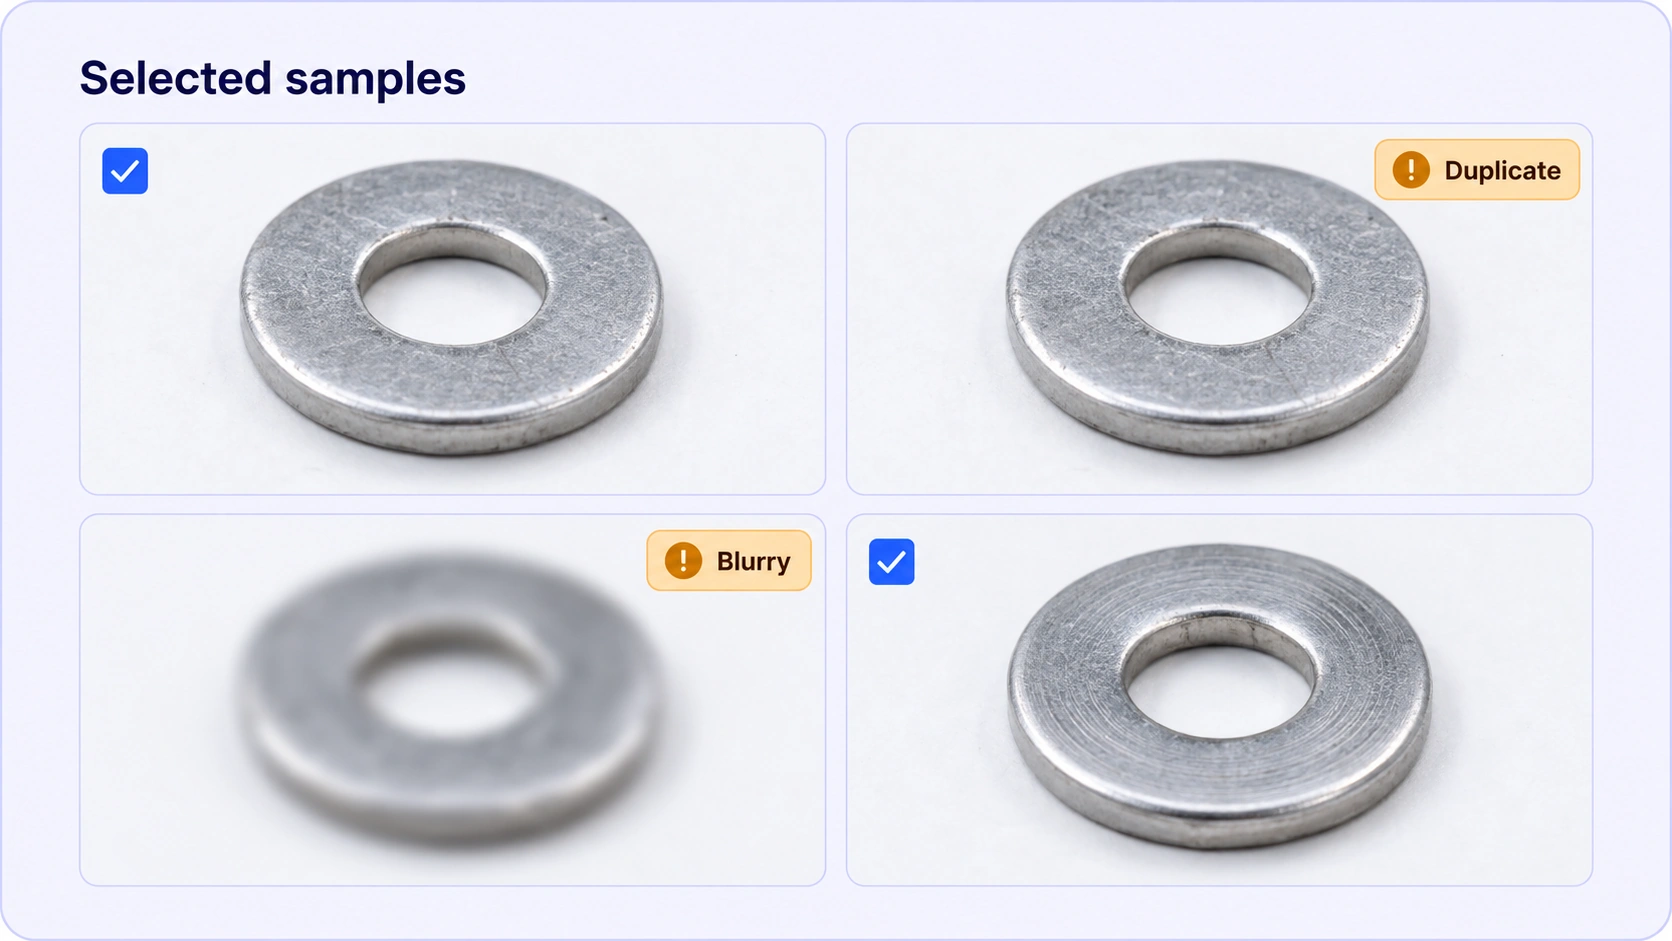
Washer samples reviewed for duplicates and blur, with two sharp samples selected.

审核重复样本与图像质量

检查候选重复样本,并使用模糊度等已映射质量筛选条件。在投入标注工作前,对比源样本并决定保留哪些数据。
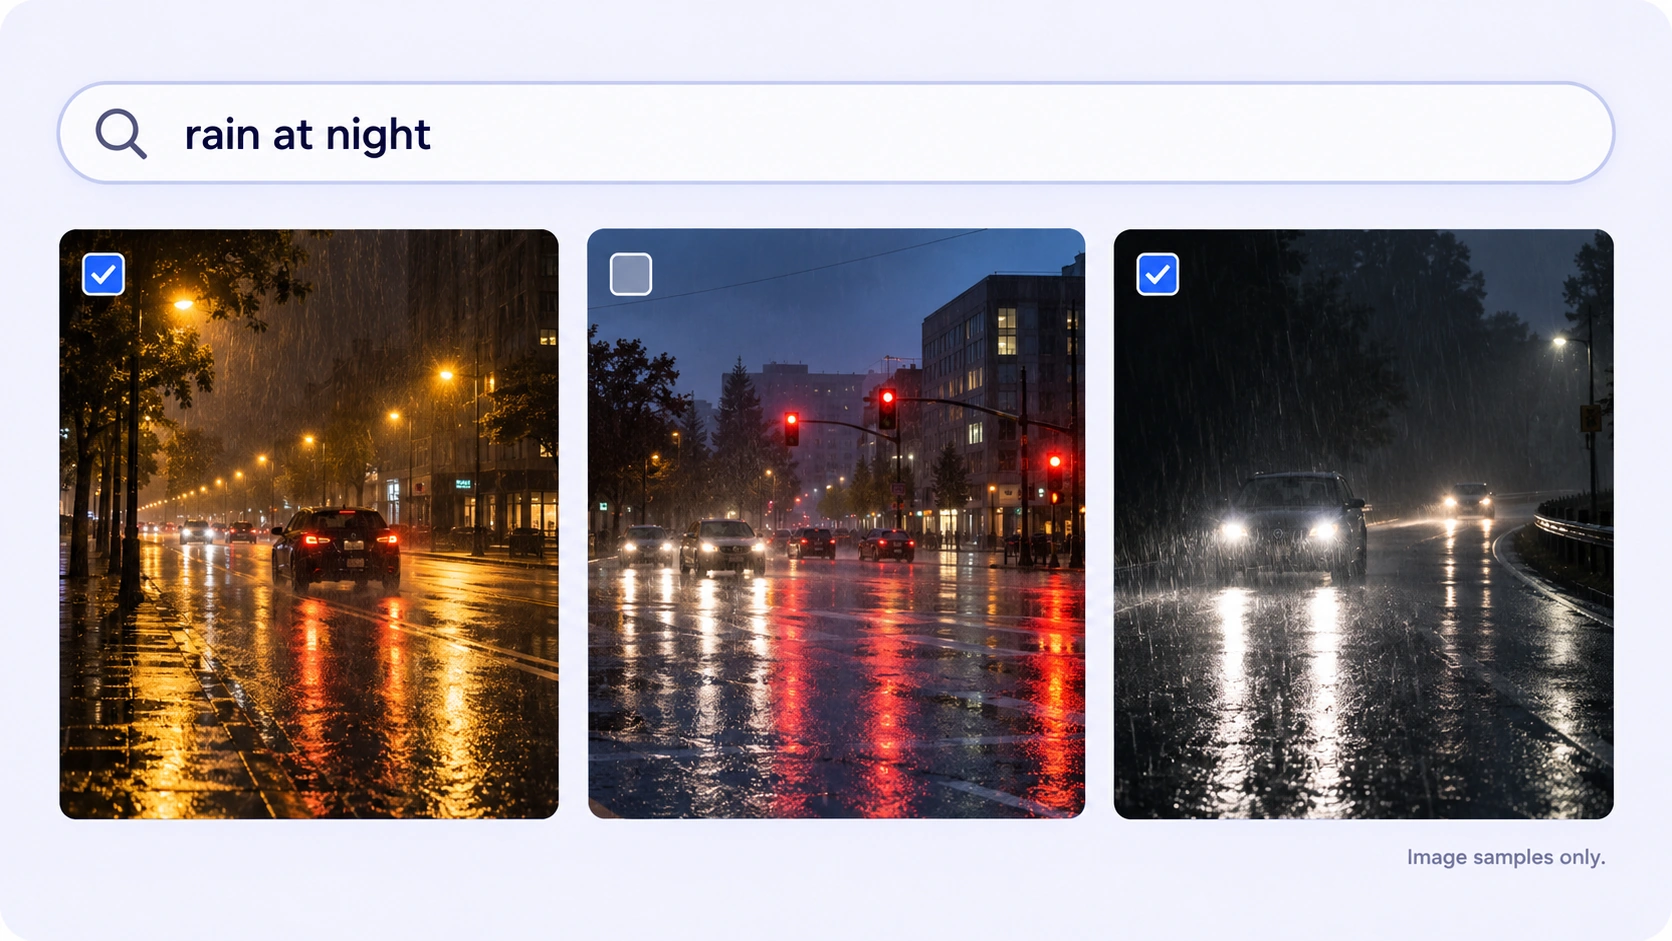
Rain-at-night image search results with selected road scenes.

发现相关与稀有案例

利用受支持的视觉相似度、文本搜索和元数据查找值得检查的示例。搜索夜间降雨等条件,选择与模型任务相关的案例。
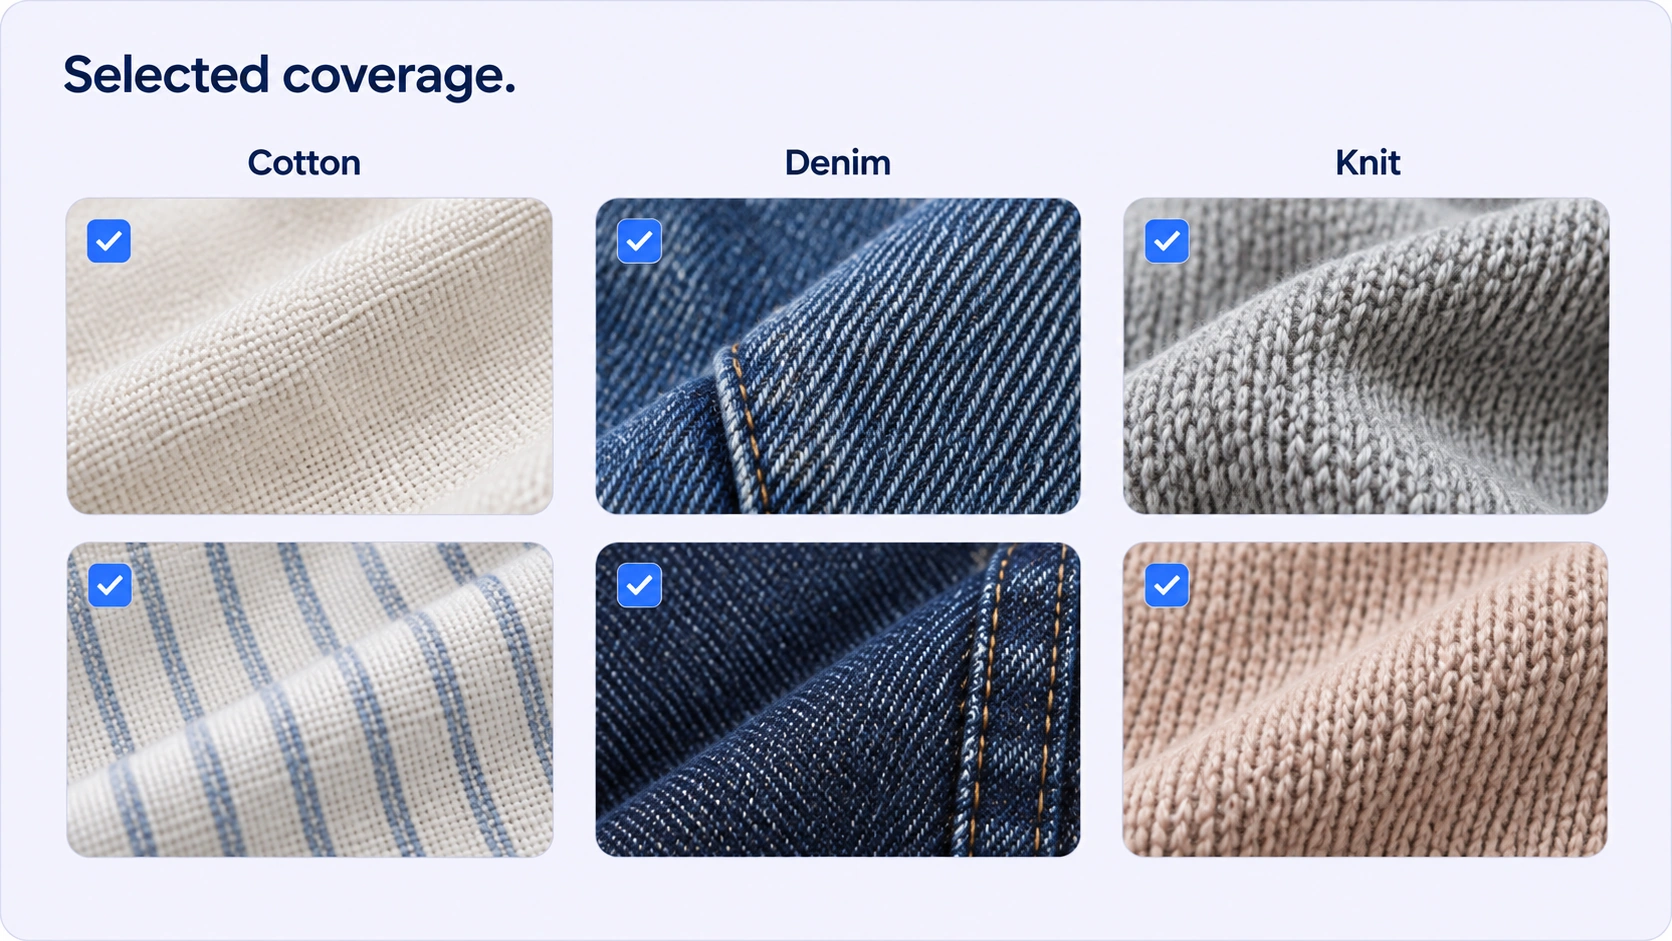
Selected cotton, denim and knit image samples organized by material.

检查数据集覆盖范围

通过元数据类别对比选入数据集的示例。检查已知材料、场景或条件的覆盖范围,有针对性地调整筛选结果。
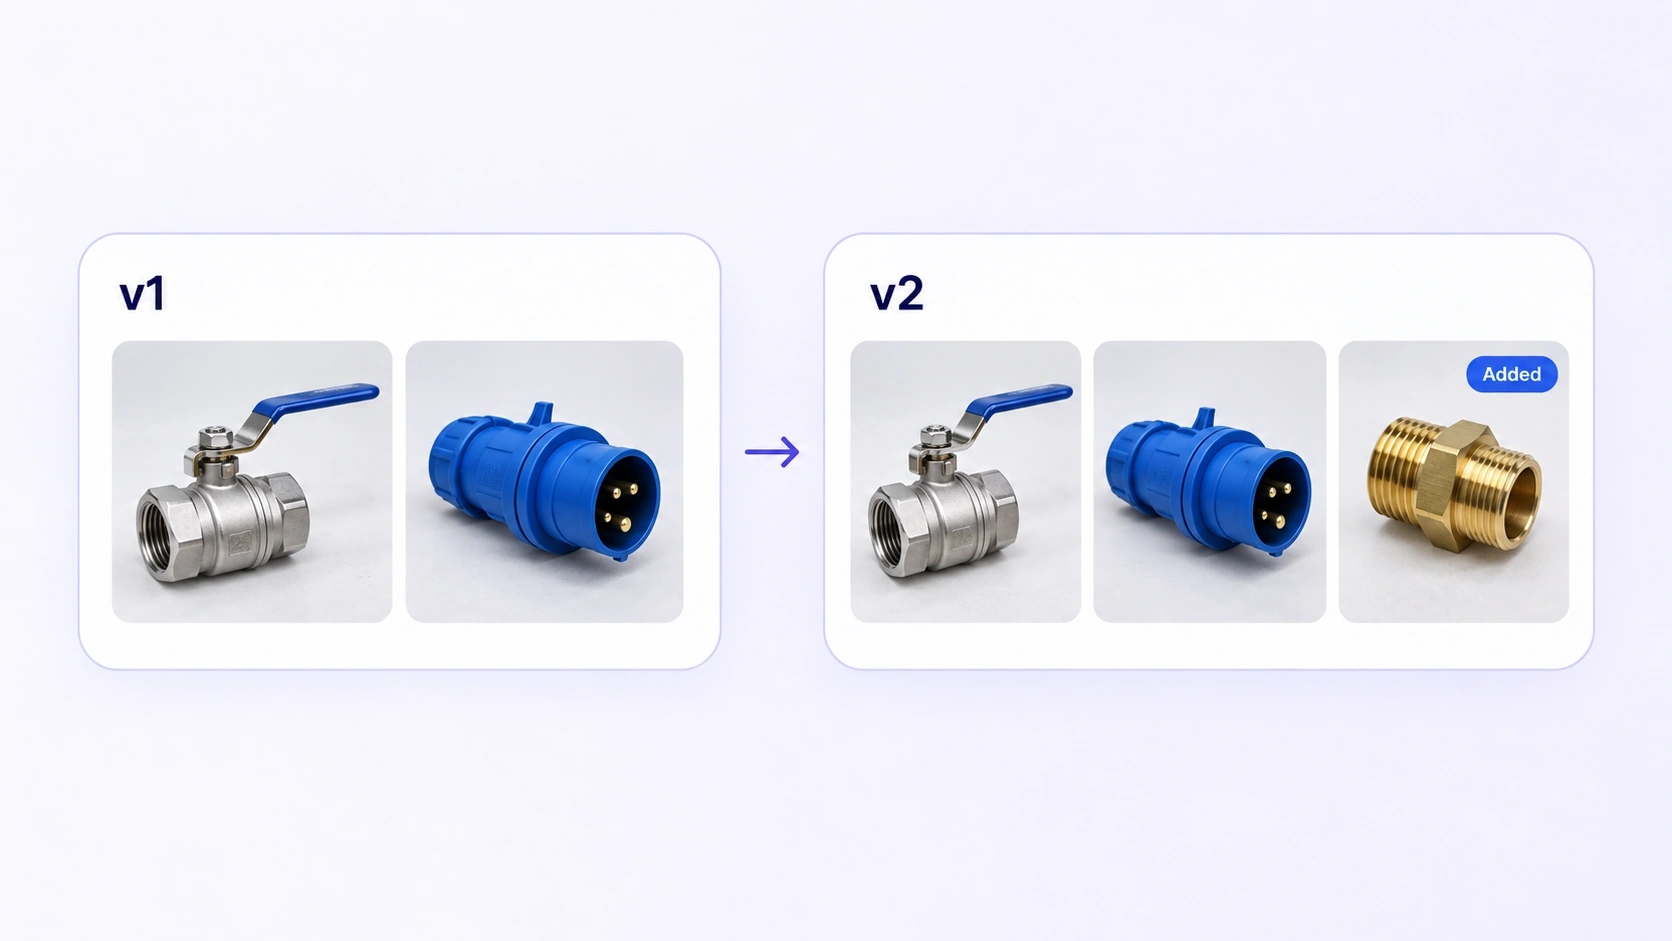
Two dataset snapshots with matching samples and one added fitting image.

按版本交付数据集

将选定的数据集草稿发布为不可变快照。保留交付给标注或下游准备流程的源数据集合,同时在草稿中继续后续编辑。

AI 团队为何选择 Unitlab

在整理计算机视觉数据集时,让源数据、标注规则和审核决策保持关联。
15X
更快的数据标注
60%
节省 AI 工程师的时间
5X
降低 AI 开发成本

视觉数据集整理工具

明确记录样本筛选结果及交付下游的版本。
Selected cotton, denim and knit image samples organized by material.

基于元数据筛选

已映射的元数据筛选条件与类别帮助团队检查样本覆盖范围。筛选仍是需要审慎作出的数据准备决策,并不保证统计平衡。

已发布的数据集快照

数据集版本保留所选源数据集合。新编辑在草稿中继续,也可将历史版本恢复为草稿后进一步处理。

Two dataset snapshots with matching samples and one added fitting image.

计算机视觉数据集整理常见问题

什么是计算机视觉数据集整理?

这是针对特定模型任务筛选和组织图像与视频数据的过程。团队检查质量、冗余、相关性及覆盖范围,再将明确的源数据集合交付标注或下游准备流程。

数据整理与标注有何不同?

数据整理决定哪些源样本应纳入数据集及其组织方式。标注则添加模型任务所需的标签。整理后的数据集可进入已配置的标注工作流。

能否审核重复和模糊样本?

可以。受支持的重复搜索与已映射图像质量筛选条件可找出待检查样本。团队对比源样本并决定保留哪些数据;此工作流并不表示会自动删除数据。

如何找到稀有视觉条件?

结合受支持的图像与视频搜索及元数据检查相关示例。夜间降雨等查询有助于找到候选场景,但团队仍需审核其相关性与覆盖范围。

嵌入向量对所有文件类型的作用都相同吗?

此处描述的视觉搜索能力适用于受支持的图像与视频数据。不应假定它对任意表格、传感器或其他文件类型提供相同的嵌入或搜索行为。

元数据能否帮助平衡数据集?

元数据可按已知类别组织和筛选样本,让团队检查覆盖范围。筛选应符合模型任务与评估设计;界面不保证样本代表性,也不会自动保证数据平衡。

可以使用哪些数据整理筛选条件?

使用适用于所选资源类型的已映射筛选条件,包括受支持的元数据与图像质量控件。部分筛选概念可能仍处于预览阶段,因此工作流应使用适用于当前数据的控件。

发布数据集版本会保留什么?

发布会创建数据集工作草稿的不可变快照,保留用于交付的源数据筛选结果,而后续修改可在草稿中单独继续。

能否复用历史数据集版本?

可以。已发布版本保留在数据集历史记录中,恢复版本会创建可继续处理的草稿。团队可重新使用此前的源数据筛选结果,而不修改已保存的快照。