
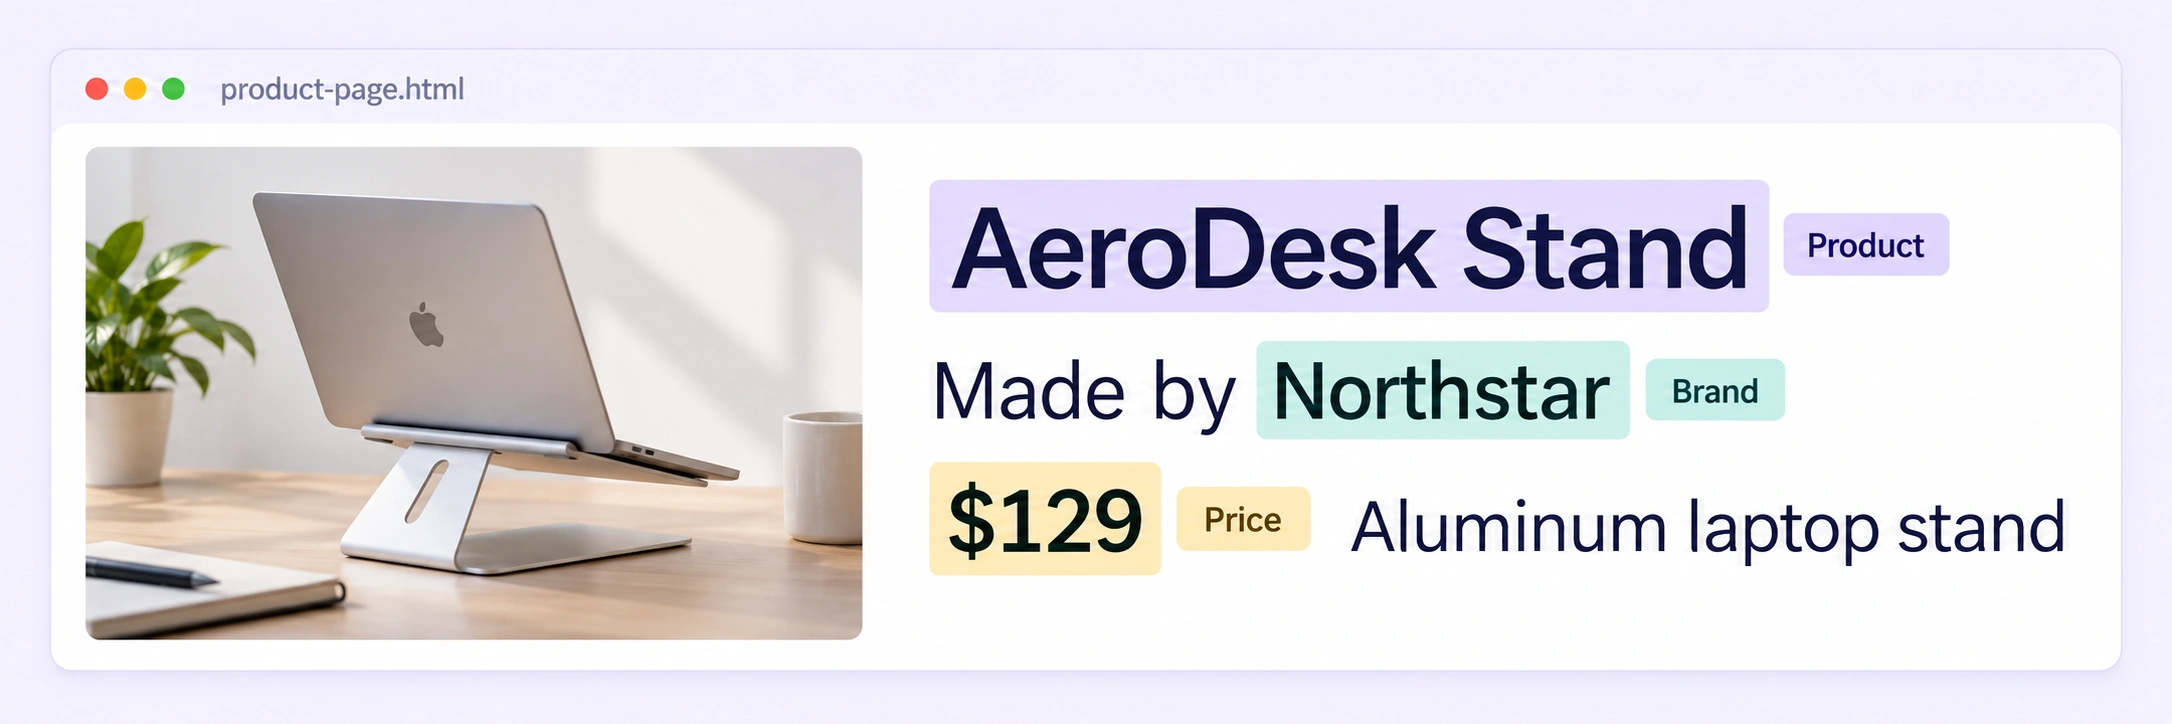
텍스트 범위 어노테이션
렌더링된 HTML 페이지에서 제품명, 직무명, 가격 등 보이는 텍스트를 직접 선택합니다. 각 라벨이 정확한 단어와 주변 맥락에 연결되도록 유지하세요.
정확한 텍스트 선택인라인 라벨원본 페이지 맥락

저장한 웹페이지를 신뢰할 수 있는 AI 학습 데이터로 전환하세요. 원본 레이아웃에서 텍스트를 라벨링하고 엔티티를 연결하며, 공유 온톨로지와 품질 워크플로로 어노테이션을 검토합니다.
렌더링된 페이지에서 정확한 텍스트 범위와 맥락에 맞는 관계를 라벨링합니다. 재사용 가능한 온톨로지와 이력이 남는 사람의 검토를 함께 활용하세요.
렌더링된 HTML 페이지에서 제품명, 직무명, 가격 등 보이는 텍스트를 직접 선택합니다. 각 라벨이 정확한 단어와 주변 맥락에 연결되도록 유지하세요.
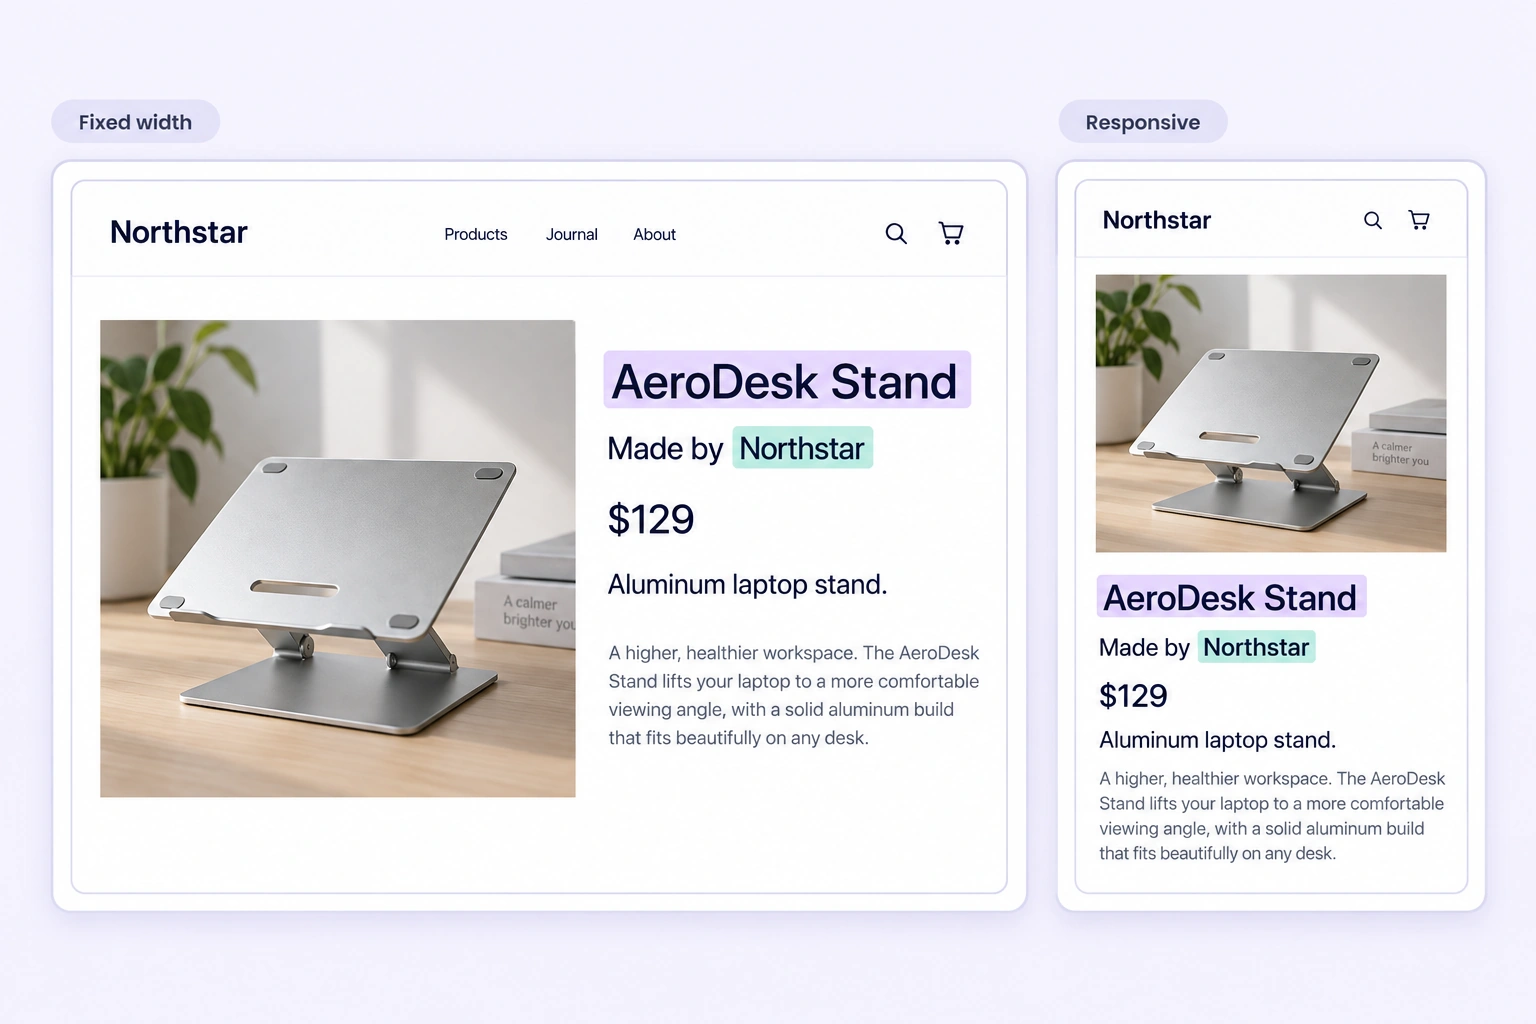
어노테이션 중에도 제목, 표, 이미지, 주변 텍스트를 확인할 수 있습니다. 고정 너비, 화면 맞춤, 반응형 보기로 전환해 저장된 페이지를 편하게 살펴보세요.
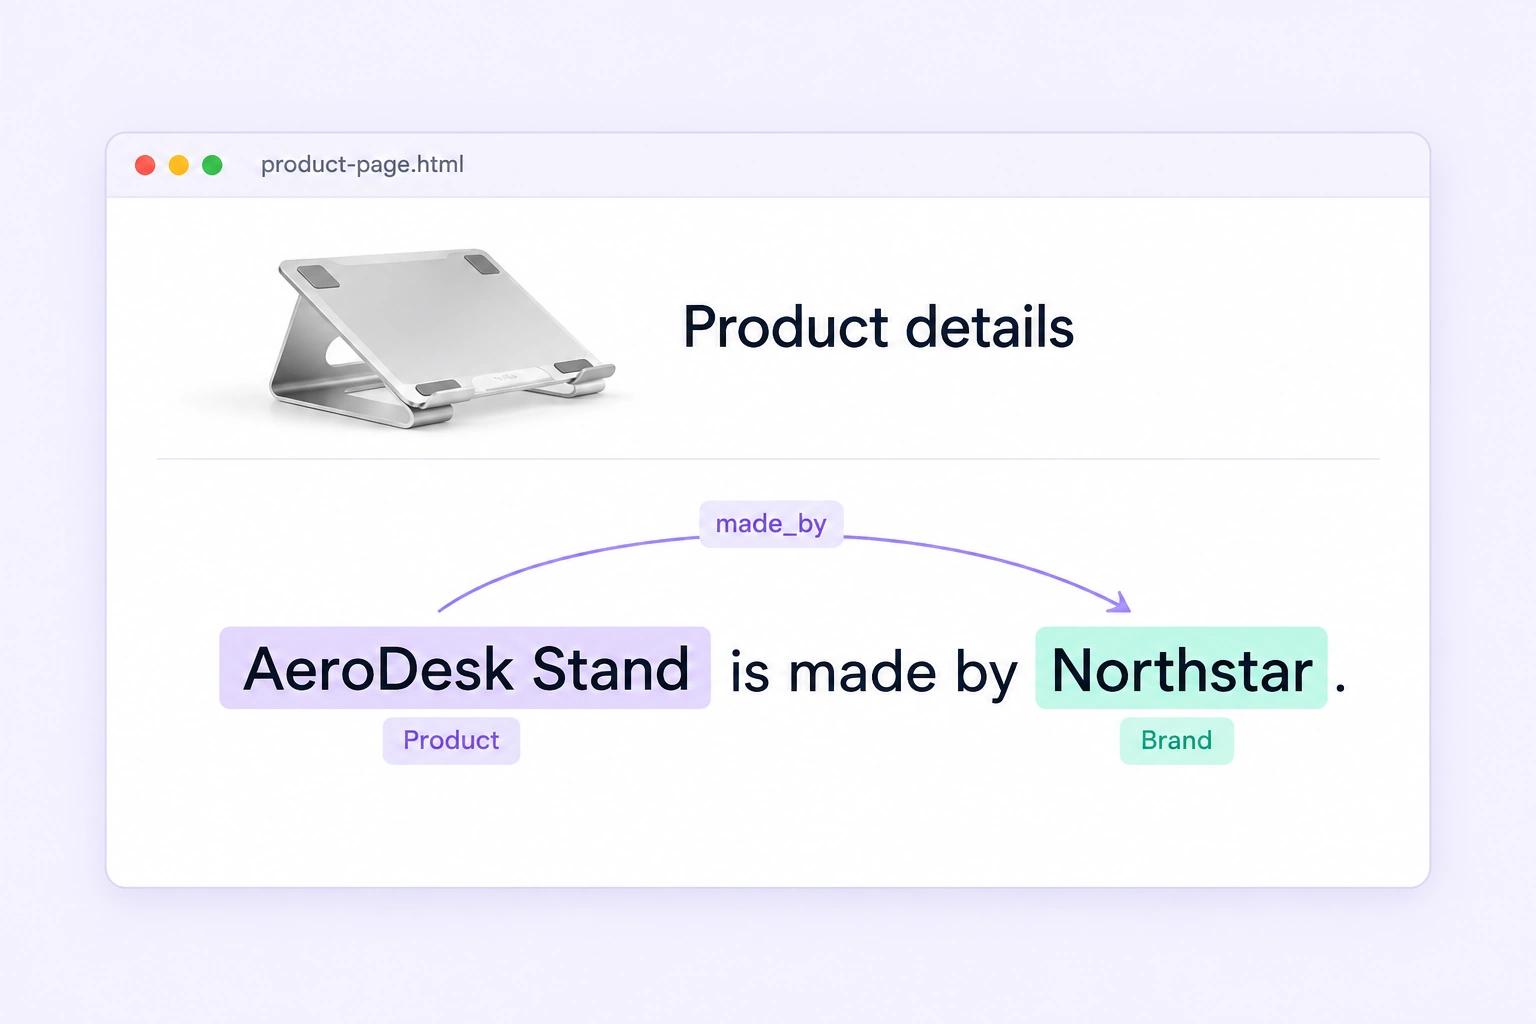
제품과 브랜드, 채용 공고와 고용주처럼 같은 페이지의 라벨링된 엔티티를 연결합니다. 정보 추출 모델에 필요한 관계를 명확하게 표현하세요.
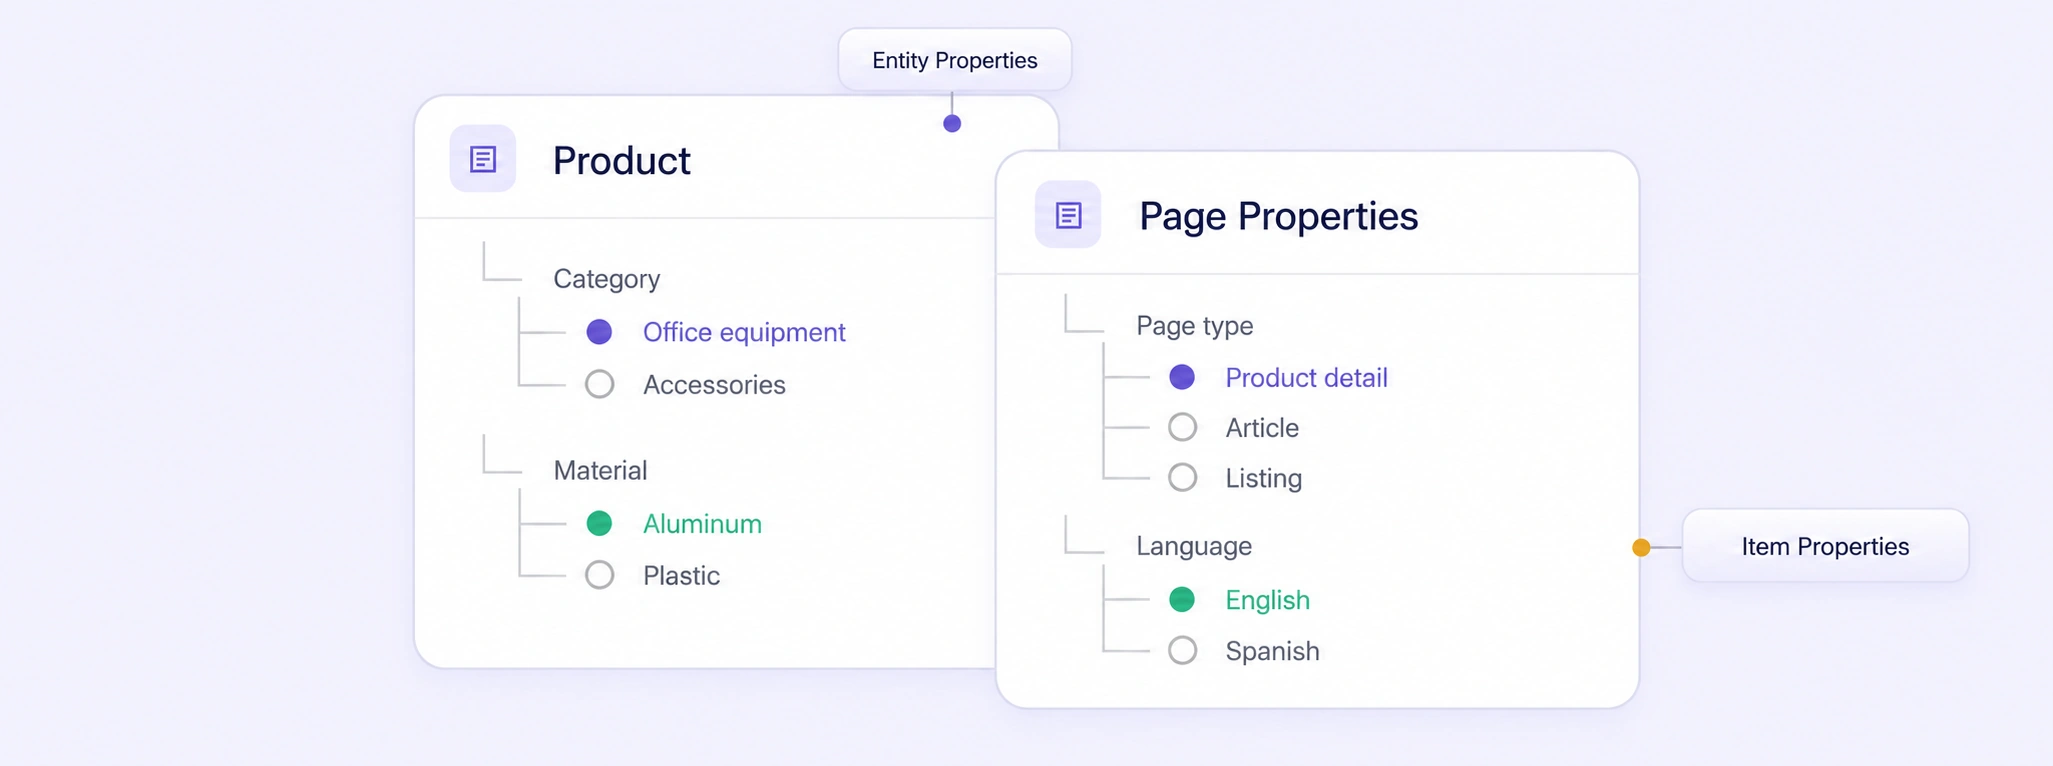
재사용 가능한 엔티티 클래스, 중첩 속성, 페이지 단위 필드, 허용된 관계를 정의합니다. 여러 HTML 데이터셋에서 팀이 같은 라벨링 규칙을 따르도록 유지하세요.
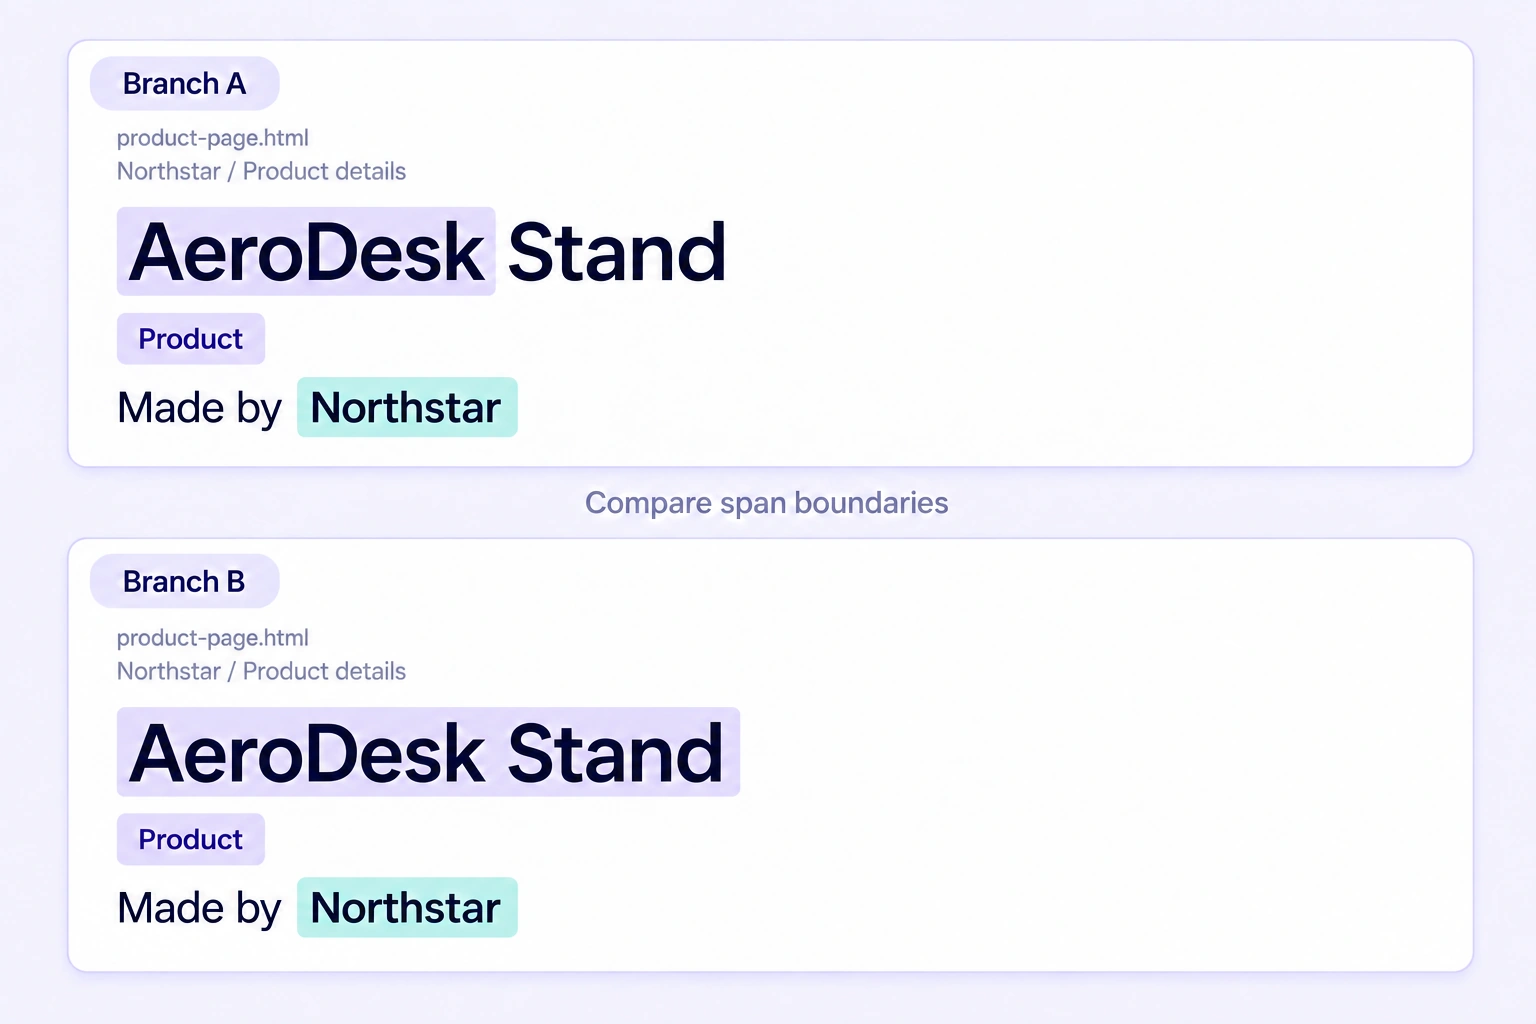
같은 HTML 페이지에 대한 작업자들의 라벨을 비교합니다. 강조된 차이를 확인하고 공통 가이드라인에 따라 의견 차이를 해결하세요.
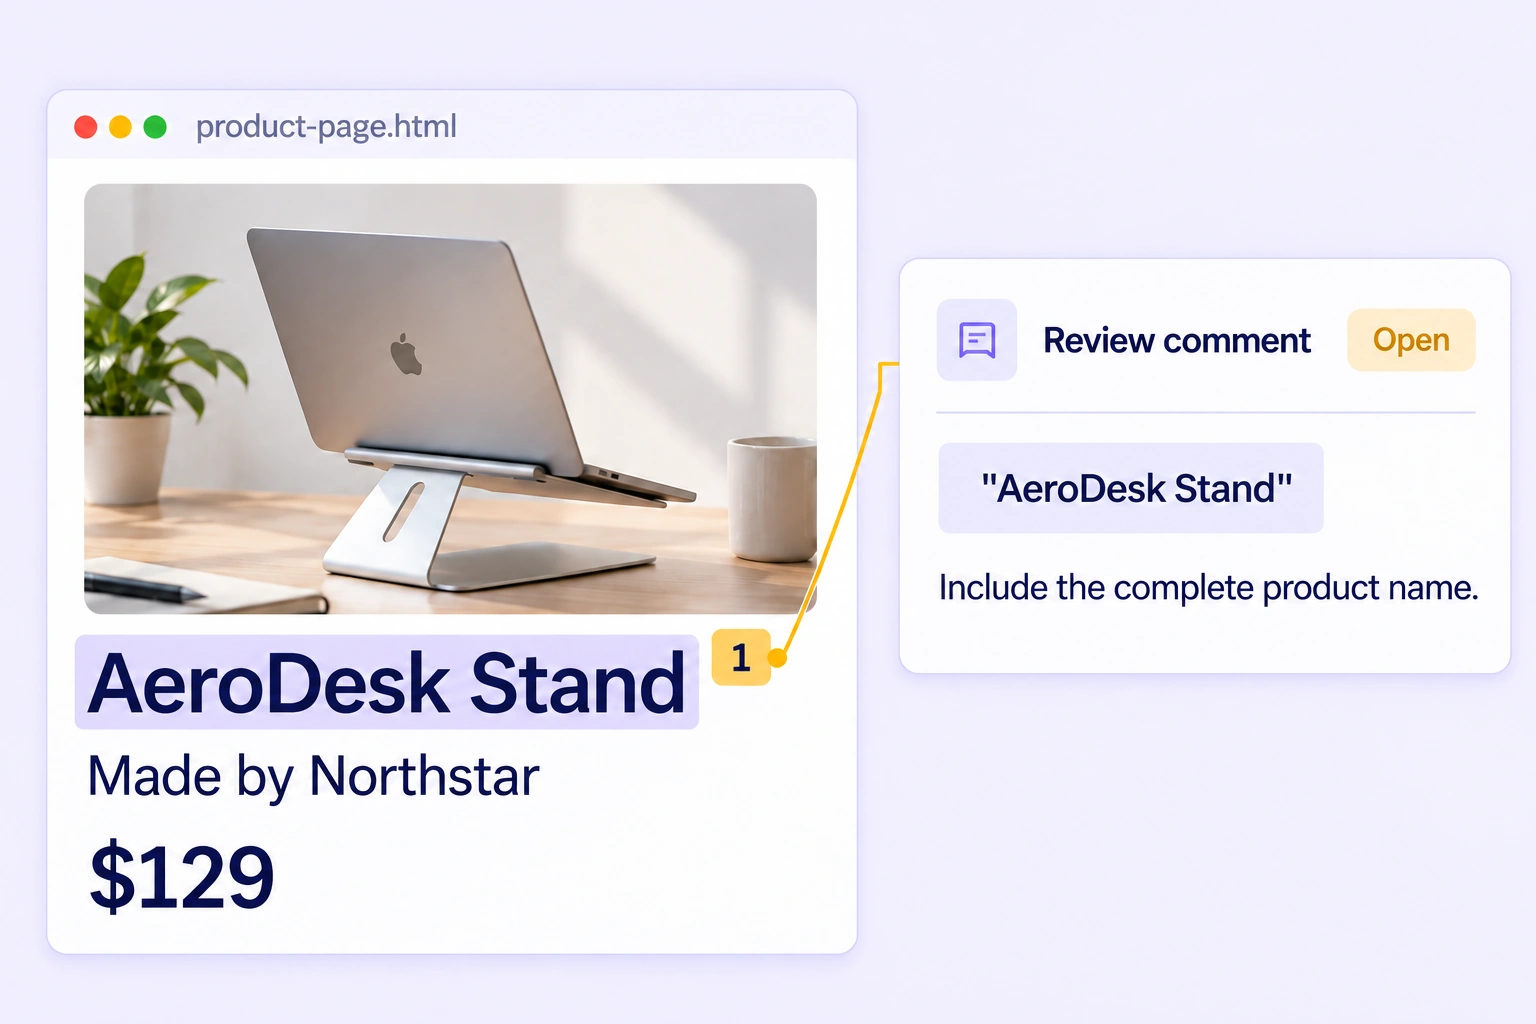
확인이 필요한 텍스트에 바로 피드백을 남깁니다. 검토자는 원본 페이지를 확인하고 수정을 요청하며, 각 어노테이션에 품질 판단을 연결해 기록할 수 있습니다.
HTML 페이지 라벨링, 모호한 사례 검토, 재사용 가능한 학습 데이터셋 관리를 하나의 공간에서 수행합니다.
원본 페이지를 보면서 모델에 필요한 단어, 관계, 맥락 정보를 라벨링합니다.
정확한 단어나 구절을 이름, 가격, 제목, 날짜, 설명 및 작업에서 정의한 기타 엔티티로 라벨링합니다.
라벨링된 텍스트 엔티티를 연결해 제품과 브랜드, 채용 공고와 고용주 등의 관계를 표현합니다.
라벨링된 엔티티에 범주, 상태 등 온톨로지에서 요구하는 구조화된 속성을 추가합니다.
콘텐츠 유형, 주제, 언어, 관련성, 검토 상태 등의 필드로 HTML 페이지 전체를 분류합니다.
저장된 페이지를 정리하고 관련 샘플을 선별합니다. 어노테이션을 검토한 뒤 버전이 지정된 학습 데이터 릴리스로 전달하세요.
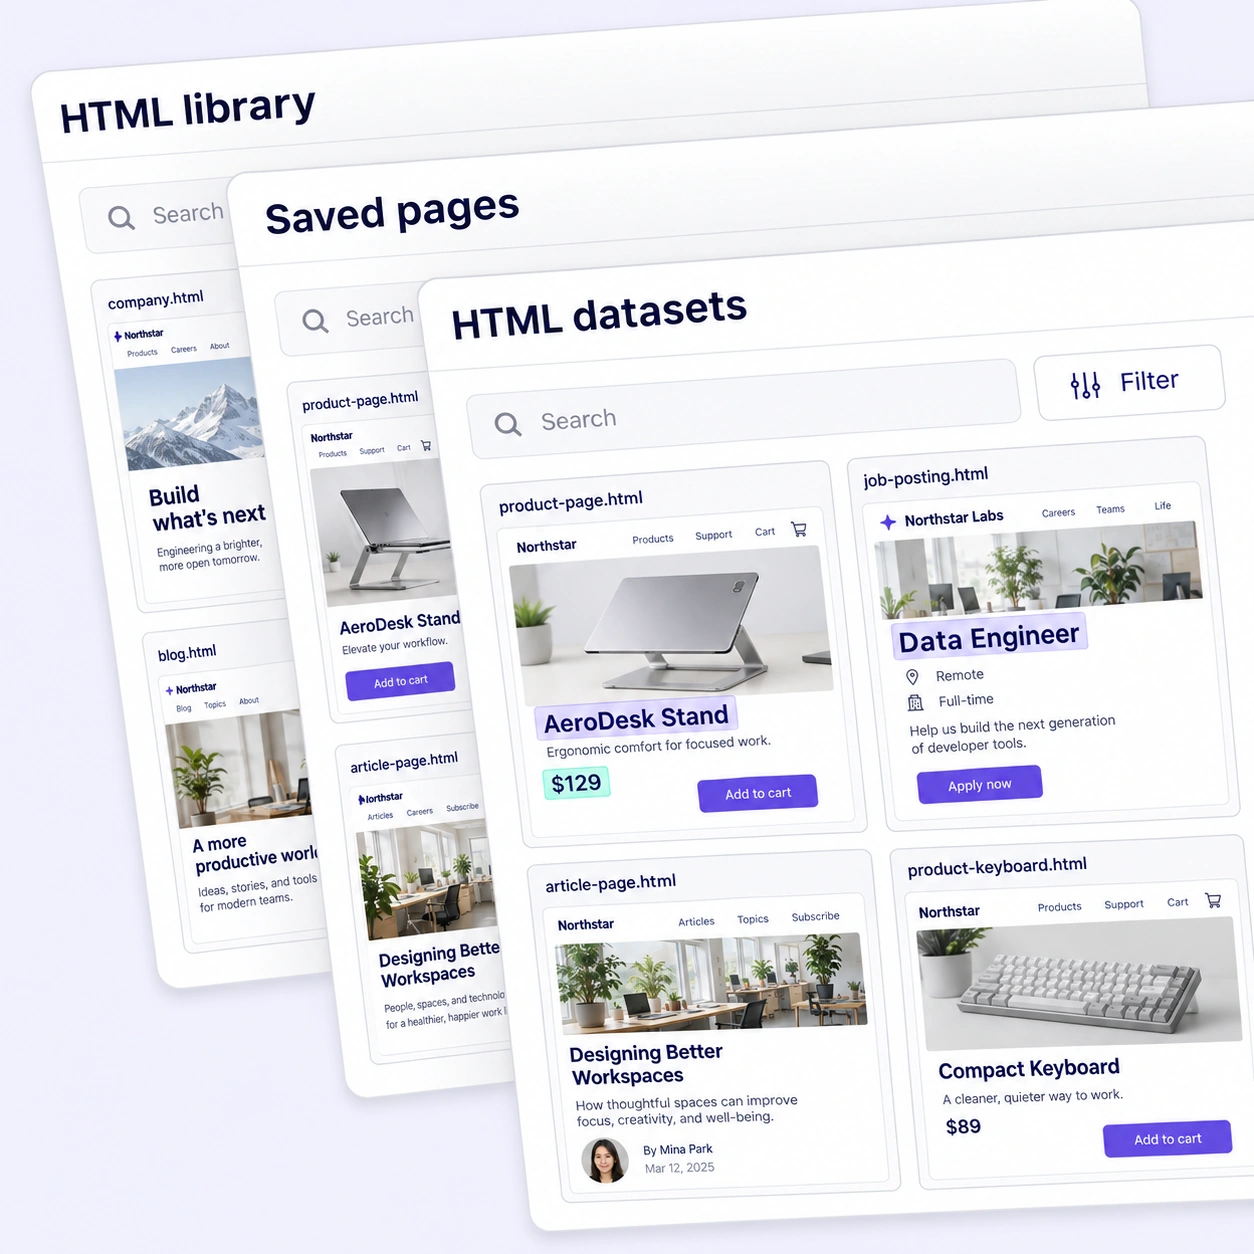
업로드한 HTML 스냅샷을 페이지 미리 보기와 원본 메타데이터가 있는 공유 데이터 공간에 모읍니다. 데이터셋이 커져도 원본 페이지를 체계적으로 관리하세요.
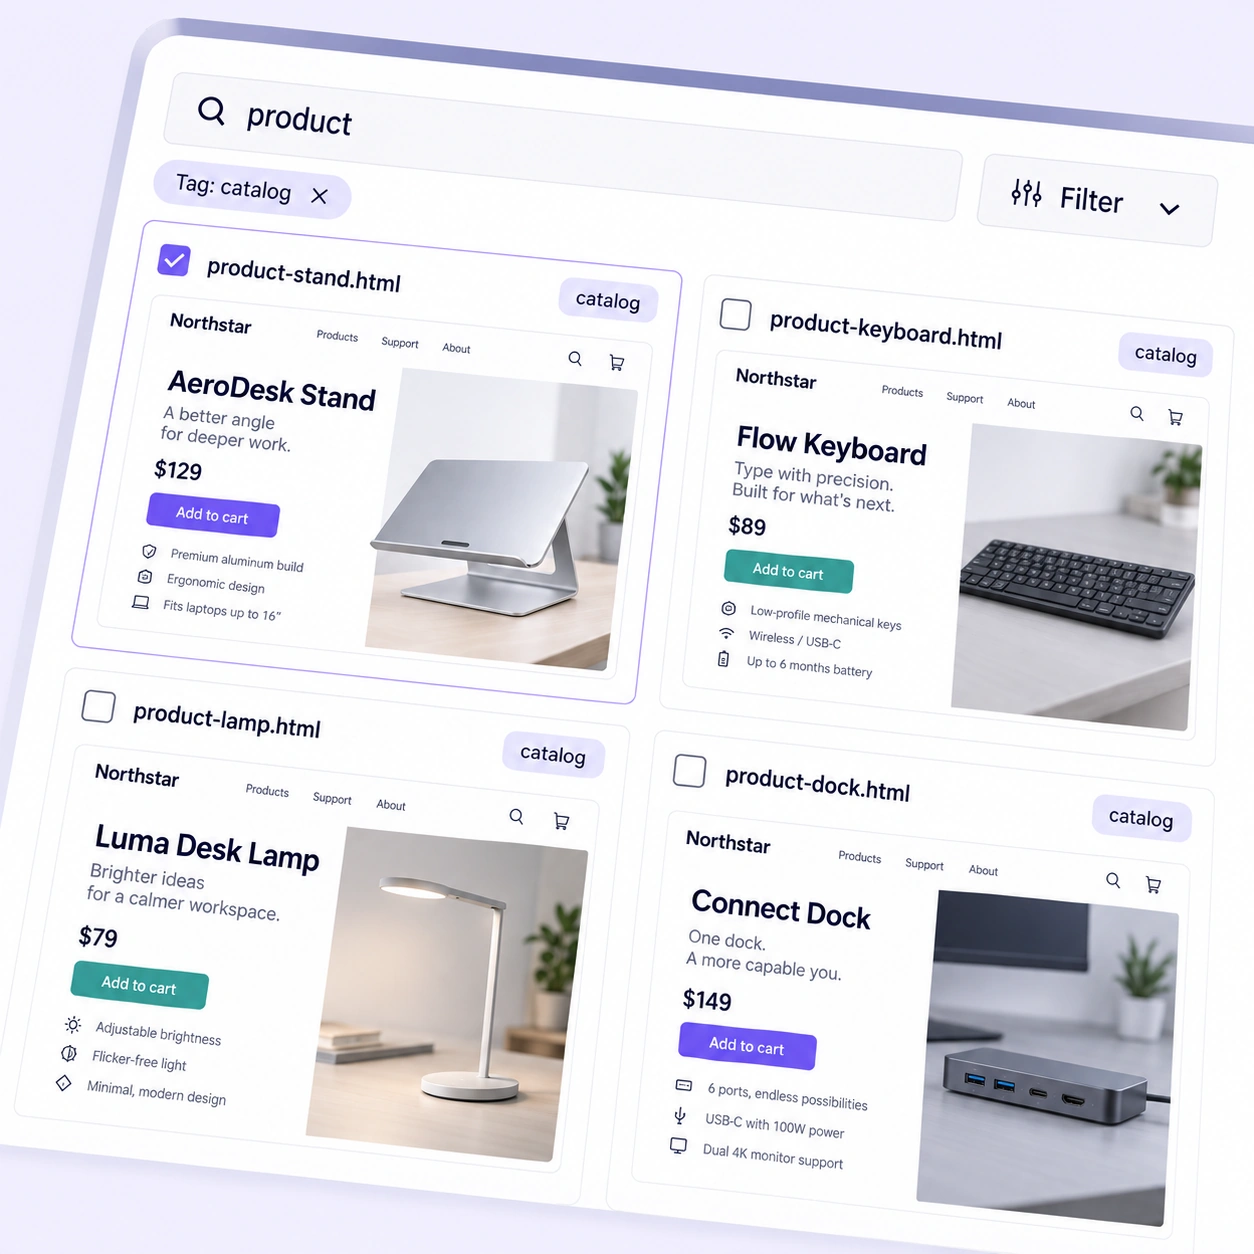
이름, 태그, 폴더, 메타데이터로 저장된 페이지를 찾습니다. 원본 컬렉션에서 어노테이션 작업에 필요한 샘플만 선별하세요.
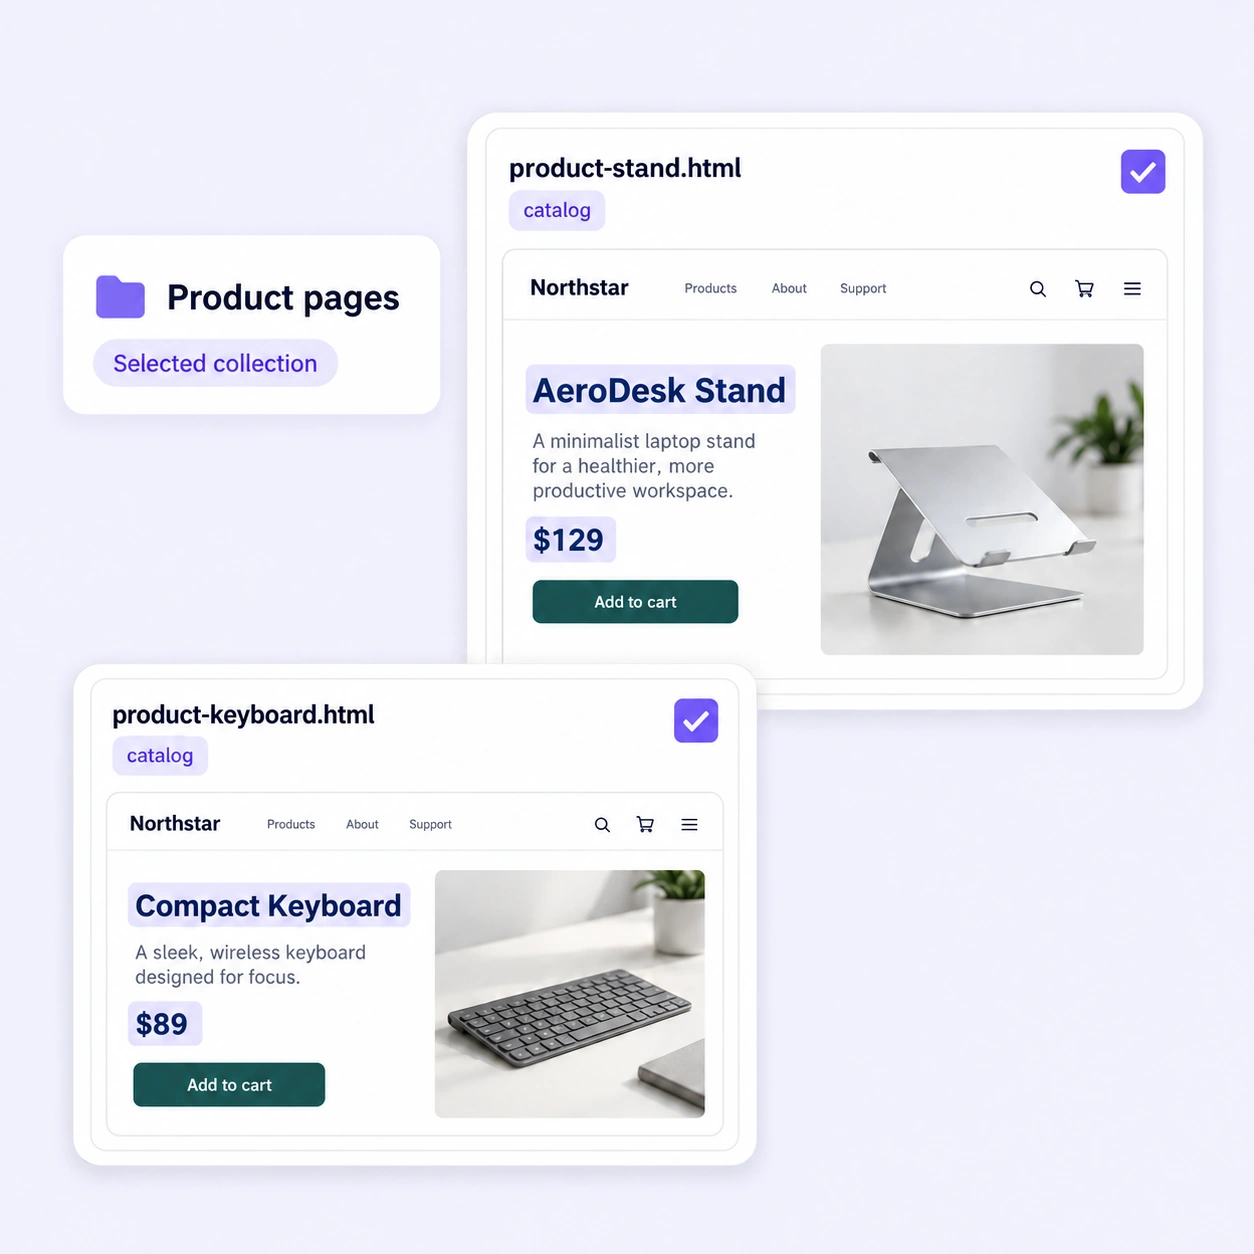
선택한 페이지를 출처, 범주, 작업별로 묶습니다. 작업자에게 전달하기 전에 일관된 샘플 모음을 준비하세요.
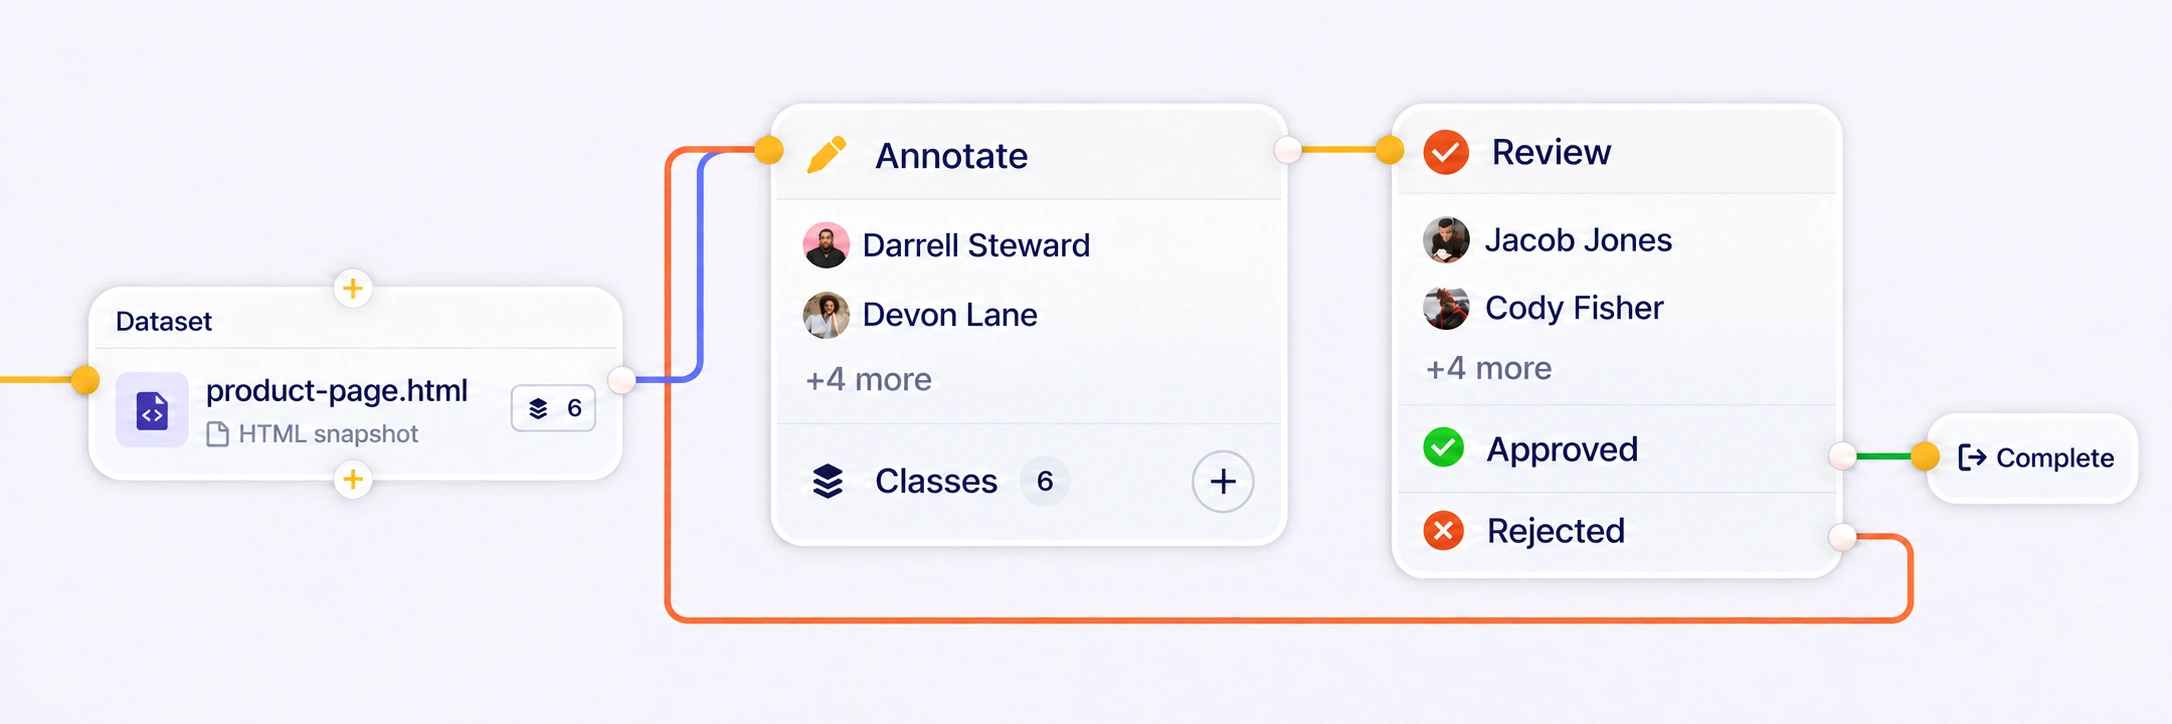
HTML 페이지를 배정하고 공통 지침을 적용하며, 어노테이션, 검토, 재작업 단계로 전달합니다. 검토자와 작업자가 동일한 원본 콘텐츠를 중심으로 협업하도록 연결합니다.
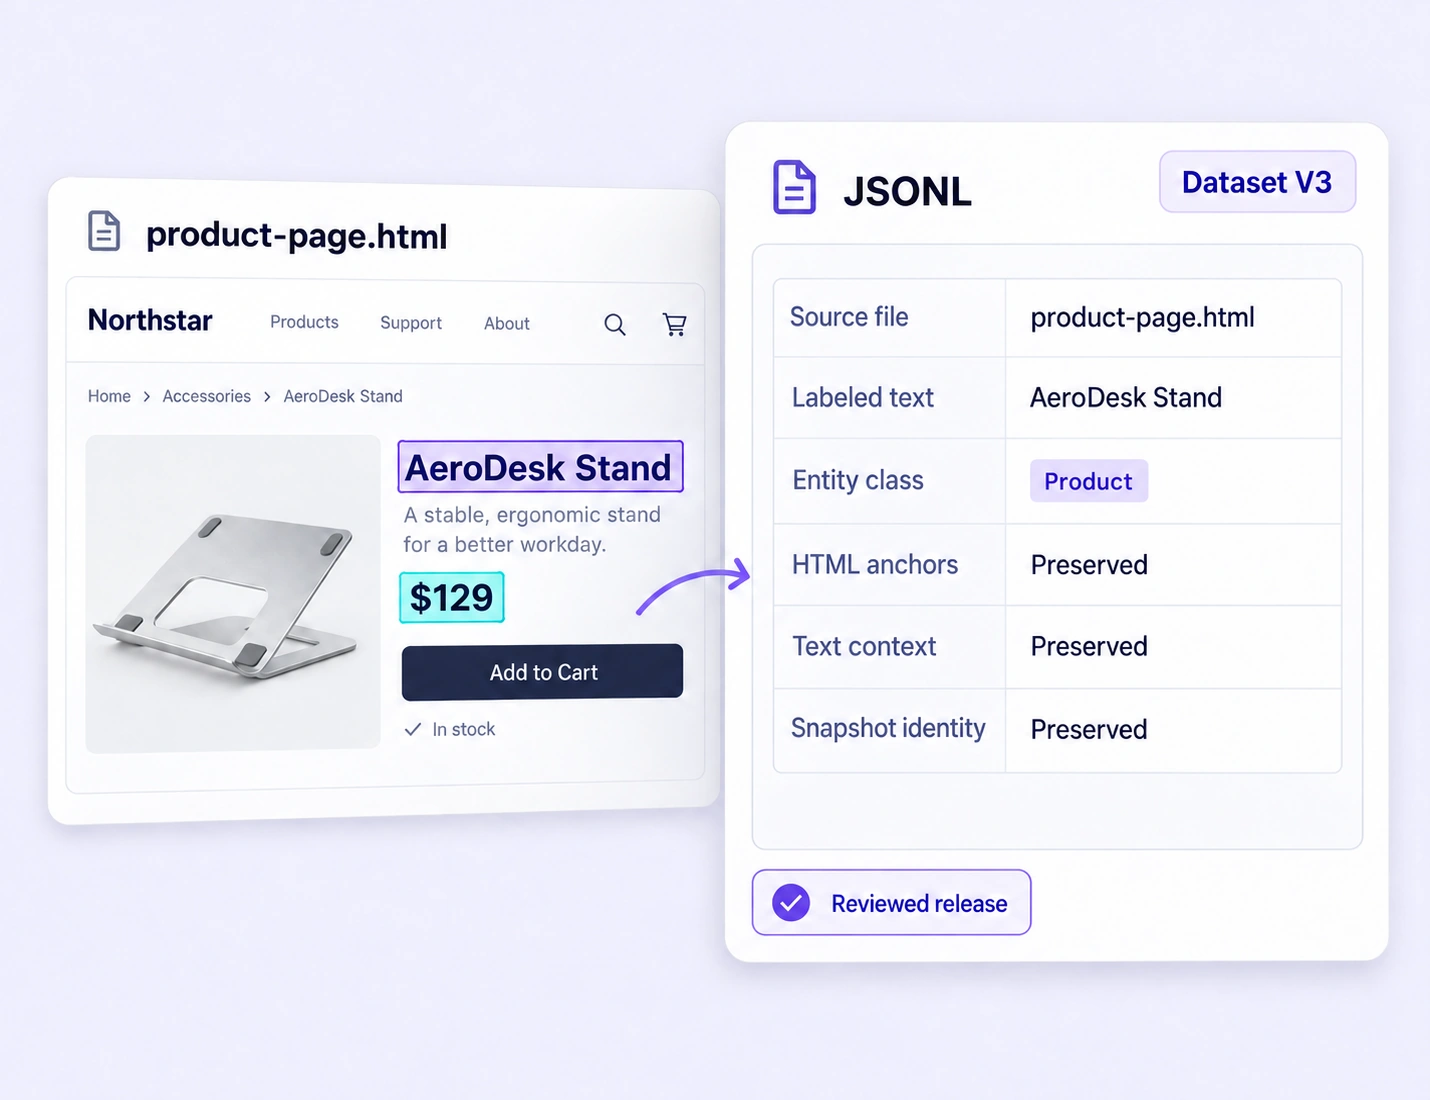
데이터셋 버전으로 원본 페이지를 추적합니다. 검토 후 프로젝트 어노테이션 릴리스를 생성해 라벨을 확정하고 원본 맥락과 함께 내보냅니다. 모든 학습 데이터 전달 이력을 추적할 수 있습니다.
제품 정보, 채용 공고, 유용한 웹 콘텐츠를 위한 검토된 학습 데이터를 구축합니다. 라벨은 실제로 나타나는 페이지에 연결됩니다.
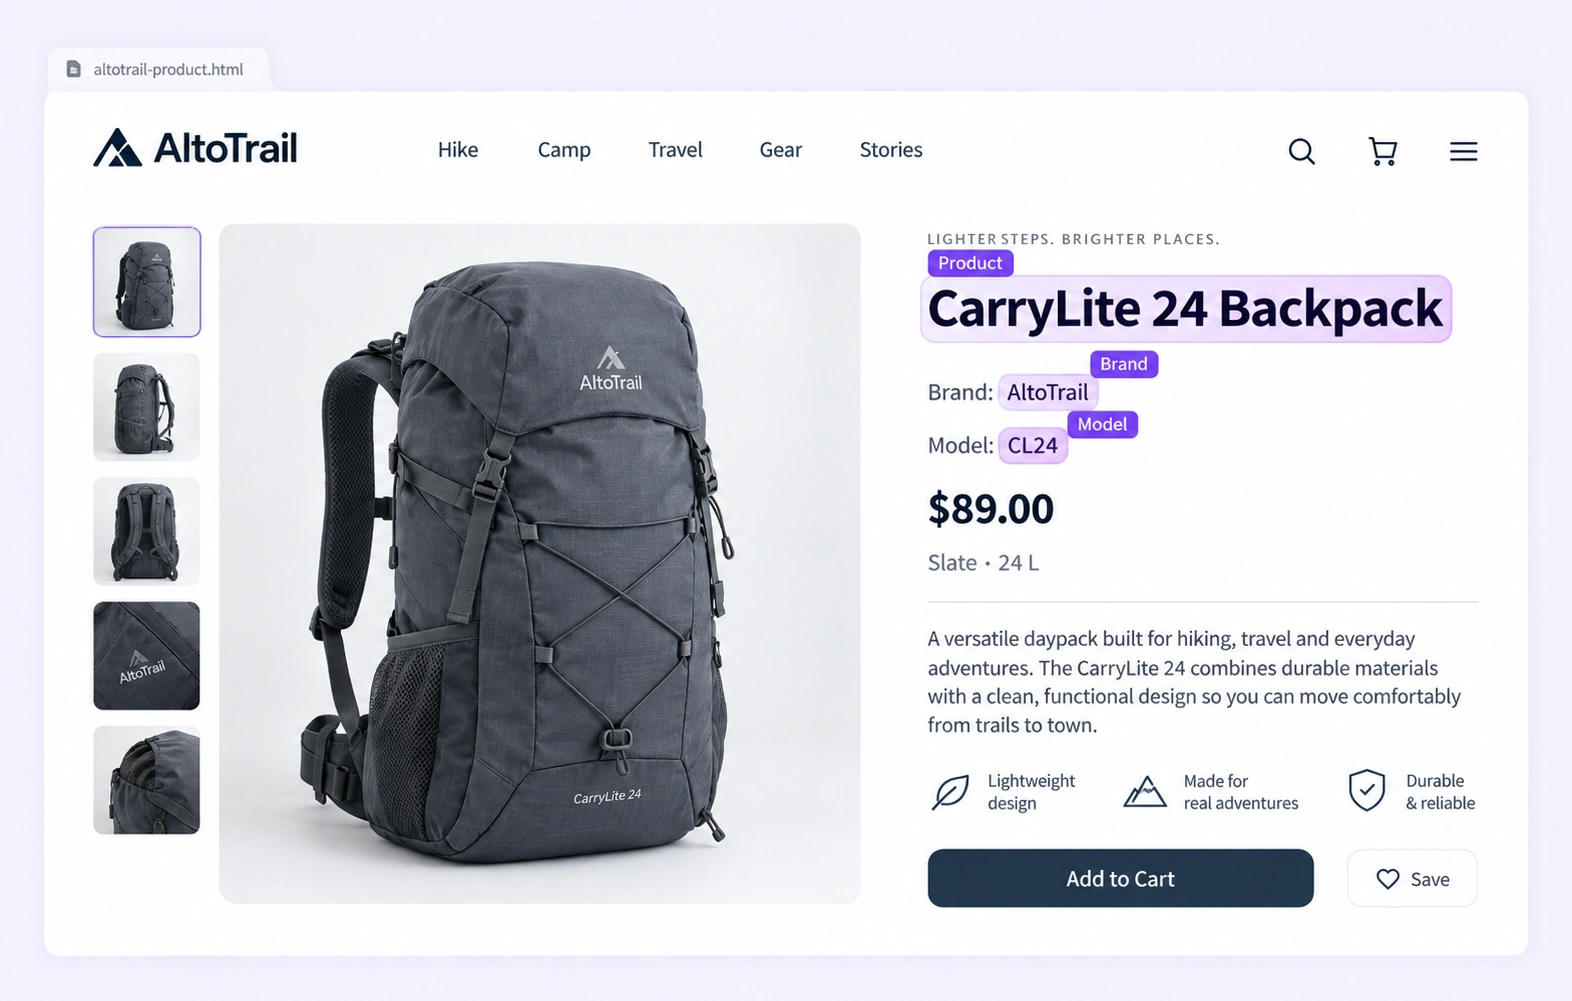
저장된 제품 페이지에서 제품명, 브랜드, 가격, 사양을 라벨링합니다. 상품 카탈로그 추출 모델을 위한 일관된 샘플을 준비하세요.
Explore product-page extraction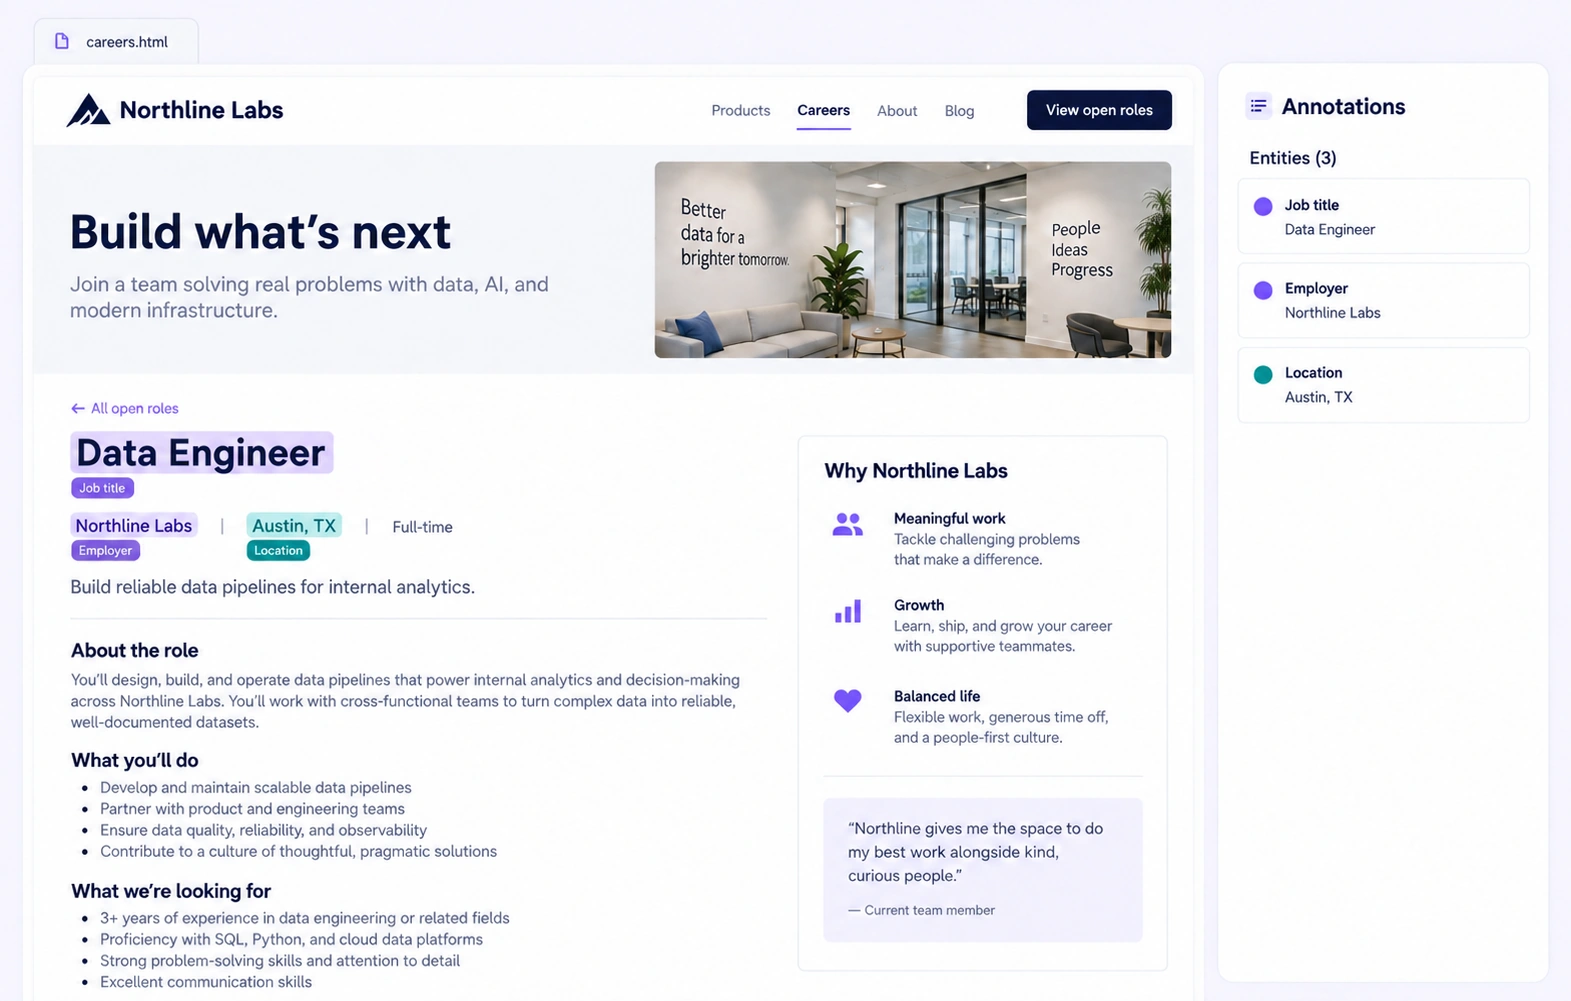
렌더링된 채용 공고에서 직무명, 고용주, 위치, 기술, 자격 요건을 식별합니다. 채용 검색과 매칭을 위한 구조화된 학습 데이터를 구축하세요.
Explore job-posting extraction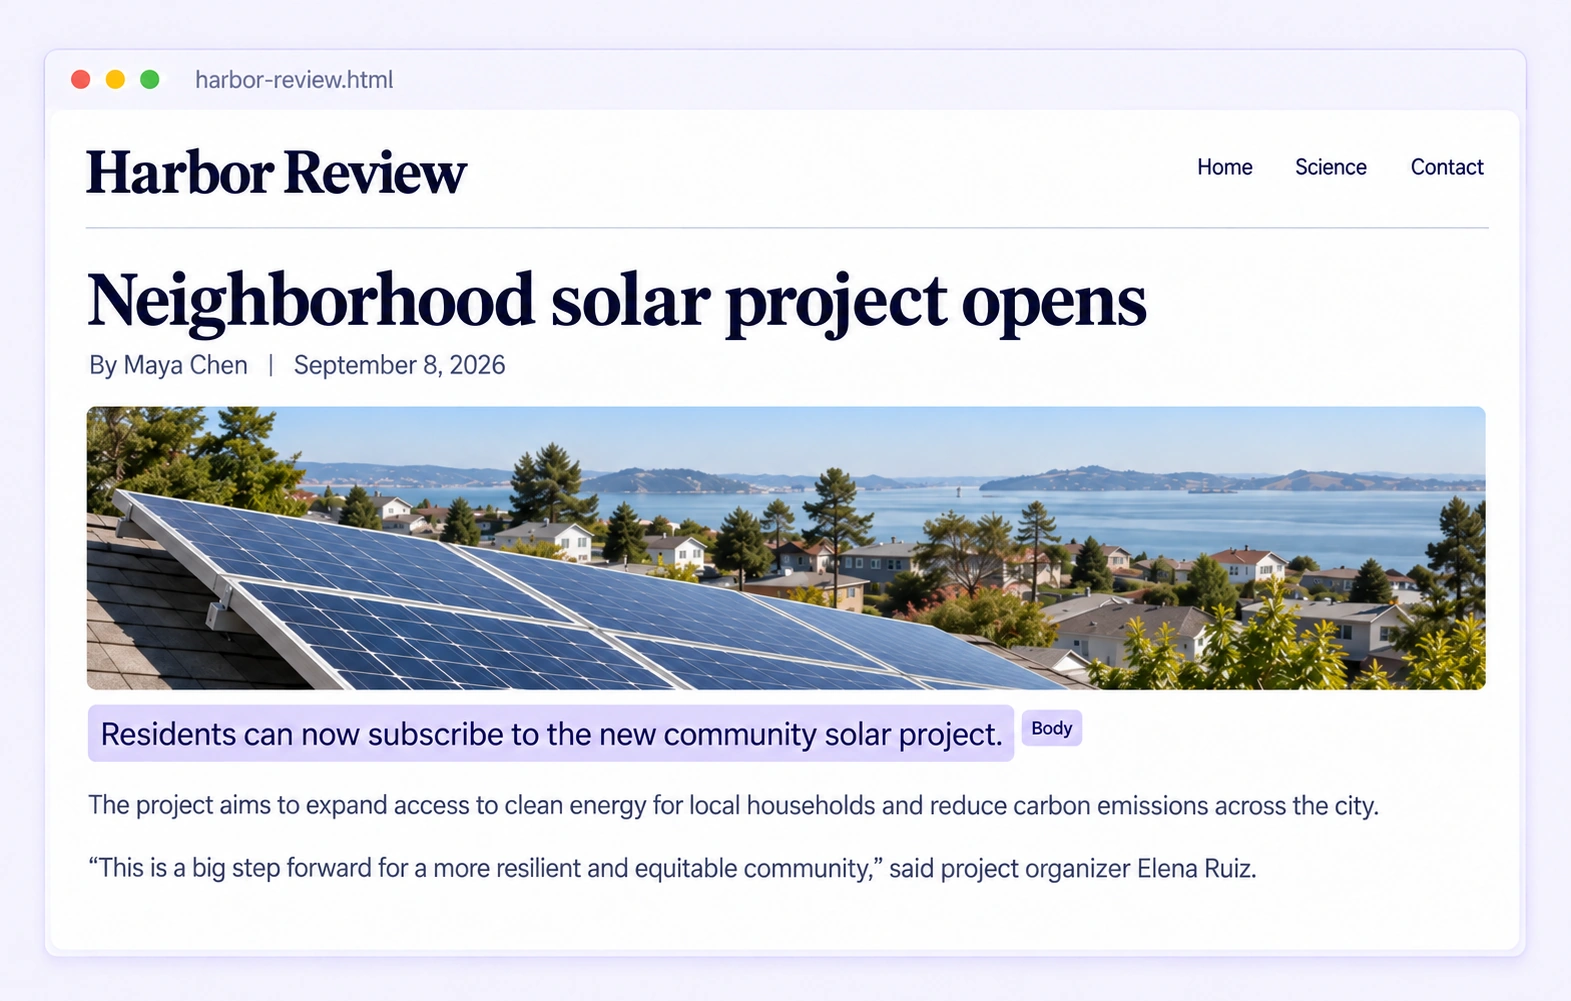
유용한 기사 본문을 주변 페이지 텍스트와 구분합니다. 제목, 작성자, 날짜, 구절을 라벨링해 더 정제된 웹 콘텐츠 데이터셋을 만듭니다.
Explore web-content extraction렌더링된 HTML 라벨링, 페이지 맥락 보존, 온톨로지 정의, 어노테이션 검토, 웹 학습 데이터셋 준비에 대해 알아보세요.
Unitlab 팀과 상담하기HTML 어노테이션은 저장된 웹페이지의 정보에 라벨을 지정해 학습 및 평가 데이터를 만드는 작업입니다. Unitlab에서는 렌더링된 페이지에서 보이는 텍스트를 선택하고, 엔티티를 연결하고, 구조화된 속성을 추가하면서 주변 레이아웃을 보존합니다.
HTML 어노테이션 가이드제품명, 직무명, 가격, 위치, 작성자, 날짜, 기사 구절 등 보이는 텍스트 범위를 라벨링할 수 있습니다. 엔티티 관계는 라벨링된 범위를 연결하고, 클래스 속성은 각 엔티티를 설명하며, 항목 속성은 페이지 전체를 분류합니다.
HTML 어노테이션 가이드네. Unitlab은 업로드된 HTML 스냅샷을 표시하므로 제목, 표, 이미지, 주변 콘텐츠와 함께 텍스트를 해석할 수 있습니다. 고정 너비, 화면 맞춤, 반응형 보기로 동일한 원본 페이지를 편한 크기에서 확인할 수 있습니다.
HTML 어노테이션 가이드공유 온톨로지는 프로젝트 전체에서 사용하는 엔티티 클래스, 속성, 관계를 정의합니다. 구조화된 선택지, 필수 필드, 재사용 가능한 규칙을 통해 서로 다른 페이지 레이아웃의 유사한 콘텐츠에 같은 해석을 적용할 수 있습니다.
온톨로지 문서검토자는 원본 페이지에서 라벨을 확인하고, 원문에 연결된 댓글을 남기고, 수정을 위해 작업을 반려할 수 있습니다. 합의 비교로 작업자 간 차이를 확인하고 공통 지침에 따라 모호한 텍스트 범위나 관계를 정리합니다.
검토 단계네. 데이터 라이브러리, 폴더, 태그, 메타데이터, 필터로 업로드된 HTML 페이지를 정리하고 작업에 필요한 샘플을 선택합니다. 큐레이션된 컬렉션과 데이터셋 버전으로 어노테이션 및 검토 과정에서 선택한 원본 모음을 추적할 수 있습니다.
데이터 큐레이션 가이드데이터셋 버전으로 선택한 원본 페이지를 추적합니다. 검토 후 프로젝트 어노테이션 릴리스를 생성해 라벨을 확정한 다음, JSONL이나 Unitlab의 기본 UUEF 형식으로 내보냅니다. HTML 내보내기는 라벨링된 텍스트, 엔티티 속성, 관계, 스냅샷 식별 정보, 텍스트 앵커를 보존합니다.
내보내기 문서


