웹 콘텐츠 추출을 위한 HTML 어노테이션

페이지의 본문과 탐색 메뉴 또는 홍보 텍스트를 구분하는 예시를 콘텐츠 추출 모델에 제공하세요. 렌더링된 HTML 스냅샷의 원문 구간과 기사 메타데이터를 라벨링하고 사람이 검토합니다.
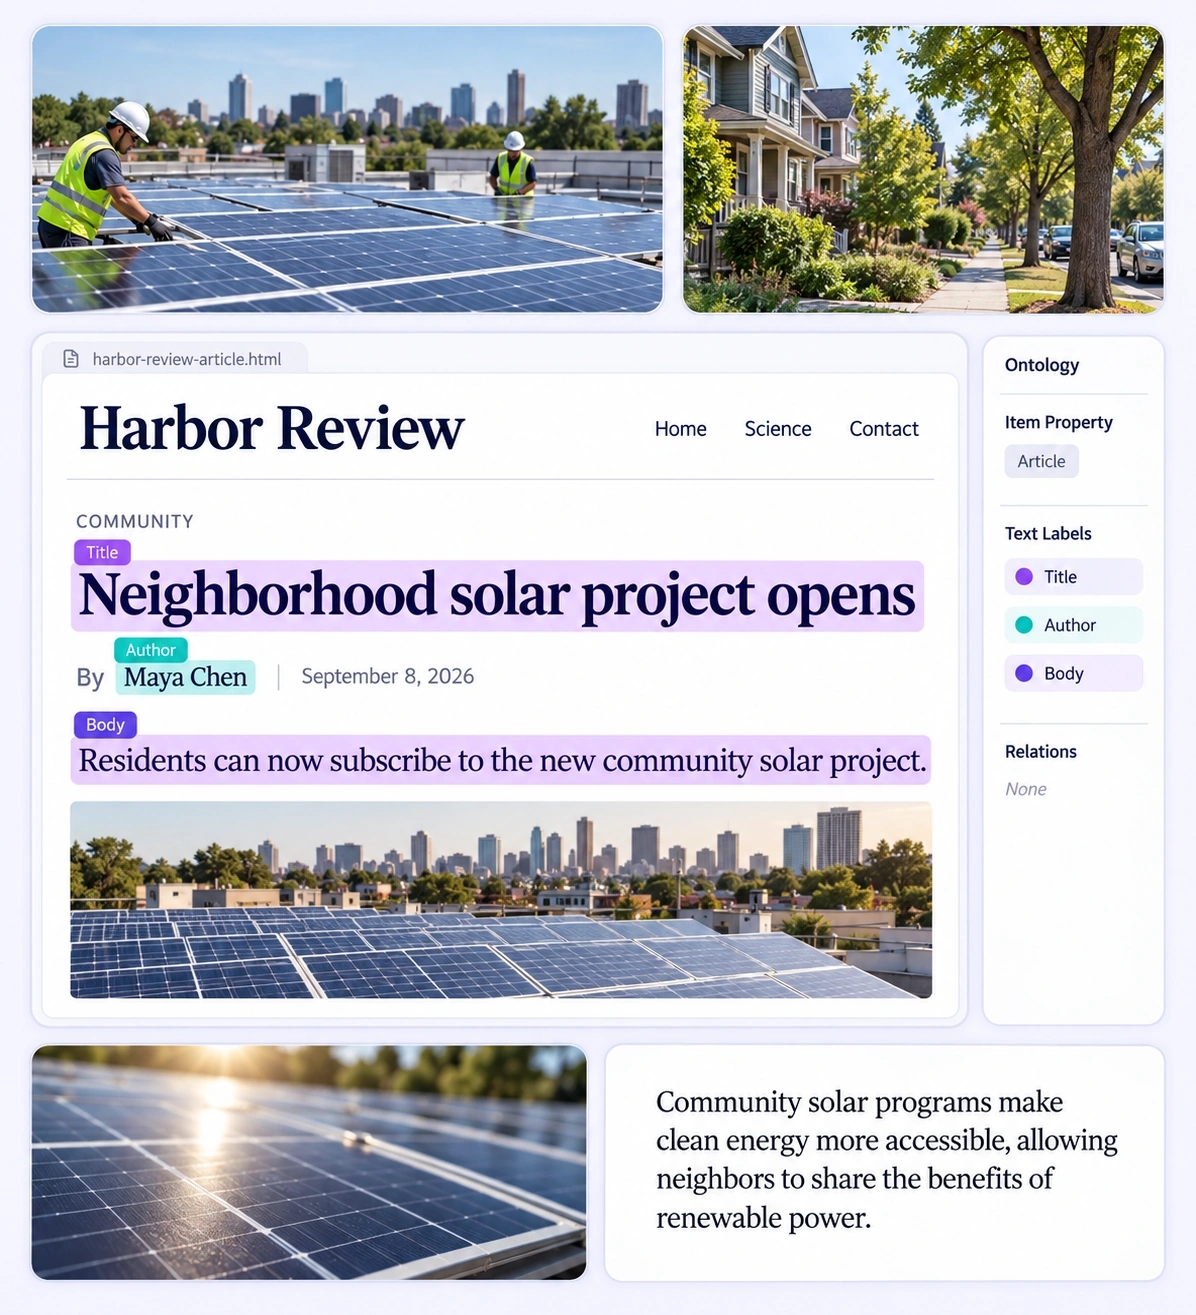
Editorial HTML collage with main content and metadata labels

유용한 콘텐츠와 주변 페이지 텍스트 구분

원본 맥락을 보존하면서 기사, 가이드, 편집 콘텐츠 웹페이지의 추출을 위한 명확한 예시를 구축합니다.
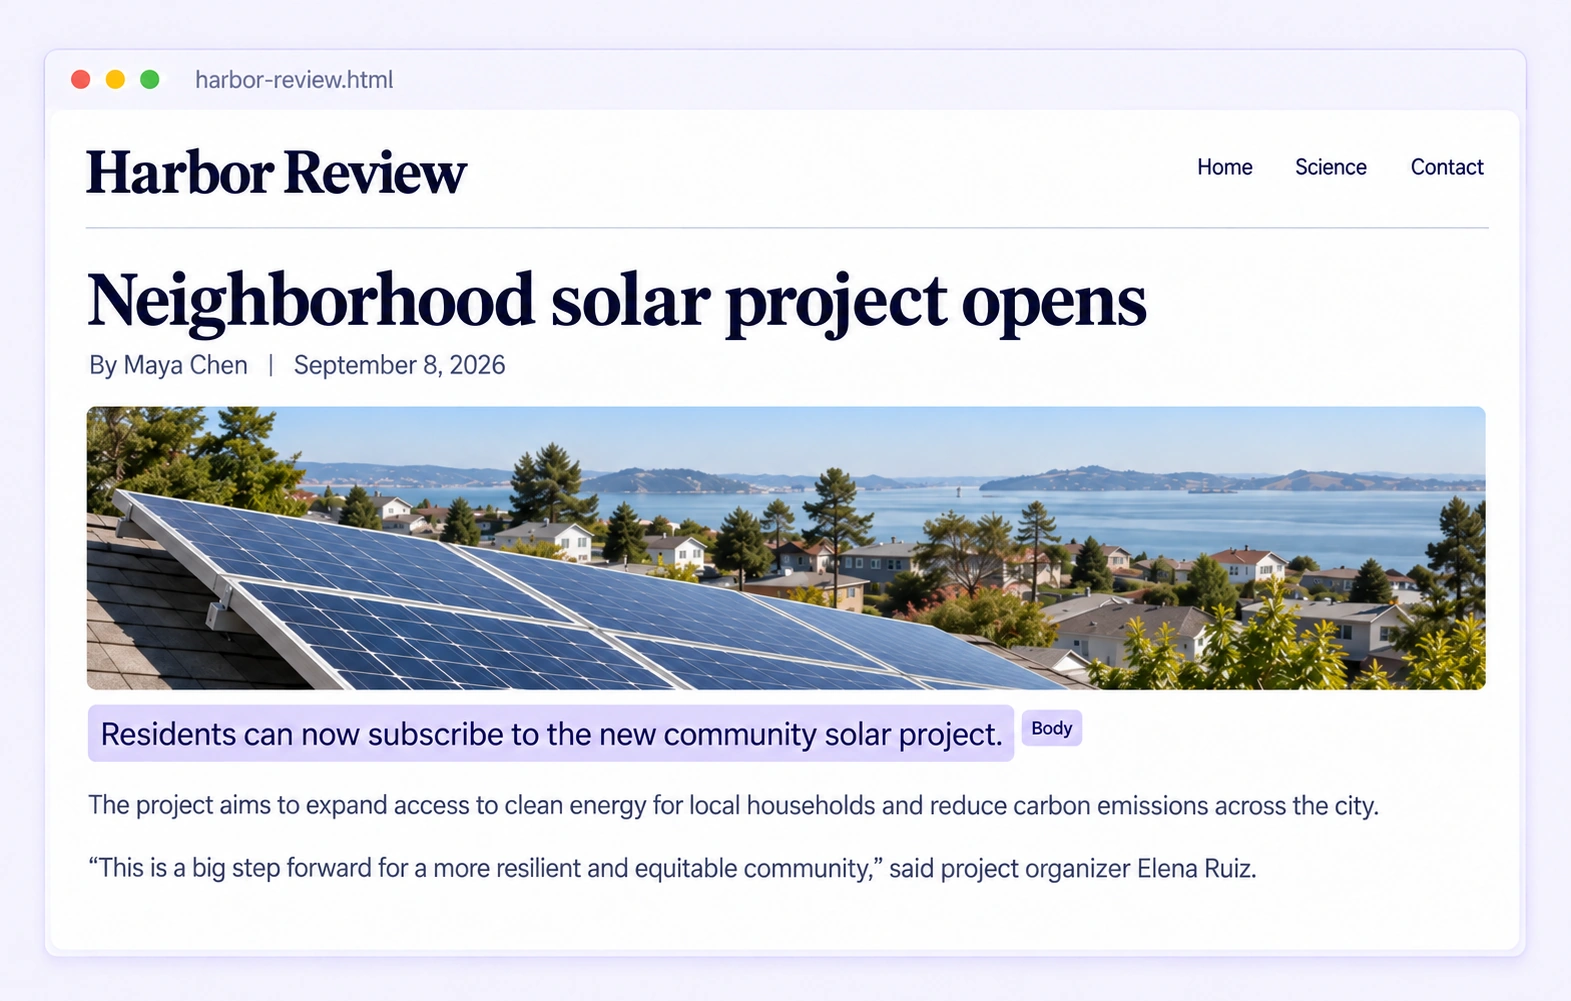
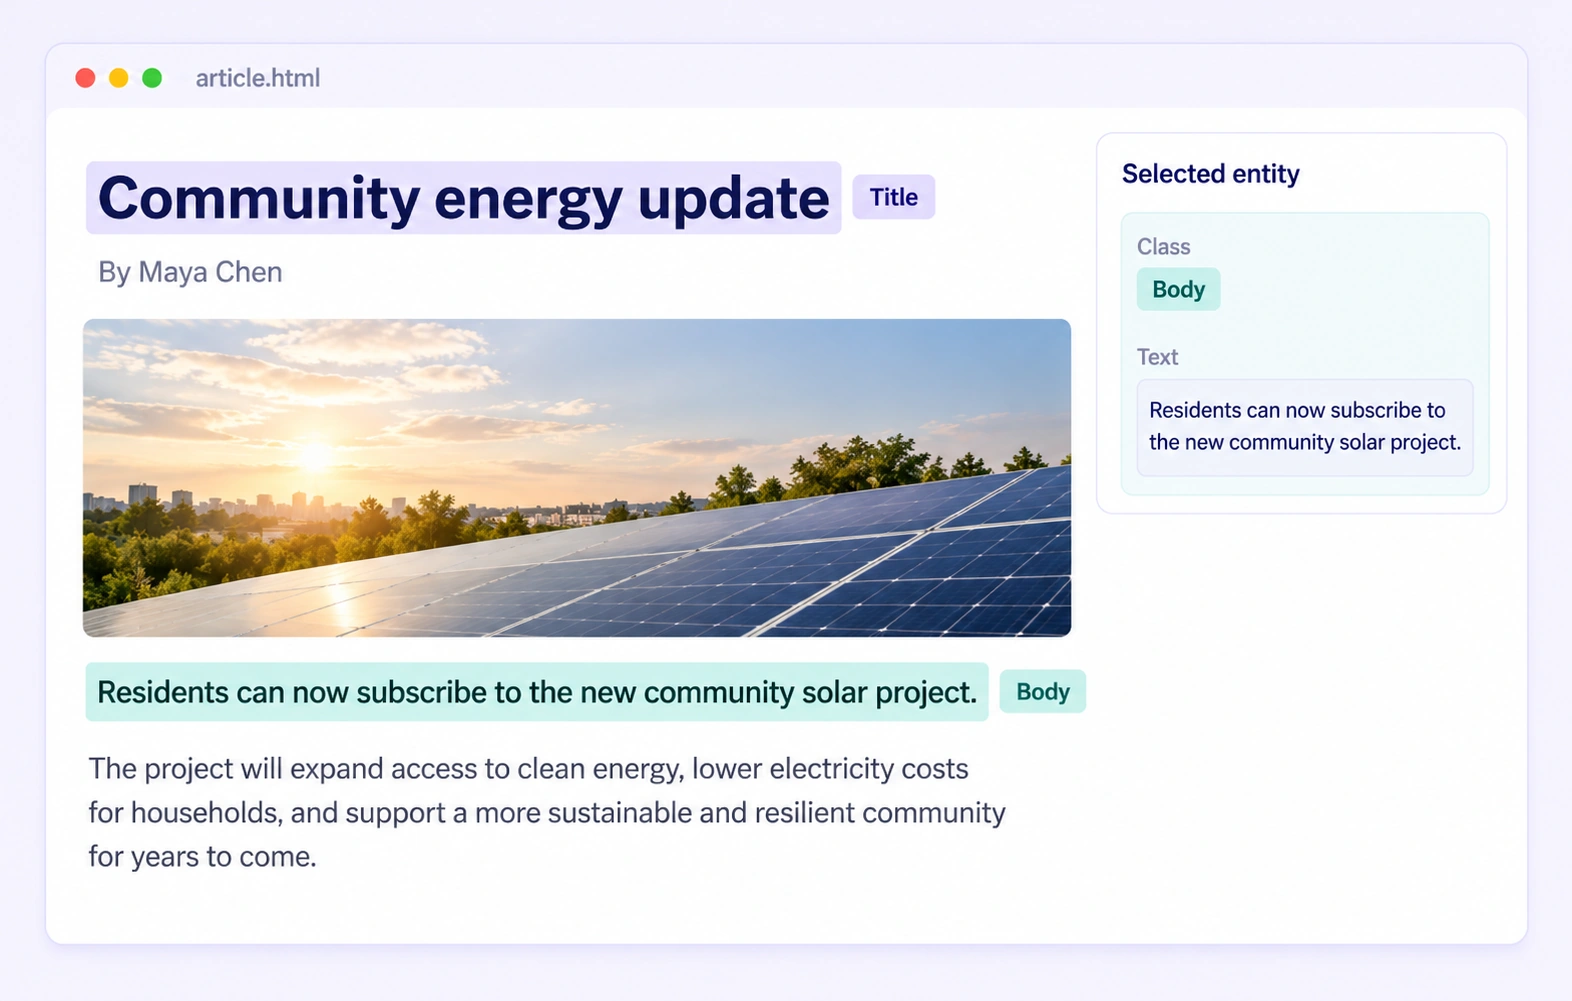
Article main-body text selected within a rendered HTML source

본문 텍스트

기사나 가이드에 속하는 가시 문단을 표시합니다. 일관된 경계로 대상 콘텐츠를 포함하고 인접한 탐색 메뉴나 홍보 문구는 제외합니다.
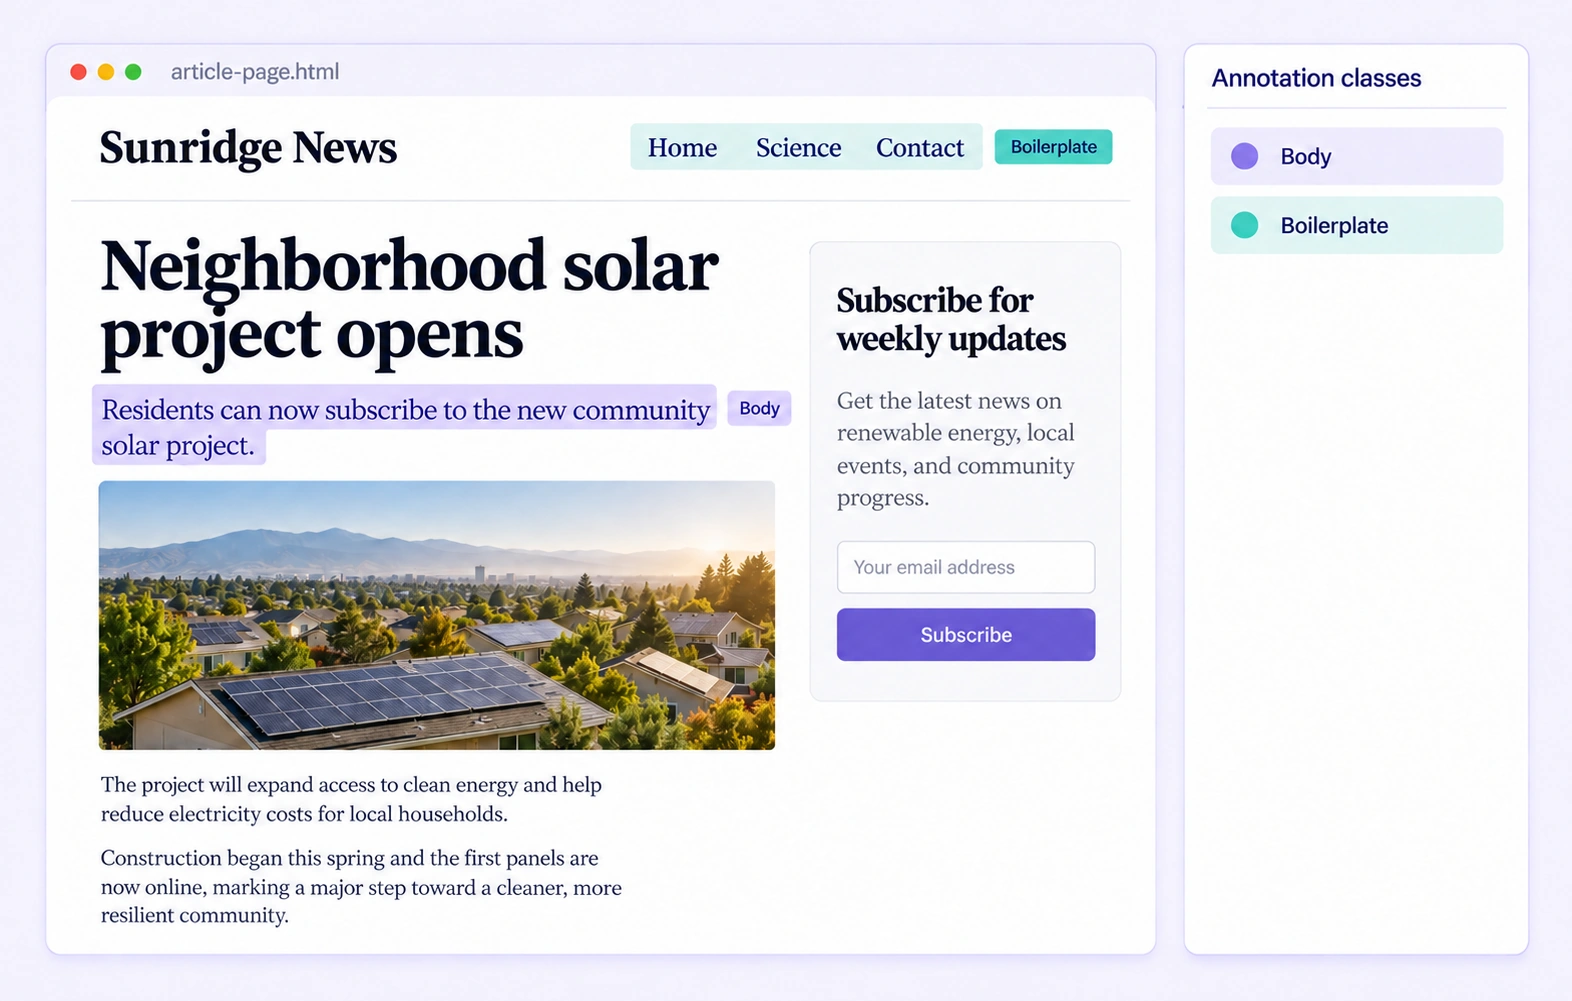
Main content and excluded navigation text shown as separate source spans

상용구 제외

탐색 메뉴, 구독 안내, 기타 제외할 텍스트를 본문과 별도로 라벨링합니다. 모호한 페이지 영역의 포함 기준은 프로젝트 지침에 정의합니다.
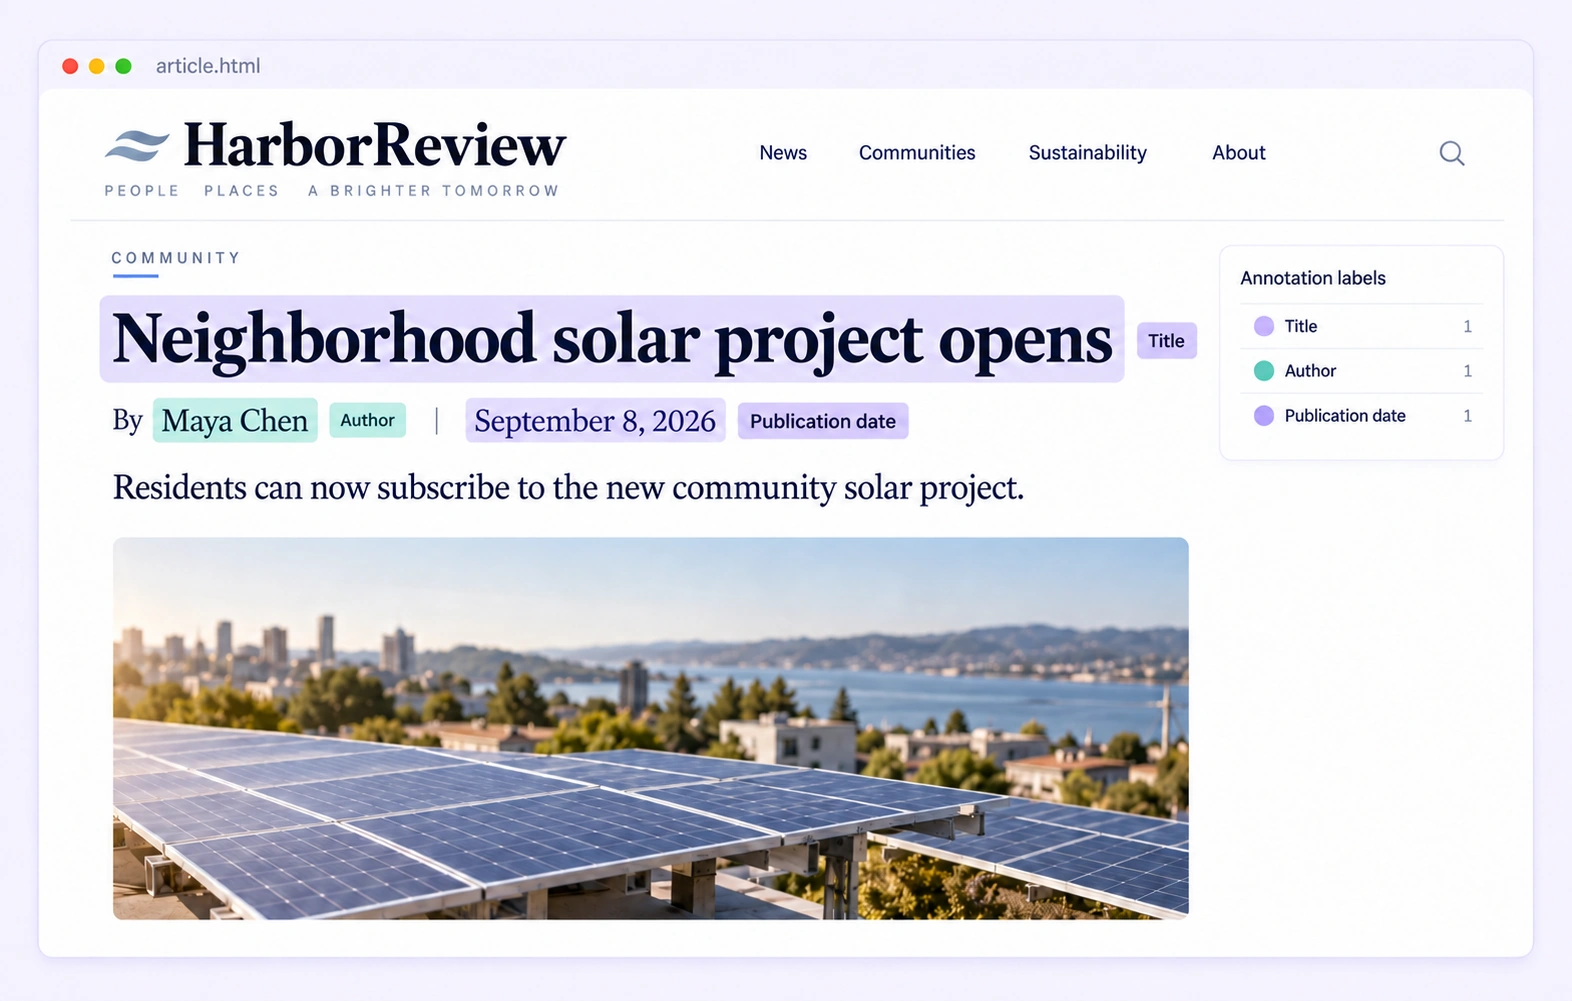
Article title author and publication date as separate HTML entities

기사 메타데이터

렌더링된 페이지에서 제목, 작성자, 게시 날짜를 식별합니다. 해당 기사의 메타데이터를 관련 기사 카드나 푸터 텍스트와 구분합니다.
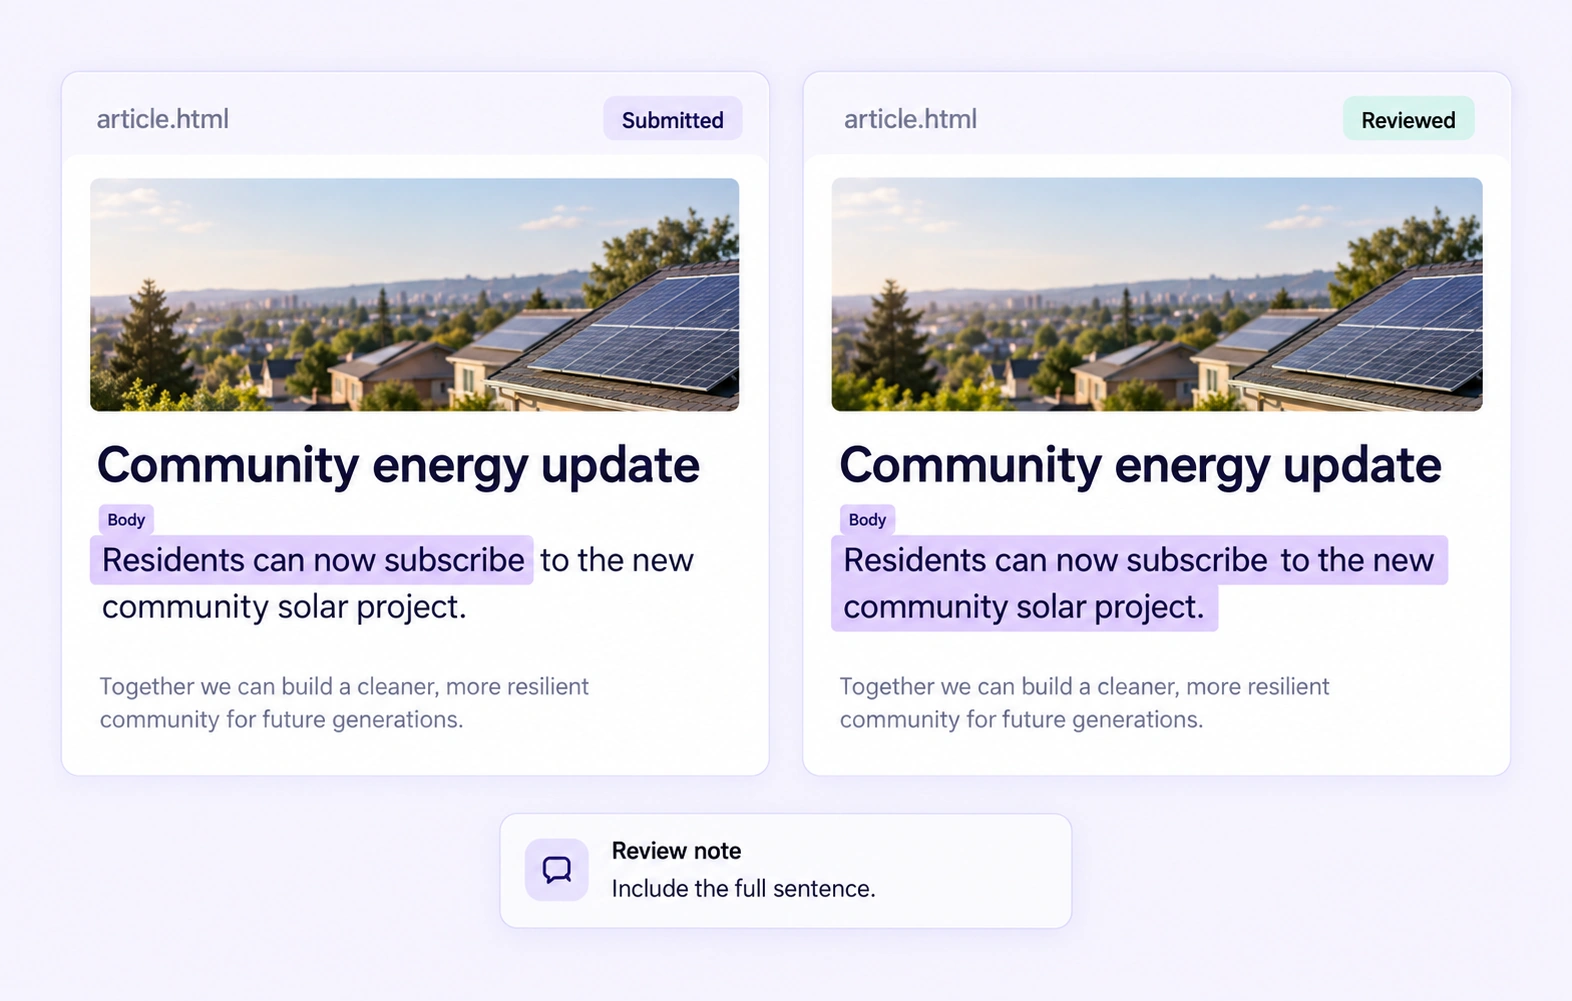
A corrected content span includes the complete sentence

콘텐츠 경계 검토

선택한 콘텐츠의 시작과 끝을 원본 페이지와 비교합니다. 예시를 승인하기 전에 잘린 문장, 포함된 홍보 문구, 잘못된 텍스트 위치를 수정합니다.

AI 팀이 Unitlab을 선택하는 이유

HTML 원본 맥락, 공유 온톨로지, 사람의 검토, 데이터셋 전달을 학습 데이터 팀의 하나의 워크플로로 연결합니다.
15X
더 빠른 HTML 어노테이션
60%
AI 엔지니어의 시간 절약
5X
AI 개발 비용 절감

웹 콘텐츠 추출의 어노테이션 유형

겹치지 않는 콘텐츠 구간에 원본과 작업을 설명하는 페이지 수준 속성을 결합합니다.
Precise non-overlapping text-span labels on an editorial webpage

콘텐츠 및 메타데이터 구간

본문이나 메타데이터의 연속된 가시 텍스트 범위를 하나씩 라벨링합니다. 라벨은 겹치지 않게 유지하고 프로젝트의 경계 규칙으로 인접 텍스트의 역할을 구분합니다.

페이지 수준 속성

내부 텍스트 어노테이션을 유지하면서 페이지 유형, 언어 등의 속성으로 전체 HTML 항목을 분류합니다. 이러한 값은 저장된 원본 페이지를 설명합니다.
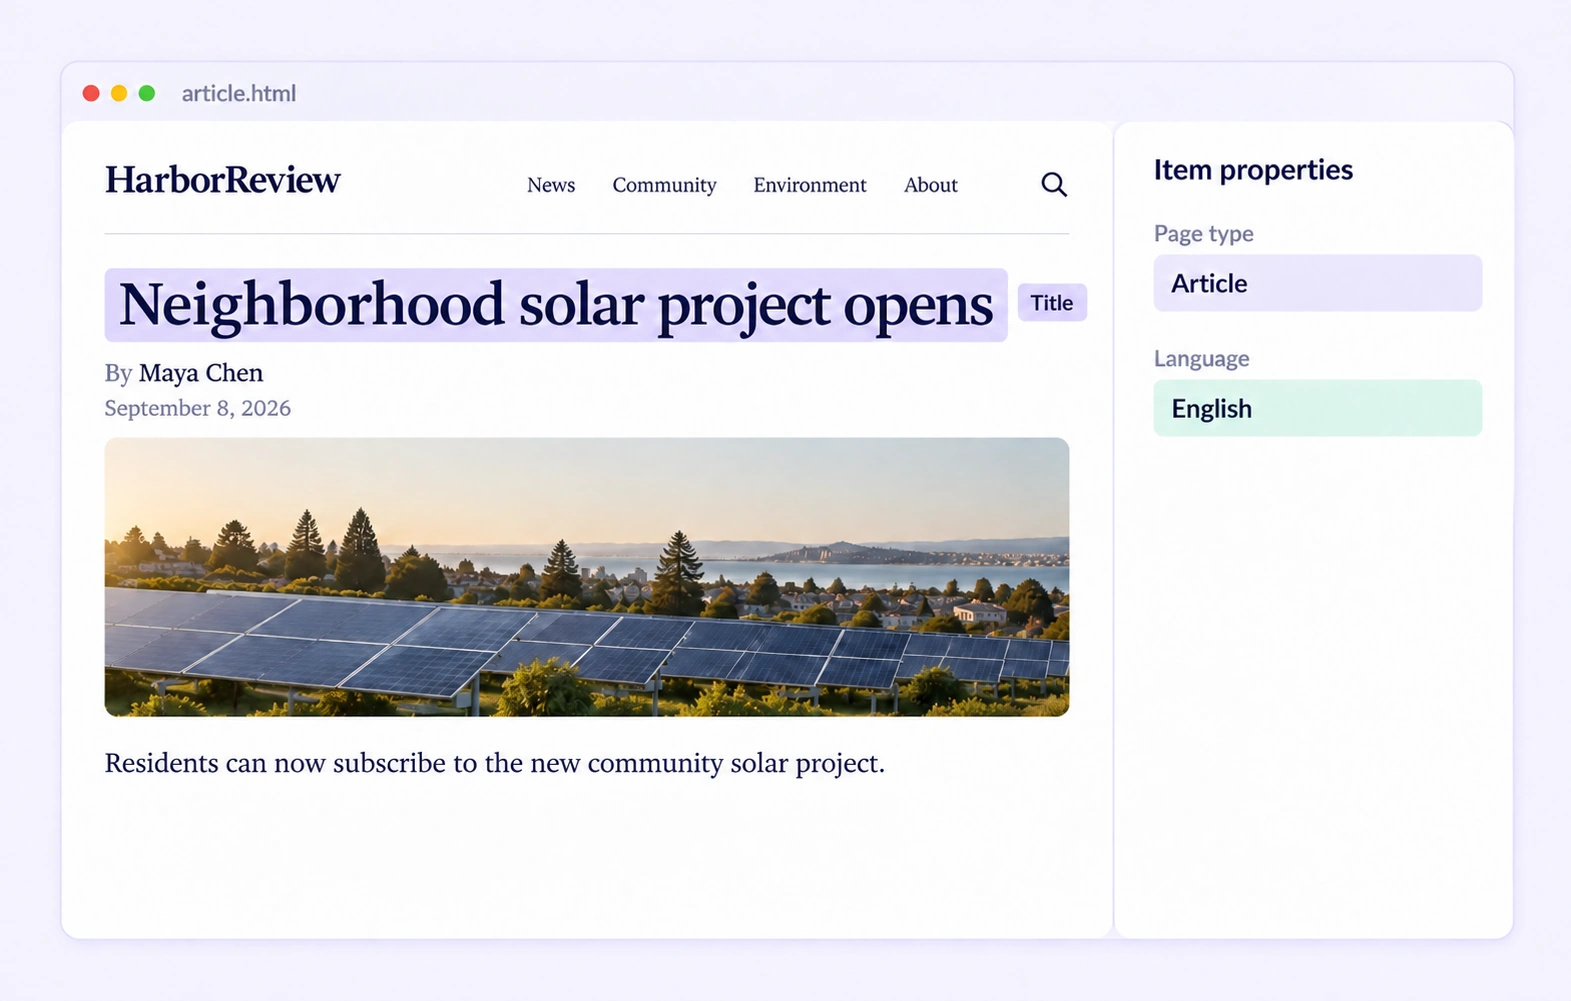
HTML page classification alongside internal text annotations

웹 콘텐츠 추출 자주 묻는 질문

웹 콘텐츠 추출 어노테이션이란 무엇인가요?

추출 시스템이 유지해야 할 페이지 텍스트와 제외해야 할 주변 텍스트를 식별하는 작업입니다. 검토된 본문, 메타데이터, 상용구 라벨은 웹 콘텐츠 추출기의 학습 및 평가 데이터 구축을 지원합니다.

일반 텍스트 대신 렌더링된 HTML을 어노테이션하는 이유는 무엇인가요?

렌더링된 스냅샷은 제목, 열 구성, 기사 섹션, 인접 추천 콘텐츠 같은 맥락 단서를 보존합니다. 어노테이터는 가시 텍스트 구간을 라벨링하면서 페이지의 표시 방식을 참고하여 추출 대상에 속하는 텍스트를 판단합니다.

본문과 상용구는 어떤 기준으로 구분하나요?

프로젝트 지침에서 원본 유형별 규칙을 정의합니다. 기사 문단은 보통 본문에 포함되고 탐색 메뉴나 구독 안내는 대개 제외됩니다. 댓글, 캡션, 관련 링크의 처리 기준도 명시하여 동일한 정책을 적용합니다.

전체 본문과 그 안의 필드를 동시에 라벨링할 수 있나요?

HTML 개체 범위는 연속적이며 겹칠 수 없습니다. 같은 문자를 두 번 라벨링하지 않는 구간 체계를 선택하세요. 전체 페이지 분류에는 항목 속성을 사용하고 내부 콘텐츠와 메타데이터 구간은 별도로 유지합니다.

기사 제목, 작성자, 날짜를 어노테이션할 수 있나요?

네. 필드별로 개체 클래스를 만들고 보이는 원문 텍스트를 선택합니다. 추천 콘텐츠의 작성자나 날짜를 현재 기사의 메타데이터로 오인하지 않도록 주변 맥락을 검토합니다.

페이지를 기사 또는 가이드로 분류할 수 있나요?

네. 페이지 유형이나 다른 전체 페이지 범주에 대한 항목 속성을 구성합니다. 속성은 저장된 전체 HTML 항목을 설명하고 개체 어노테이션은 내부의 개별 텍스트 범위를 라벨링합니다.

Unitlab이 실시간 웹사이트를 자동으로 가져오거나 정제하나요?

이 솔루션은 업로드한 .html 또는 .htm 스냅샷을 라벨링합니다. 실시간 웹 크롤링이나 상용구 자동 제거는 수행하지 않습니다. 검토된 어노테이션은 후속 추출 또는 정제 시스템이 활용할 예시를 제공합니다.

팀은 콘텐츠 경계를 어떻게 검토해야 하나요?

렌더링된 페이지에서 선택 텍스트와 문장 완결성, 인접 섹션을 확인하고 모호한 사례를 지침과 비교합니다. 맥락을 담은 댓글, 검토, 재작업으로 누락된 콘텐츠나 포함된 상용구를 수정합니다.

콘텐츠 추출 평가용 라벨을 내보낼 수 있나요?

네. HTML은 지원되는 원본 식별 정보, 텍스트 앵커, 개체 라벨, 속성을 포함하는 JSONL과 Unitlab 통합 내보내기 형식을 지원합니다. 검토된 출력을 자체 콘텐츠 추출 파이프라인의 입력 및 평가 형식에 맞춰 적용하세요.