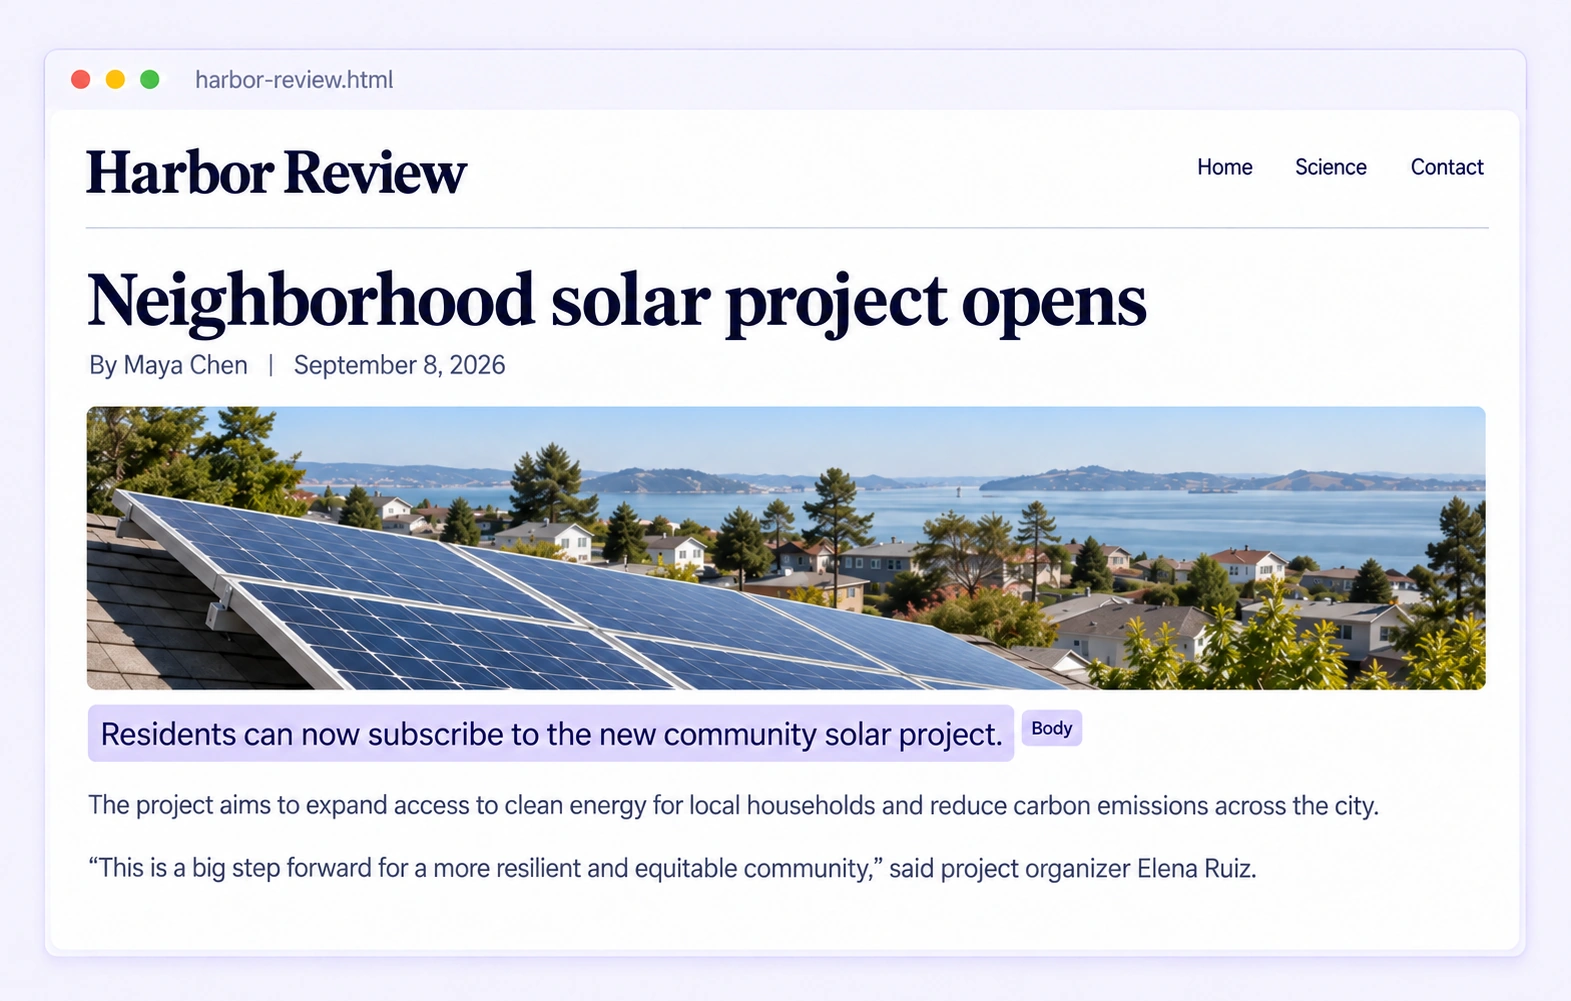
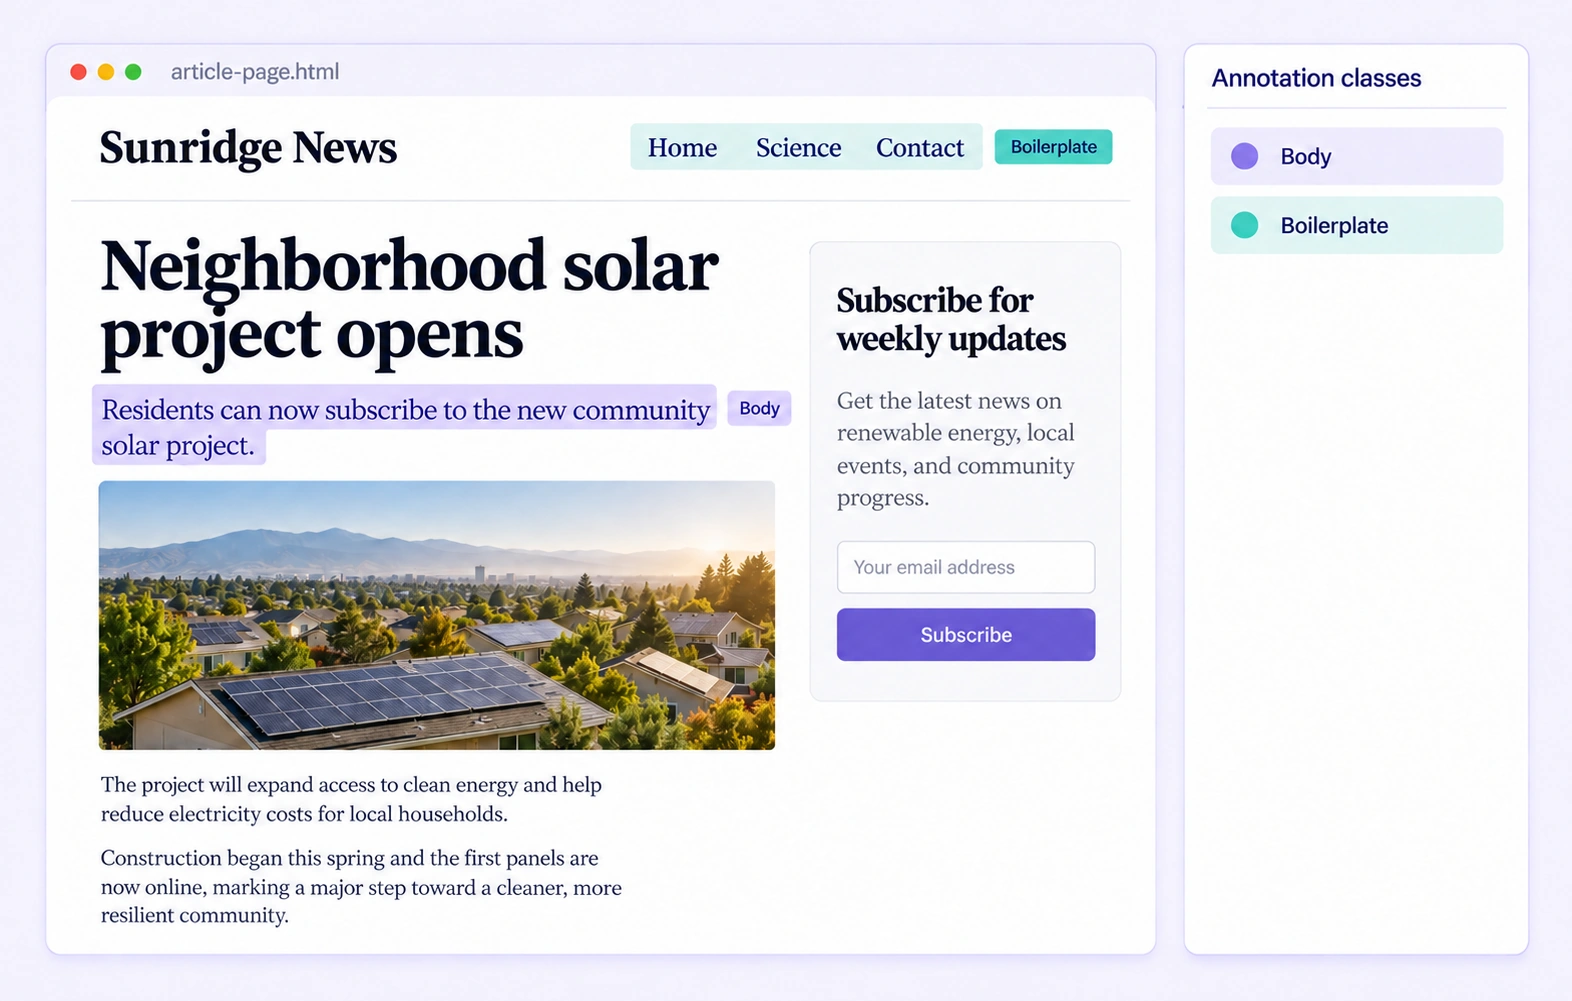
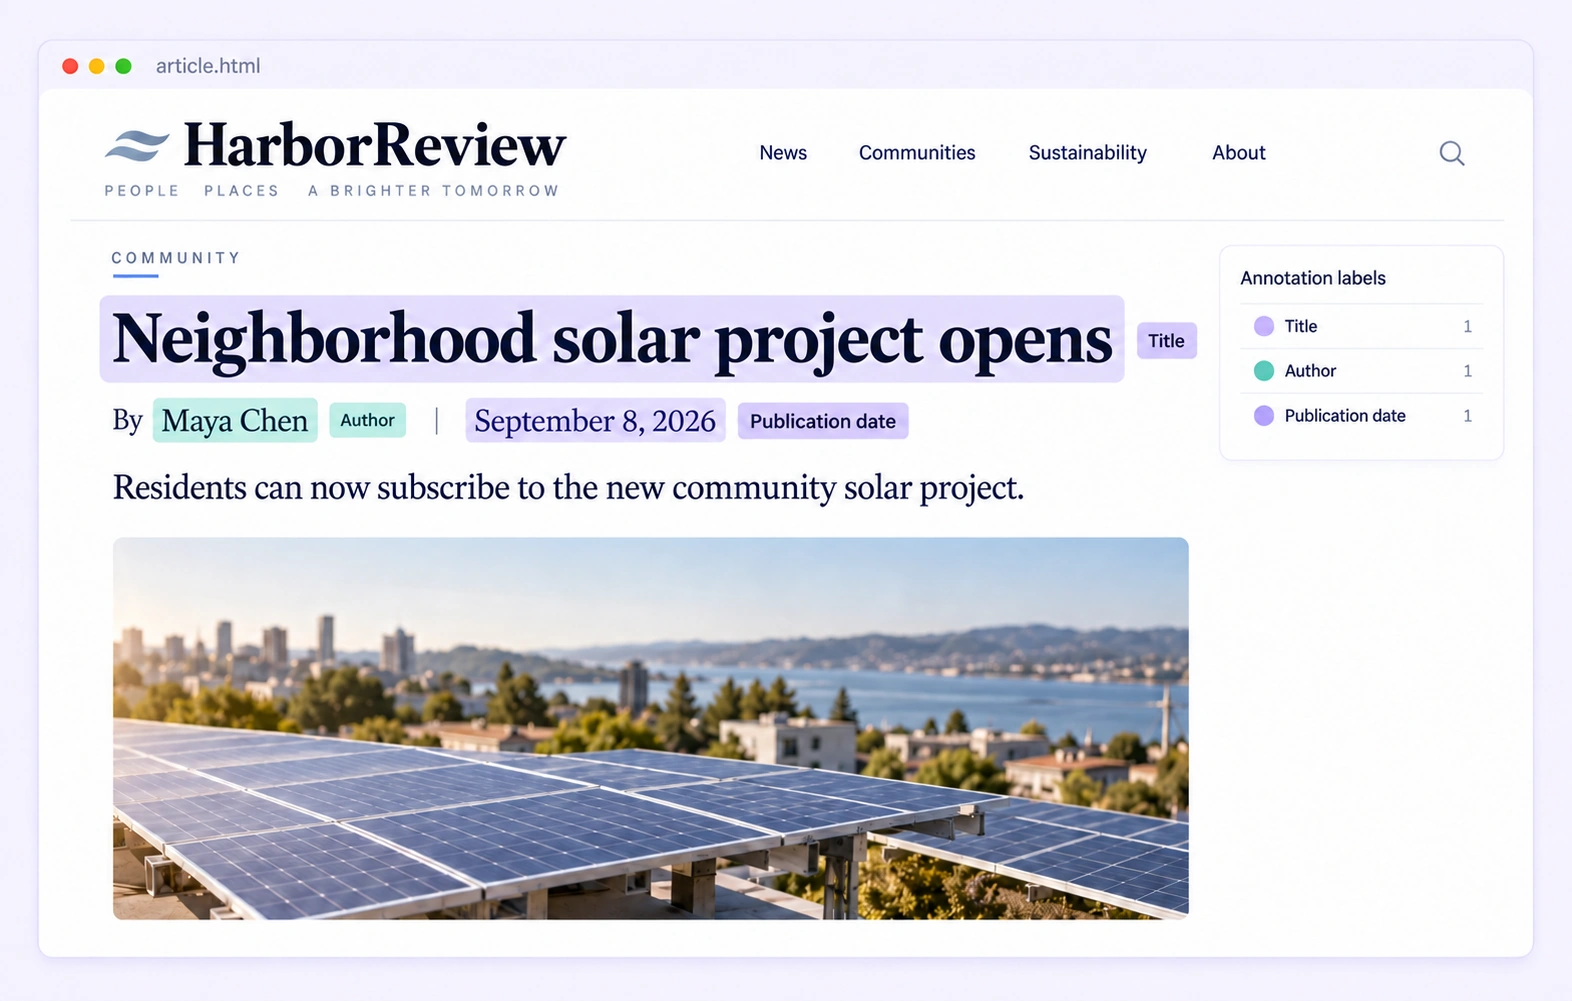
每次为正文或元数据标注一个连续的可见文本范围。保持标签不重叠,并根据项目边界规则区分相邻文本的角色。
使用页面类型、语言等属性对整个 HTML 数据项分类,同时保留其内部文本标注。这些属性值描述已保存的源页面。
网页内容提取标注明确提取系统应保留的页面文本及应排除的周边文本。经过审核的正文、元数据与模板化文本标签帮助团队为网页内容提取器构建训练和评估数据。
渲染后的快照保留标题、分栏、文章区块与附近推荐内容等上下文线索。标注员仍然标注可见文本片段,而页面呈现方式帮助判断哪些文本属于提取目标。
项目指南为各类源页面定义规则。文章段落通常属于正文,导航或订阅提示通常不属于正文。应明确评论、图注与相关链接的处理方式,使标注员采用相同规则。
HTML 实体范围必须连续且不重叠。请选择避免对相同字符重复标注的片段方案。使用数据项属性进行整页分类,并将内部内容与元数据片段分别标注。
可以。为各字段创建不同的实体类别,并选择可见原文。审核周围上下文,避免将推荐文章的作者或日期误认为当前文章的元数据。
可以。配置页面类型或其他整页类别的数据项属性。这些属性描述完整的已保存 HTML 数据项,实体标注则标记其中的独立文本范围。
此方案标注已上传的 .html 或 .htm 快照,不会爬取实时网页或自动移除模板化文本。经过审核的标注为下游提取或清理系统提供可用样本。
在渲染后的页面中检查所选文本,核对句子完整性与相邻区块,并对照指南处理歧义案例。通过上下文评论、审核与返工,修正遗漏内容或误纳入的模板化文本。
可以。HTML 支持 JSONL 和 Unitlab 统一导出格式,包含受支持的源标识、文本锚点、实体标签与属性。将已审核输出适配到您自己的内容提取流程所要求的输入与评估格式。