로봇 인지를 위한 LiDAR 학습 데이터

3D 장면에서 장애물, 사람, 객체와 작업 공간 구조를 어노테이션하세요. 공유 온톨로지와 캘리브레이션된 센서 정보를 활용해 검토된 로봇 인지 학습 예제를 구축합니다.
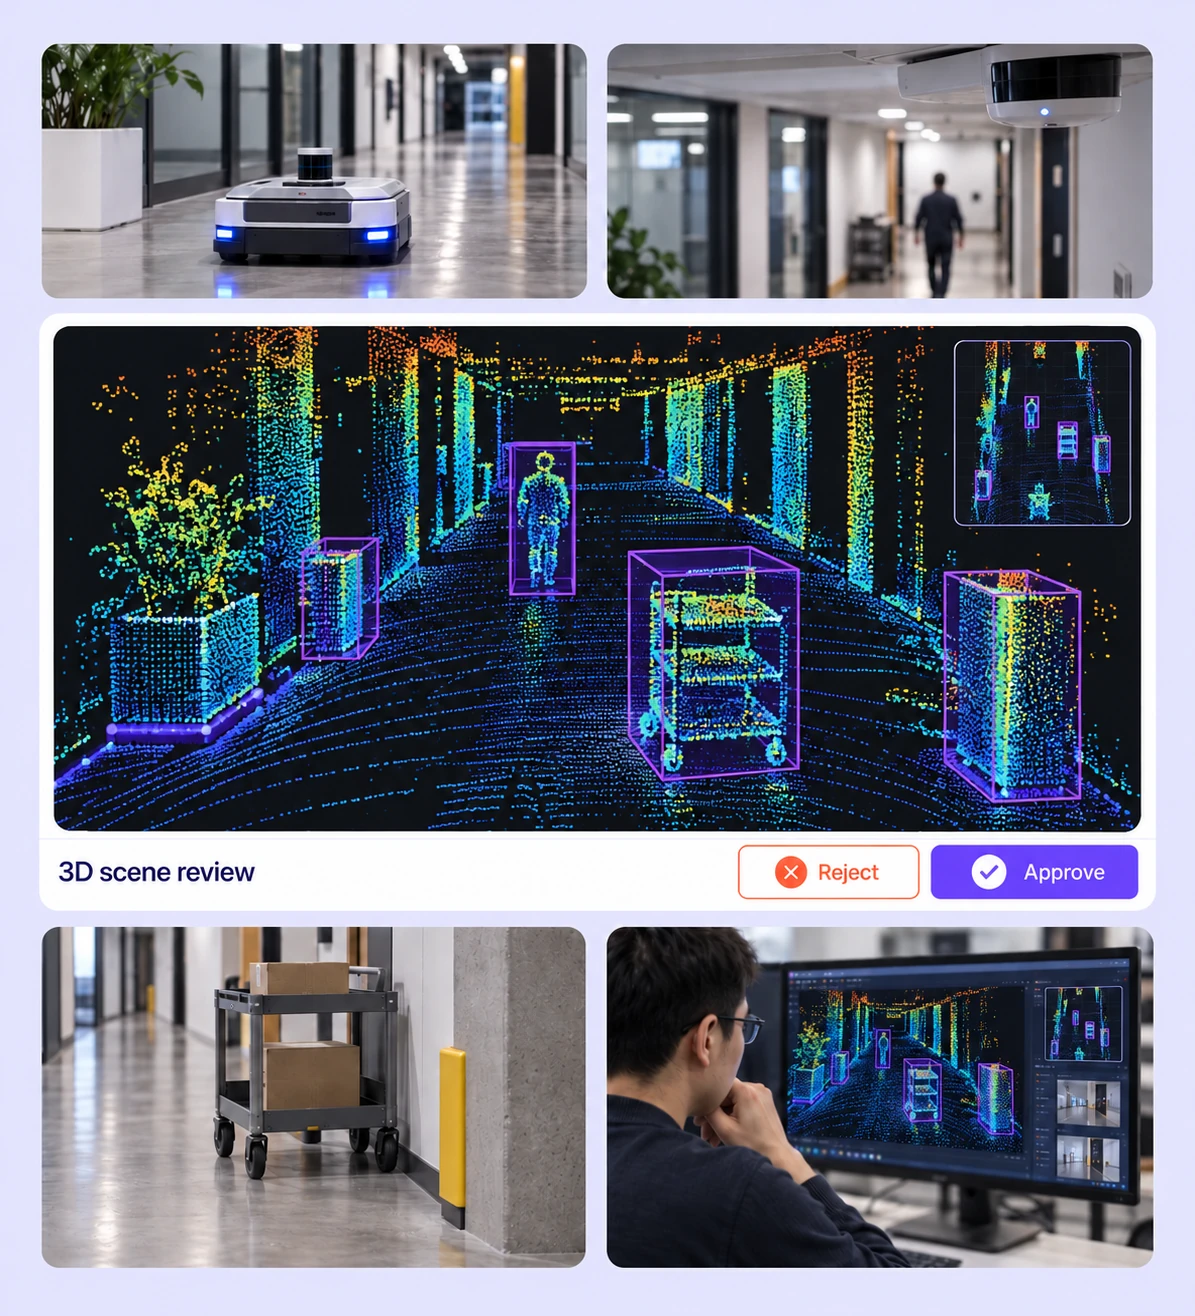
Indoor LiDAR scan with height-colored point returns and cuboids for people, carts, and obstacles.

로봇 인지를 위한 LiDAR 어노테이션

로봇 기록 전반에서 장애물, 작업 영역과 움직이는 객체의 라벨을 준비하세요.
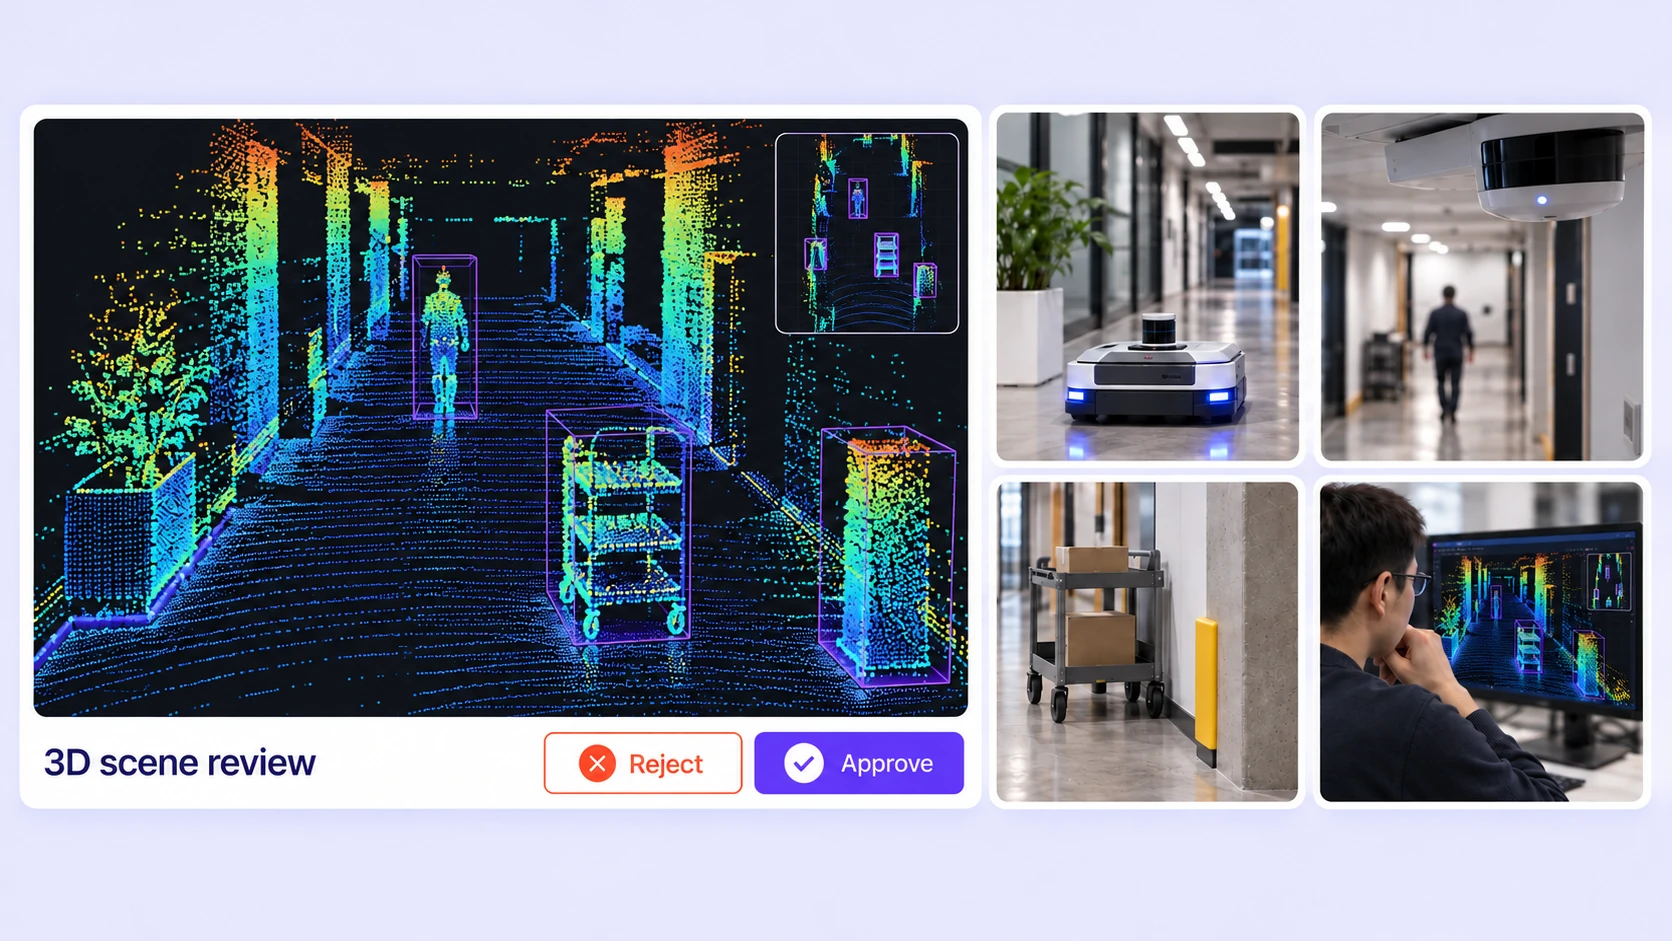
Indoor LiDAR scan with height-colored point returns and cuboids for people, carts, and obstacles.

장애물과 객체의 3D 바운딩 박스

카트, 장비와 장애물의 방향 및 3D 범위를 정의하세요. 측정된 포인트에 맞춰 크기와 회전을 조정합니다.
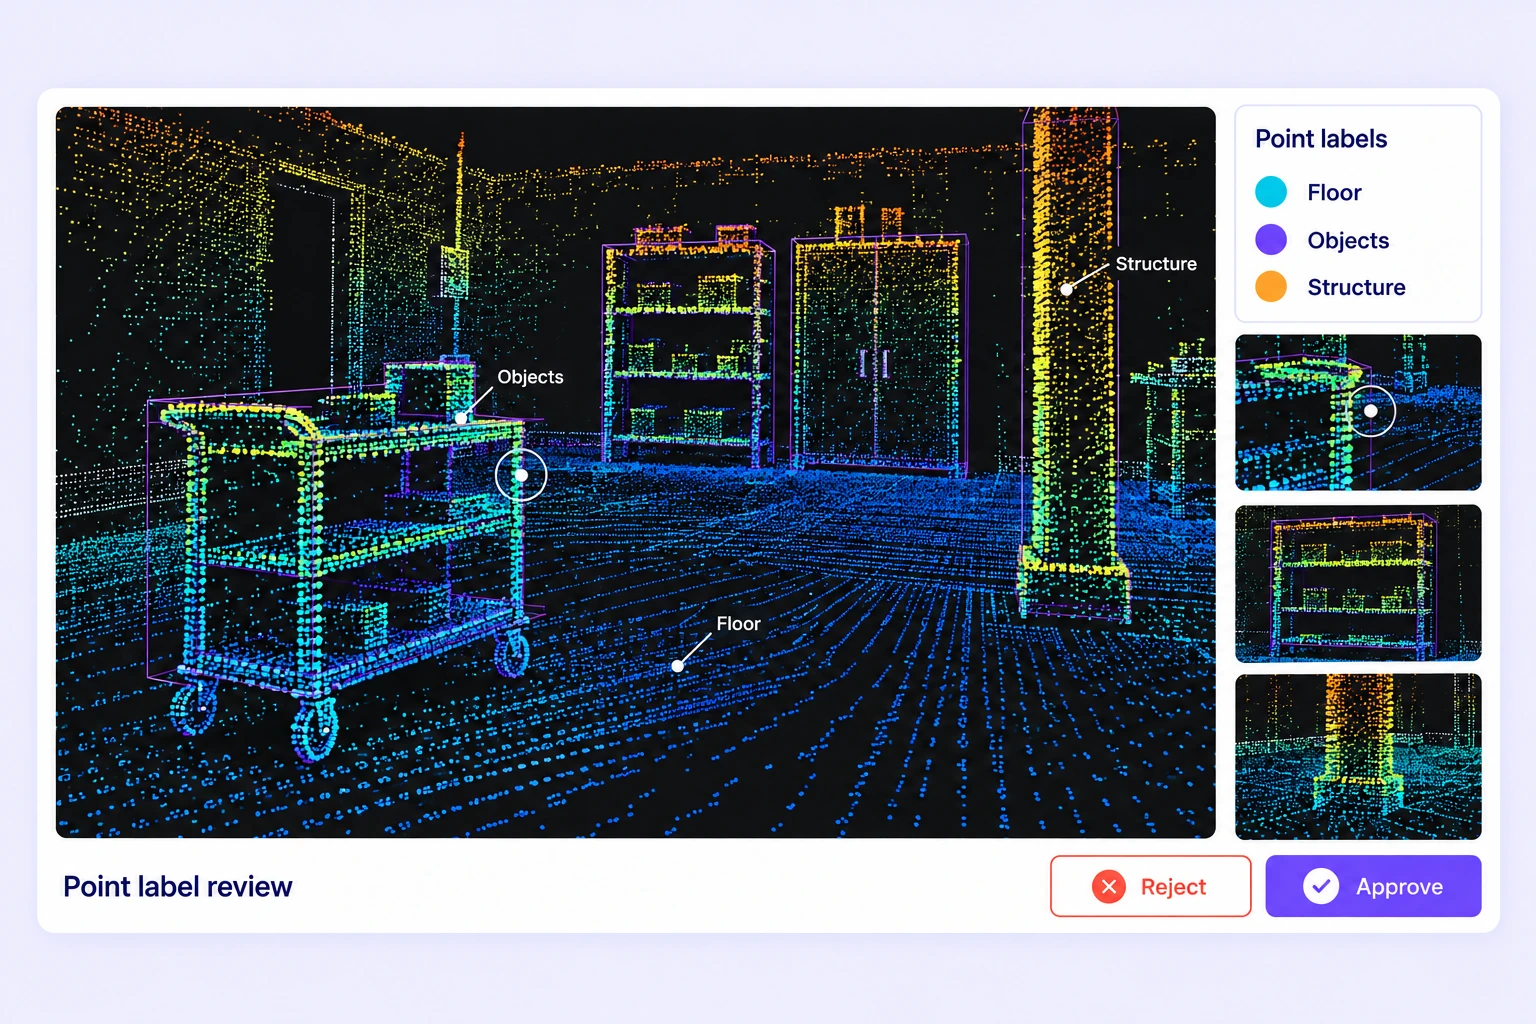
Workshop point cloud with floor, objects, and structural points labeled in distinct classes.

작업 공간 포인트 분할

바닥, 구조물과 객체에 작업별 포인트 클래스를 지정하세요. 인접한 표면이나 희소한 측정값 때문에 모호한 경계를 확인합니다.
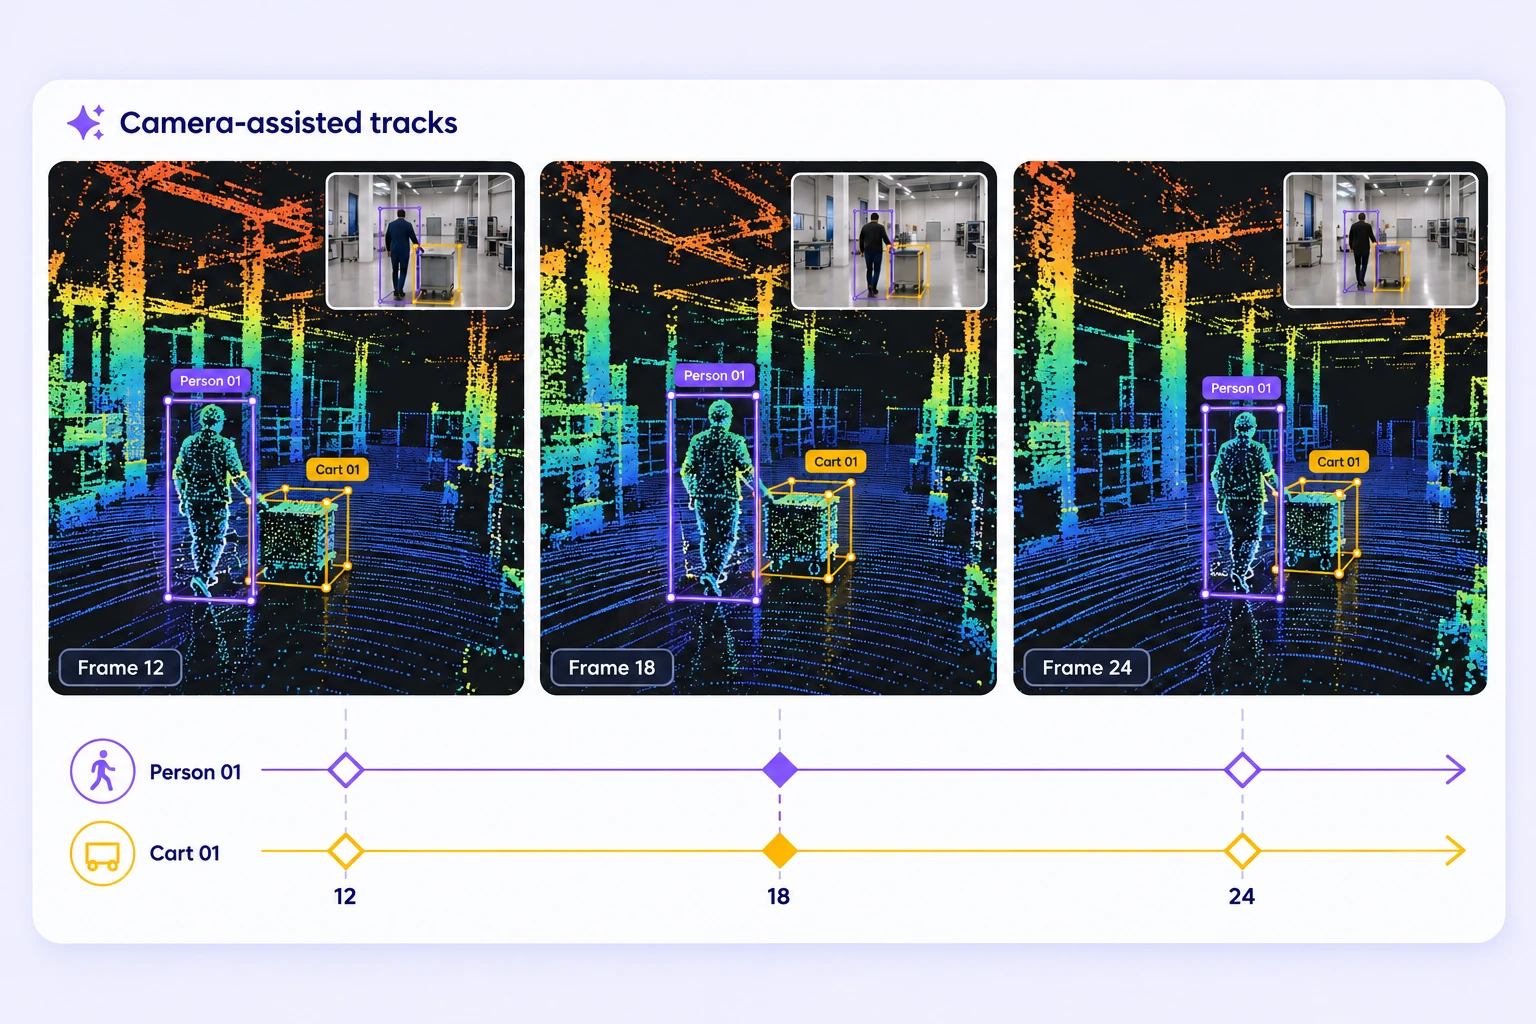
An indoor hall height-colored LiDAR sequence follows a person and a wheeled cart with matching camera insets and consistent cuboid tracks across three frames.

프레임 간 움직이는 객체

움직이는 사람과 객체의 트랙 식별 정보를 일관되게 유지하세요. 장면이 변하면 키프레임과 가시성 구간을 다듬습니다.
An indoor hall height-colored LiDAR sequence follows a person and a wheeled cart with matching camera insets and consistent cuboid tracks across three frames.

캘리브레이션된 센서 정보

동기화된 카메라 영상으로 포인트 클라우드 라벨을 검토하세요. 여러 시점을 활용해 객체 클래스와 부분 가림의 모호함을 해소합니다.

대규모 AI 데이터를 위해 설계된 플랫폼

AI 기반 자동화, 확장 가능한 워크플로, 낮은 운영 비용으로 복잡한 LiDAR 데이터셋을 더 빠르게 어노테이션합니다.
15×
더 빠른 LiDAR 데이터 어노테이션

배치 워크플로, 카메라 기반 Find Similar와 Auto-Tracking, 보간으로 반복적인 수동 LiDAR 라벨링을 줄입니다.

85%
자동화된 LiDAR 어노테이션

평균적으로 LiDAR 라벨의 85%가 자동으로 사전 라벨링되며, 이후 사람이 검토하고 다듬습니다.

15×
학습 데이터 비용 절감

큐레이션, 어노테이션, QA를 자동화하면 승인된 라벨당 비용을 최대 1/15 수준으로 낮출 수 있습니다.

로봇 인지 어노테이션 방법

객체 도형, 포인트 라벨과 변화하는 장면 속성으로 로봇의 주변 환경을 표현하세요.
Workshop point cloud with floor, objects, and structural points labeled in distinct classes.

인지 작업을 위한 공간 라벨

모델 출력에 따라 3D 바운딩 박스, 포인트, 폴리라인, 다각형, 구 또는 포인트 분할을 선택하세요. 기록 전반에서 클래스 정의와 필수 속성을 일관되게 유지합니다.

장면 타임라인과 동적 속성

기록 전체에서 객체 트랙과 변화하는 속성을 검토하세요. 원본 데이터로 확인할 수 있는 프레임에서 도형과 상태 변화를 수정합니다.

An indoor hall height-colored LiDAR sequence follows a person and a wheeled cart with matching camera insets and consistent cuboid tracks across three frames.

로봇 LiDAR 어노테이션 FAQ

로봇을 위한 LiDAR 어노테이션이란 무엇인가요?

로봇 인지 모델을 위해 라벨링된 포인트 클라우드 예제를 준비하는 작업입니다. 라벨은 객체, 장애물, 작업 영역과 기록된 장면에서의 변화를 표현합니다.

객체와 장면 표면을 모두 라벨링할 수 있나요?

네. 객체 도형에는 3D 바운딩 박스와 기타 공간 도형을, 클래스별 포인트 영역에는 포인트 분할을 사용하세요. 도구를 선택하기 전에 라벨 경계와 기대하는 모델 출력을 정의합니다.

LiDAR와 카메라 정보를 함께 사용할 수 있나요?

네. 장면에 캘리브레이션과 포즈가 포함된 포인트 클라우드 센서와 카메라 영상을 구성할 수 있습니다. 어노테이터는 기록된 3D 장면과 라벨의 연결을 유지하면서 여러 뷰를 확인합니다.

사람이나 움직이는 장애물을 추적할 수 있나요?

지속적인 3D 객체 트랙, 키프레임, 보간과 가시성 구간을 사용하세요. 적절한 캘리브레이션 카메라 시퀀스가 있으면 카메라 기반 바운딩 박스 추적을 사용할 수 있으며, 생성된 결과는 검토해야 합니다.

로봇 기록 간 라벨 일관성을 어떻게 유지하나요?

재사용 가능한 클래스, 중첩 속성과 명확한 경계 및 가시성 규칙을 정의하세요. 대표 예제, 필수 속성 검사와 맥락을 고려한 검토로 기록 세션 간 차이를 해결합니다.

Find Similar는 반복되는 객체의 라벨링을 어떻게 돕나요?

3D 바운딩 박스를 선택하고 캘리브레이션된 카메라 뷰에서 Find Similar로 유사한 객체를 찾으세요. 후보 검출 결과를 LiDAR 포인트에 맞추고 클래스와 도형을 검토한 뒤 필요한 라벨을 승인합니다.

어떤 포인트 클라우드 입력을 업로드할 수 있나요?

PCD, PLY, BIN 포인트 클라우드를 파일, ZIP 장면 또는 폴더로 업로드하세요. 필요한 경우 장면 매니페스트를 사용해 프레임 시퀀스, 센서 정의, 카메라 캘리브레이션과 포즈를 지정합니다.

학습 전에 로봇 어노테이션을 어떻게 검토하나요?

전문가 검토, 독립 장면의 Consensus와 승인된 Quality Gate 기준 데이터를 결합하세요. 맥락 속에서 도형과 속성을 확인하고 문제를 할당한 뒤 수정 결과를 검토해 어노테이션 릴리스를 만듭니다.

검토된 데이터셋은 어떻게 내보내나요?

LiDAR 어노테이션을 Unitlab Unified Export Format(UUEF)으로 내보내면 지원되는 3D 도형, 트랙, 장면 메타데이터, 캘리브레이션과 포인트 라벨 배열이 포함됩니다. 내보낸 라벨이 학습 파이프라인의 좌표 및 클래스 규칙에 맞는지 확인하세요.