
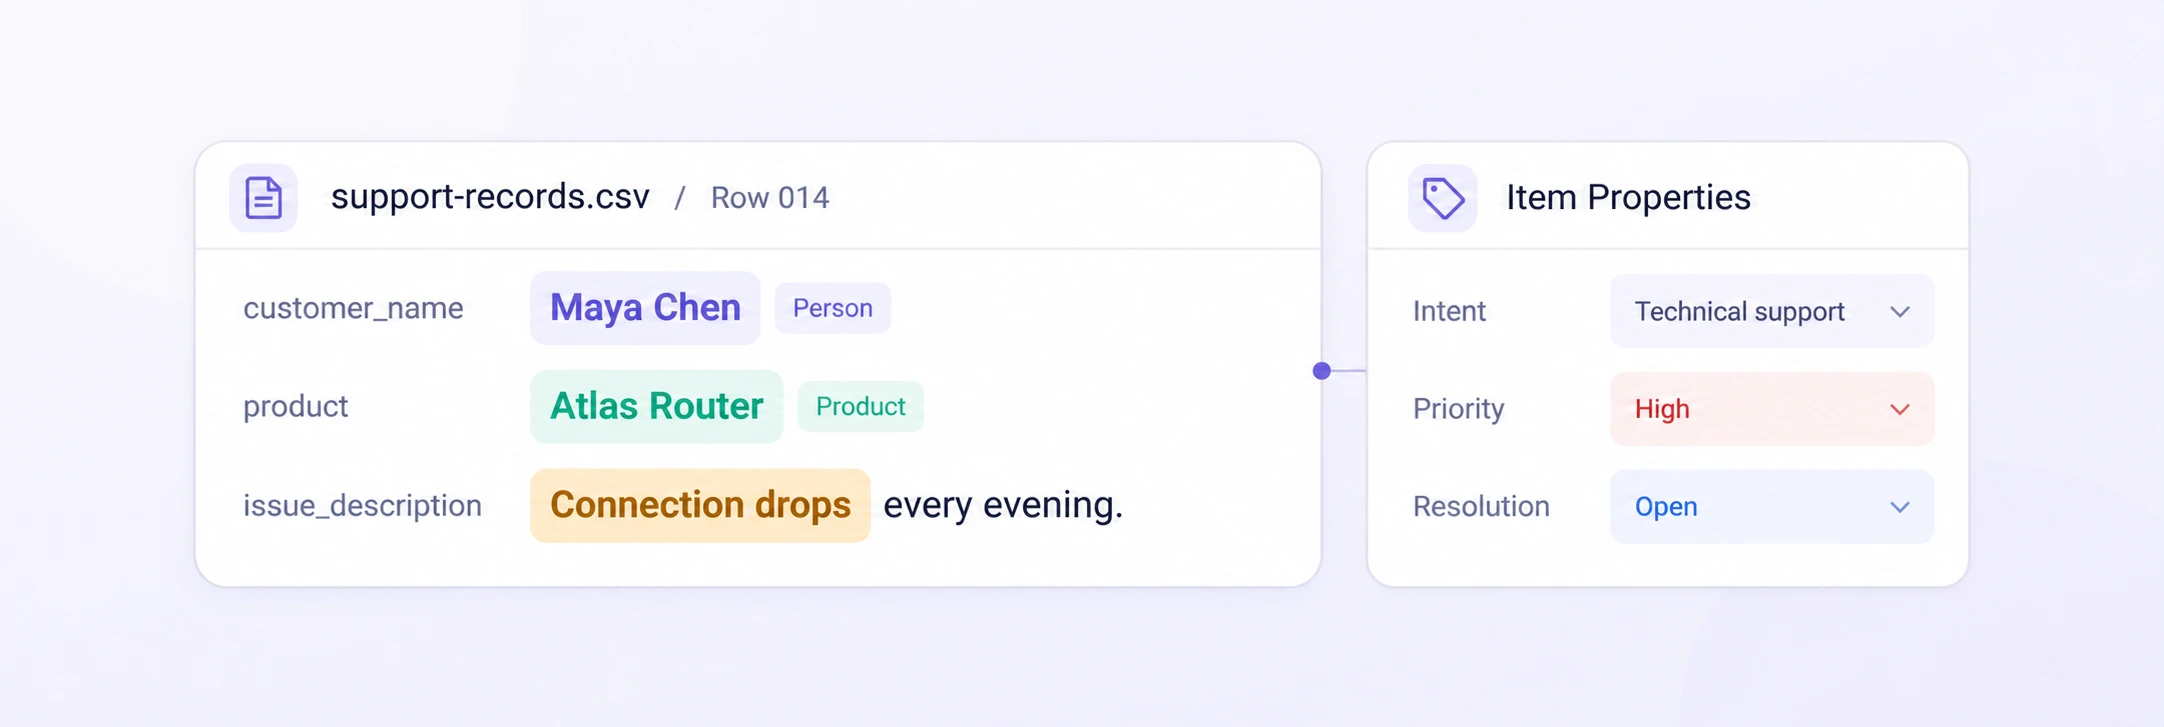
레코드 단위 어노테이션
원본 필드를 유지한 채 CSV 행을 개별 어노테이션 작업으로 전환합니다. 각 필드의 맥락을 확인하며 레코드 단위 분류와 속성을 추가하세요.
레코드 속성필드 맥락CSV 행 작업

CSV 레코드를 신뢰할 수 있는 학습 데이터로 전환하세요. 여러 필드의 텍스트를 라벨링하고 관계를 정의하며, 공유 온톨로지와 검토 절차로 모든 레코드를 관리합니다.
원본 맥락을 유지하면서 레코드를 분류하고, 셀 텍스트와 헤더를 라벨링하고, 필드를 연결하고, 구조화된 데이터를 검토하세요.
원본 필드를 유지한 채 CSV 행을 개별 어노테이션 작업으로 전환합니다. 각 필드의 맥락을 확인하며 레코드 단위 분류와 속성을 추가하세요.
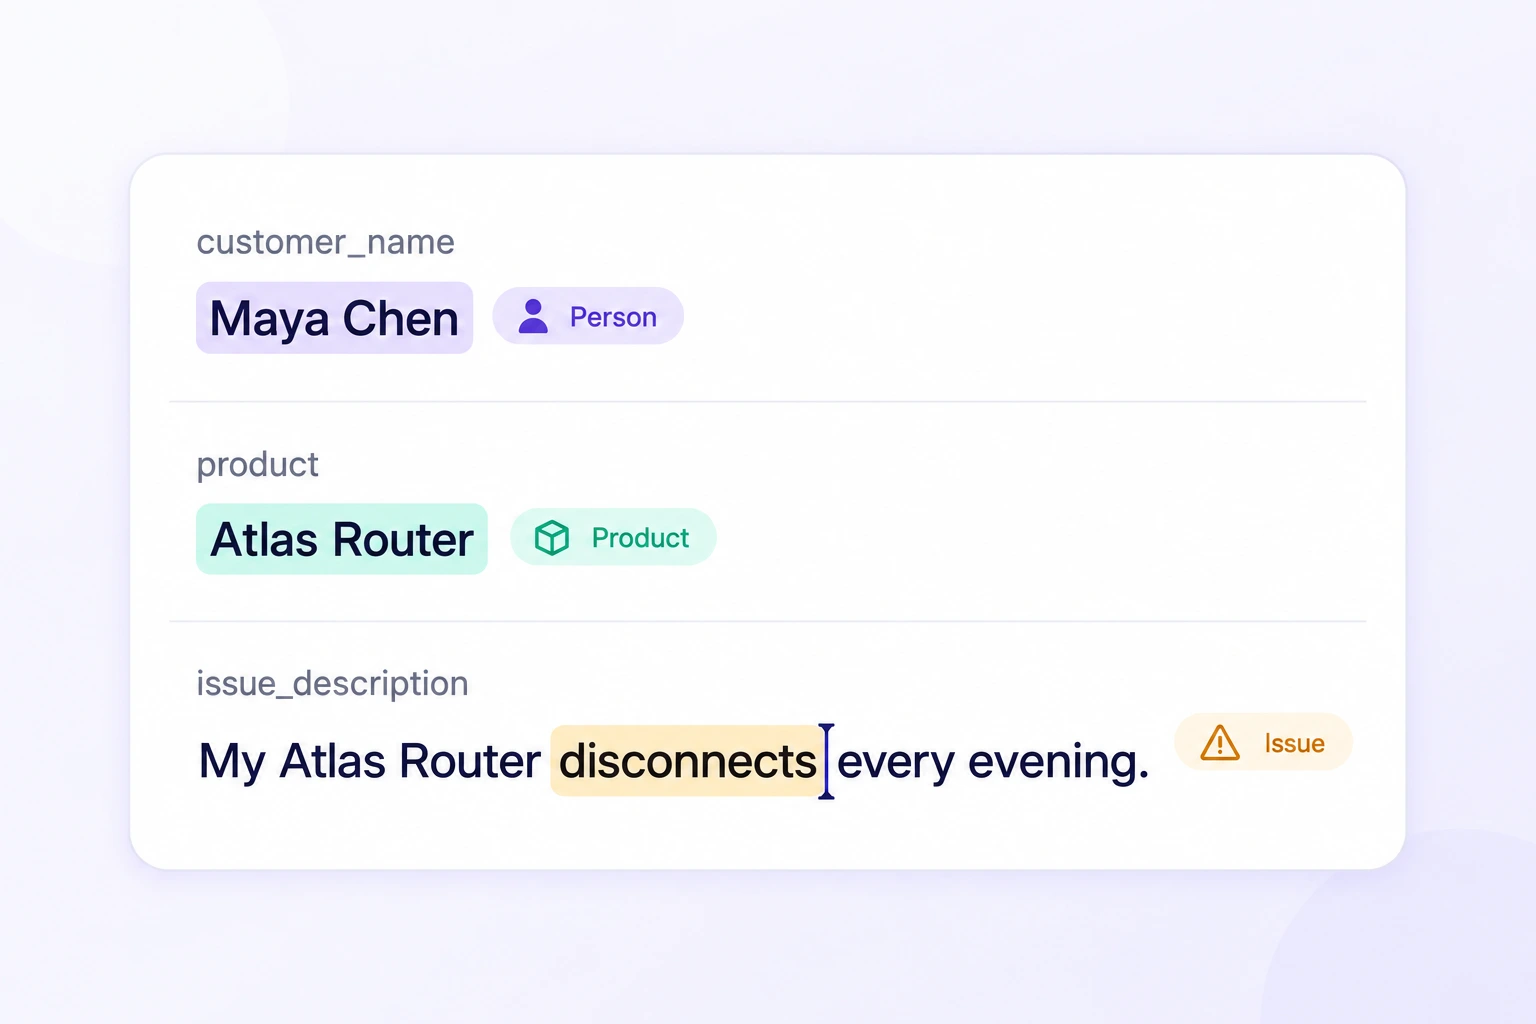
고객 이름, 제품 정보, 문제 설명 등 모든 텍스트 필드에서 엔티티를 라벨링합니다. 각 라벨에는 해당 열과 정확한 문자 범위가 보존됩니다.
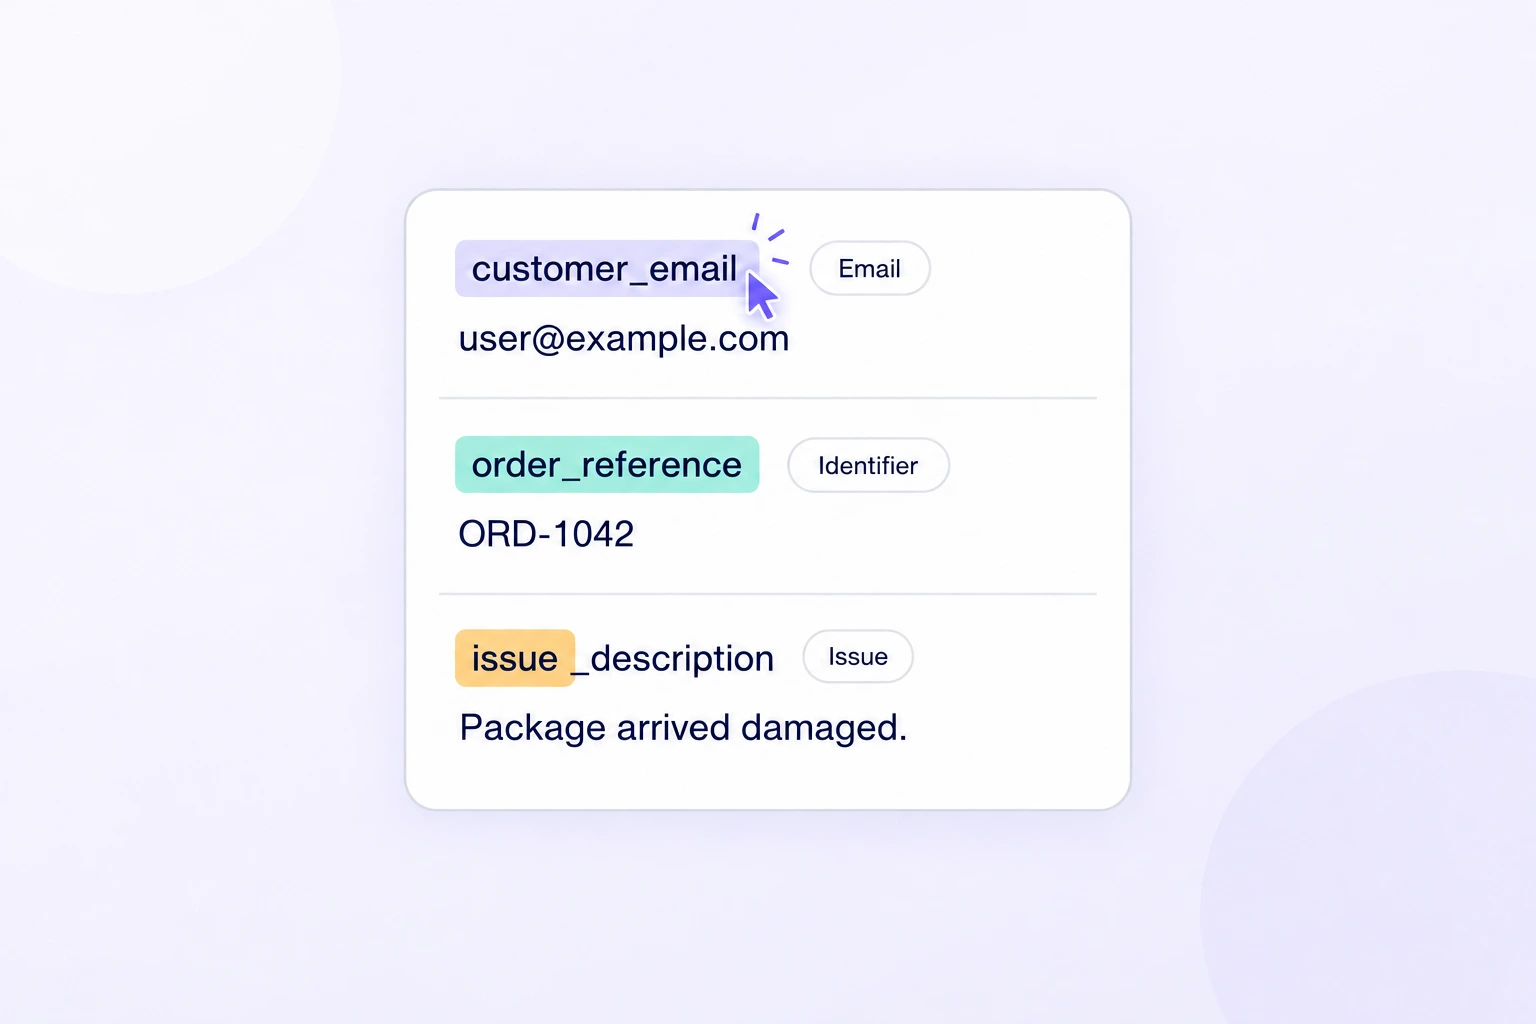
레코드의 열 이름과 선택한 헤더 텍스트에 의미 라벨을 추가합니다. 필드의 값과 엔티티뿐 아니라 해당 필드의 역할도 기록하세요.
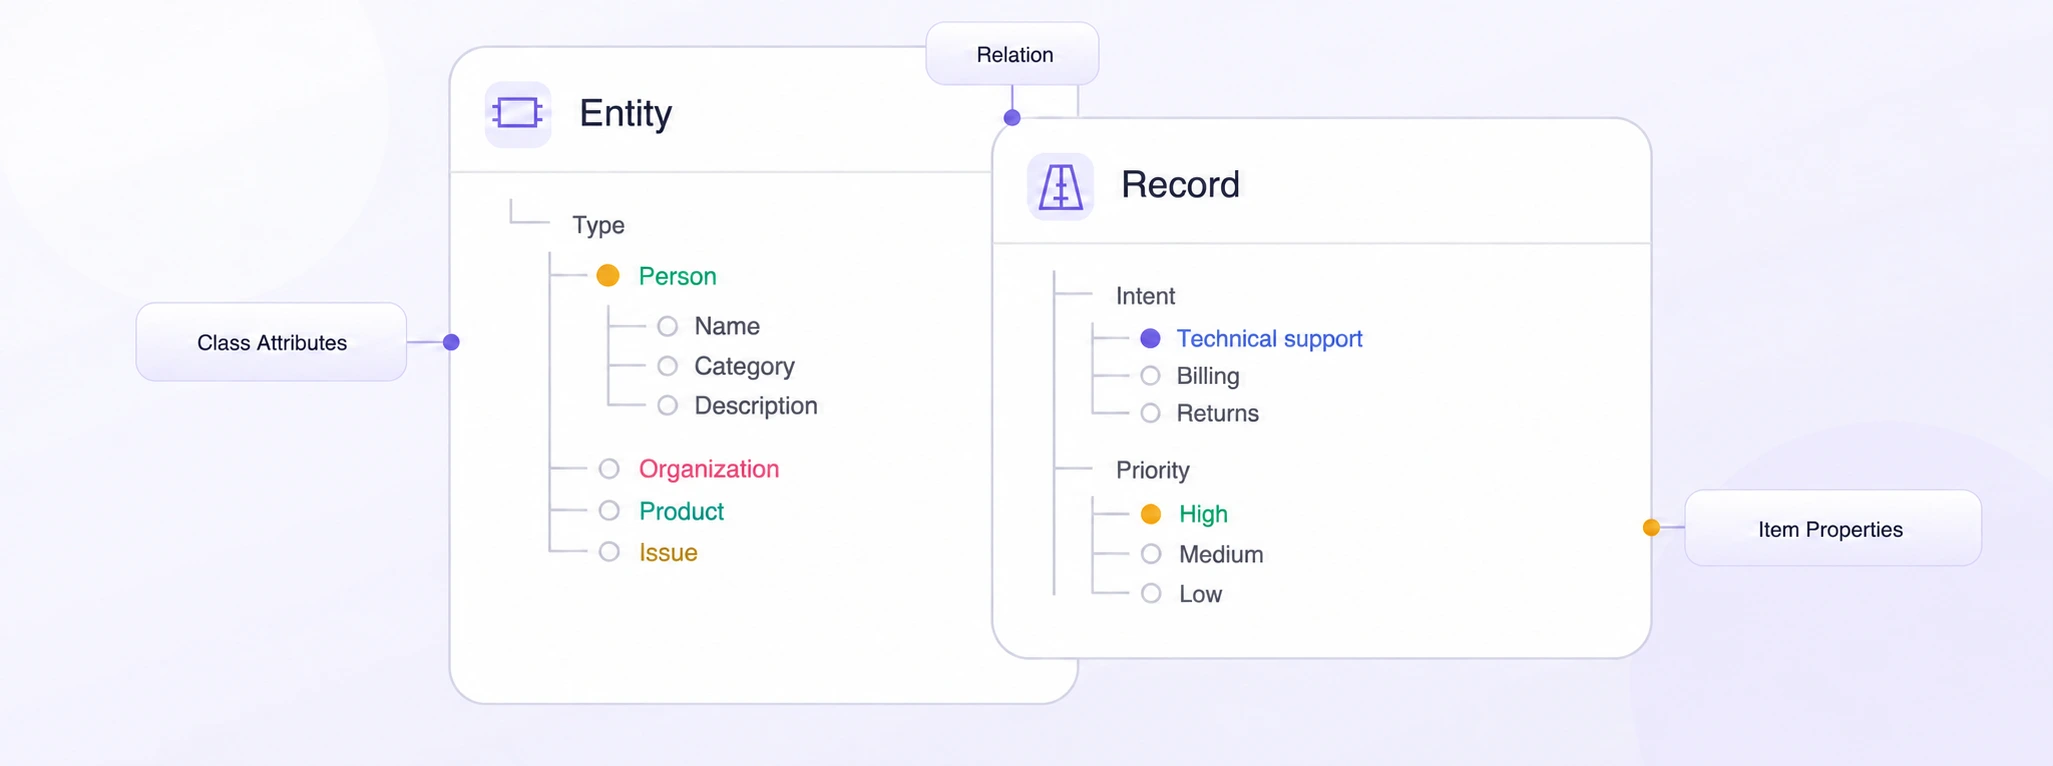
공유 온톨로지로 엔티티 클래스, 레코드 속성, 관계를 표준화합니다. 필수 필드와 구조화된 선택지를 정의해 일관된 테이블 라벨을 유지하세요.
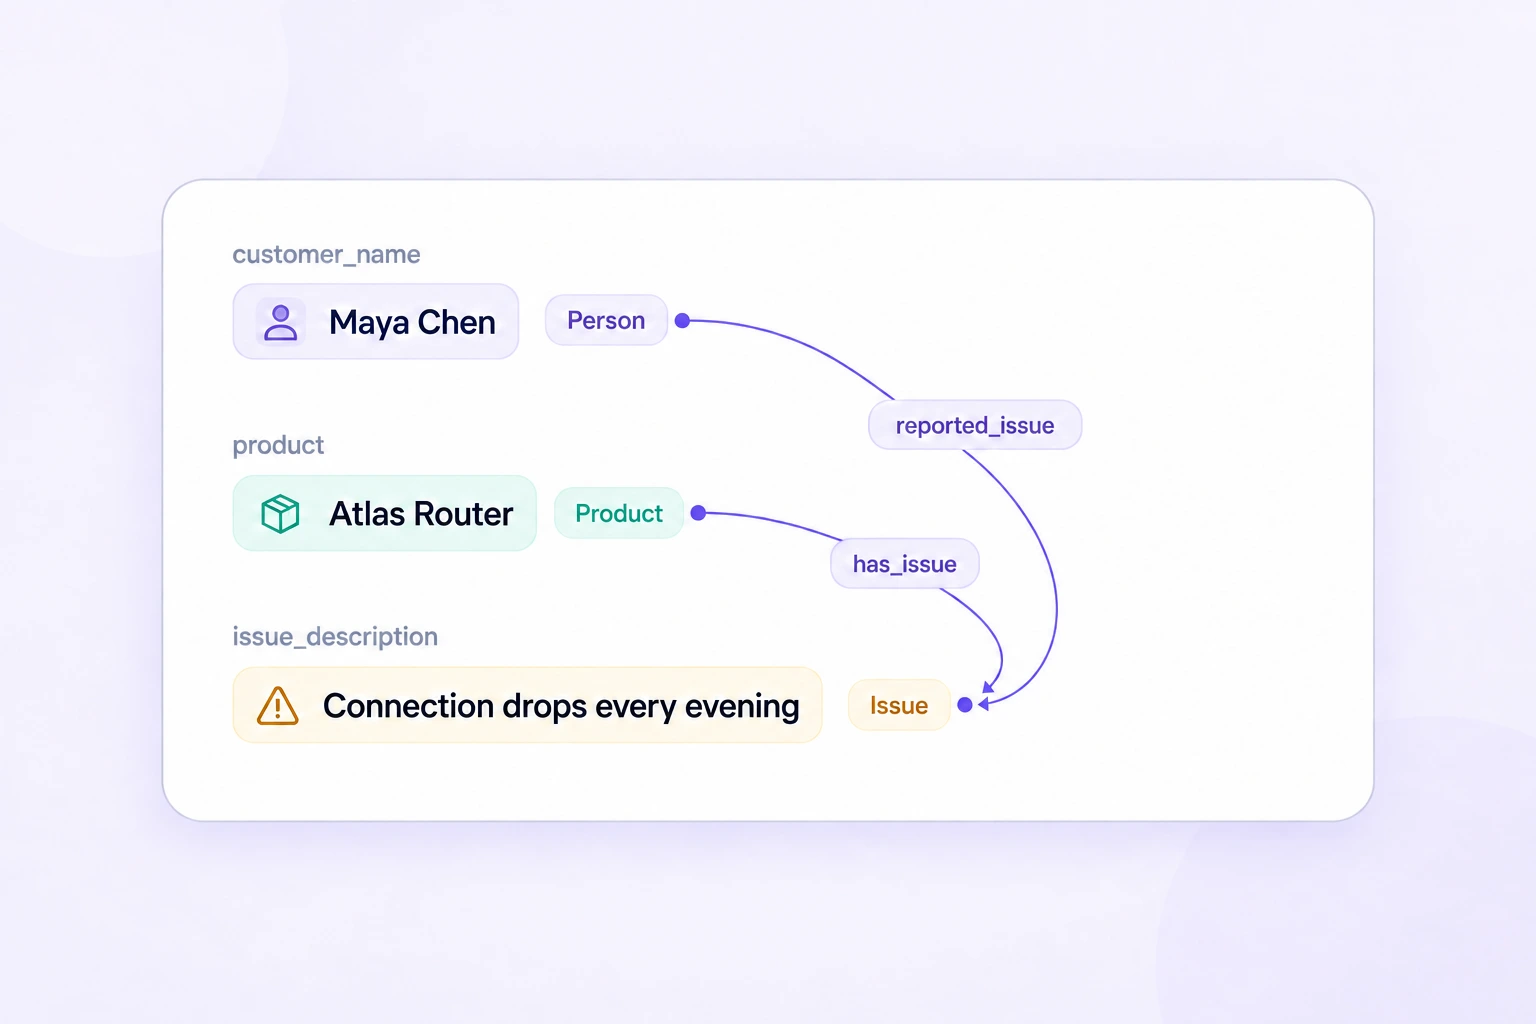
같은 레코드의 여러 필드에 있는 라벨링된 엔티티를 연결합니다. 사람, 제품, 조직, 문제 사이의 관계를 학습 데이터에 명확하게 표현하세요.
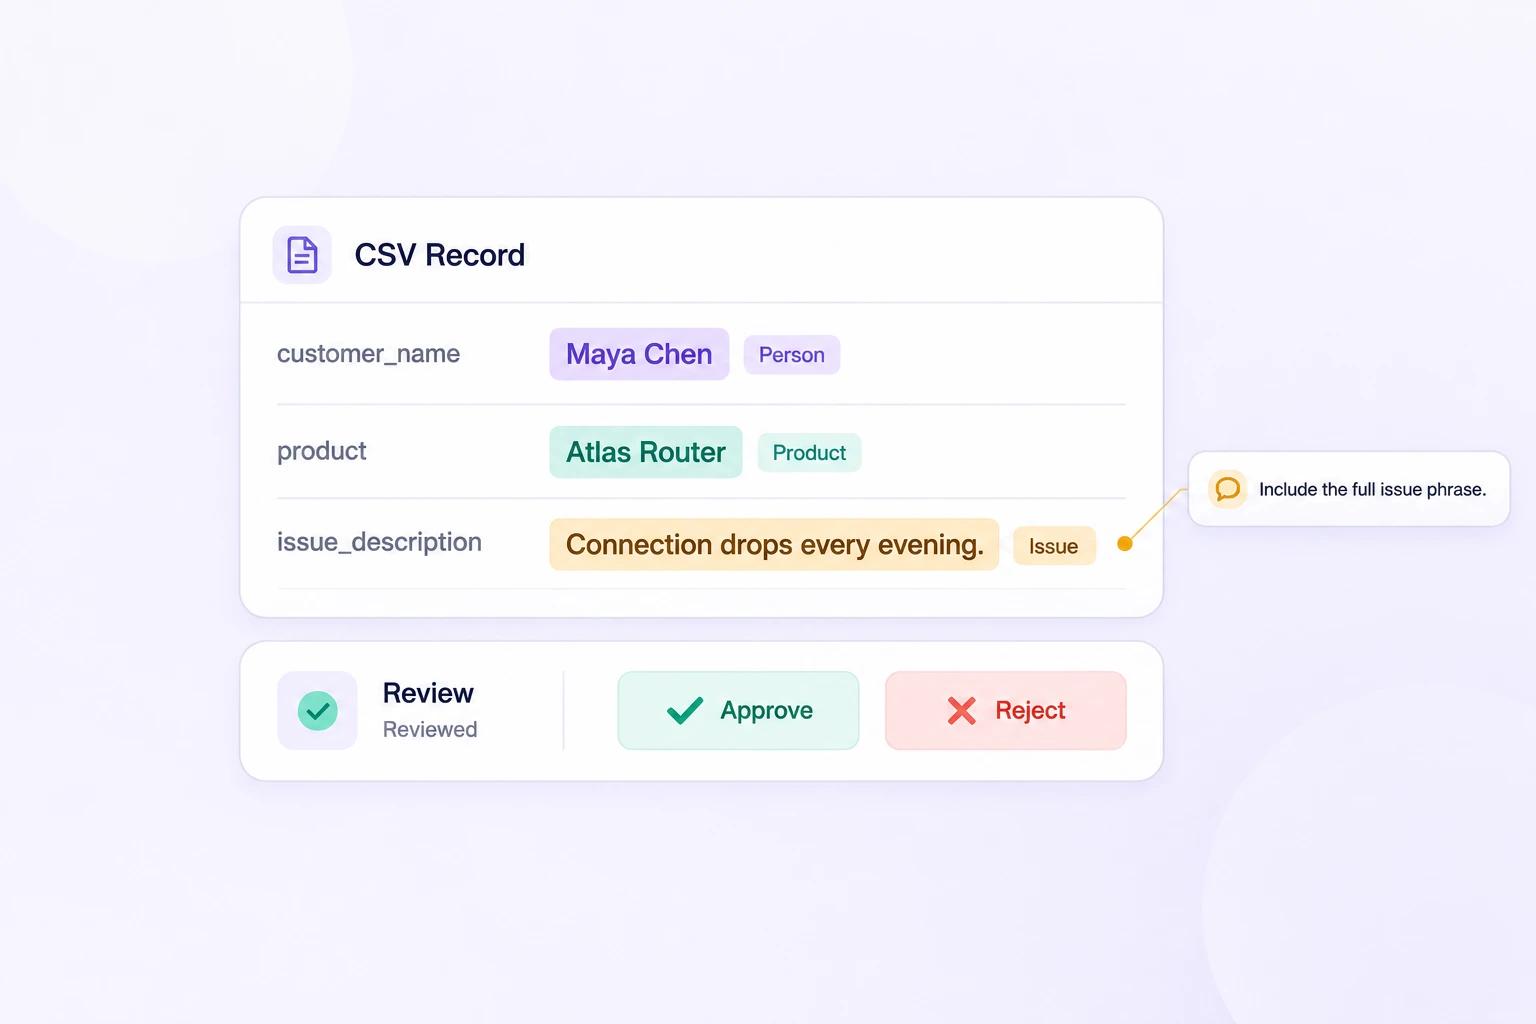
라벨과 속성을 확인하며 레코드를 검토합니다. 댓글, 합의, 승인된 기준 어노테이션으로 릴리스 전에 의견 차이를 해결하세요.
원본 CSV부터 검토된 데이터셋 릴리스까지, 구조화된 레코드와 세부 라벨, 품질 판단을 연결해 관리합니다.
각 레코드를 분류하고, 셀 텍스트의 엔티티와 열 이름을 라벨링하고, 재사용 가능한 온톨로지로 필드 간 정보를 연결합니다.
레코드 전체를 설명하는 의도, 우선순위, 처리 결과 및 기타 속성을 지정합니다.
모든 텍스트 필드에서 엔티티를 라벨링하며 열과 문자 위치를 보존합니다.
현재 레코드의 열 이름이나 헤더 내 텍스트 범위에 라벨을 지정합니다.
같은 레코드의 여러 필드에 있는 라벨링된 엔티티와 헤더를 연결합니다.
하나의 작업 공간에서 CSV 자산을 정리하고, 데이터셋 버전을 관리하고, 레코드를 확인하며, 어노테이션 검토와 승인을 진행합니다.
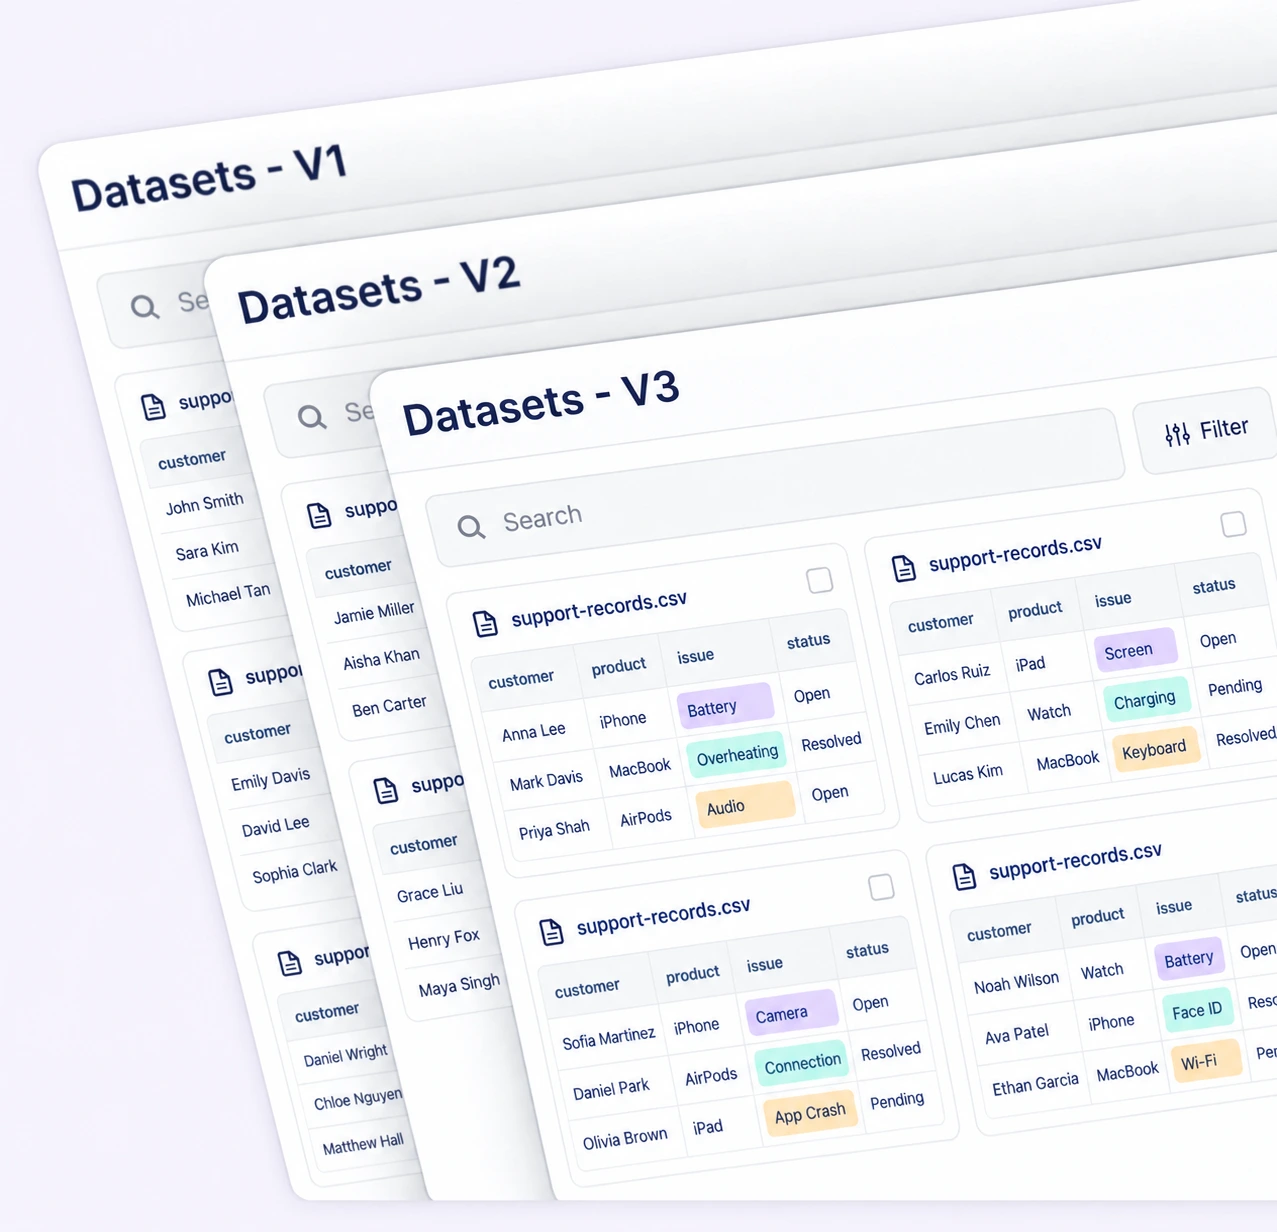
테이블 데이터의 변화에 맞춰 데이터셋 버전을 생성하고 관리합니다. 원본 레코드, 어노테이션 변경, 검토된 릴리스의 이력을 연결해 재현 가능한 학습을 지원합니다.
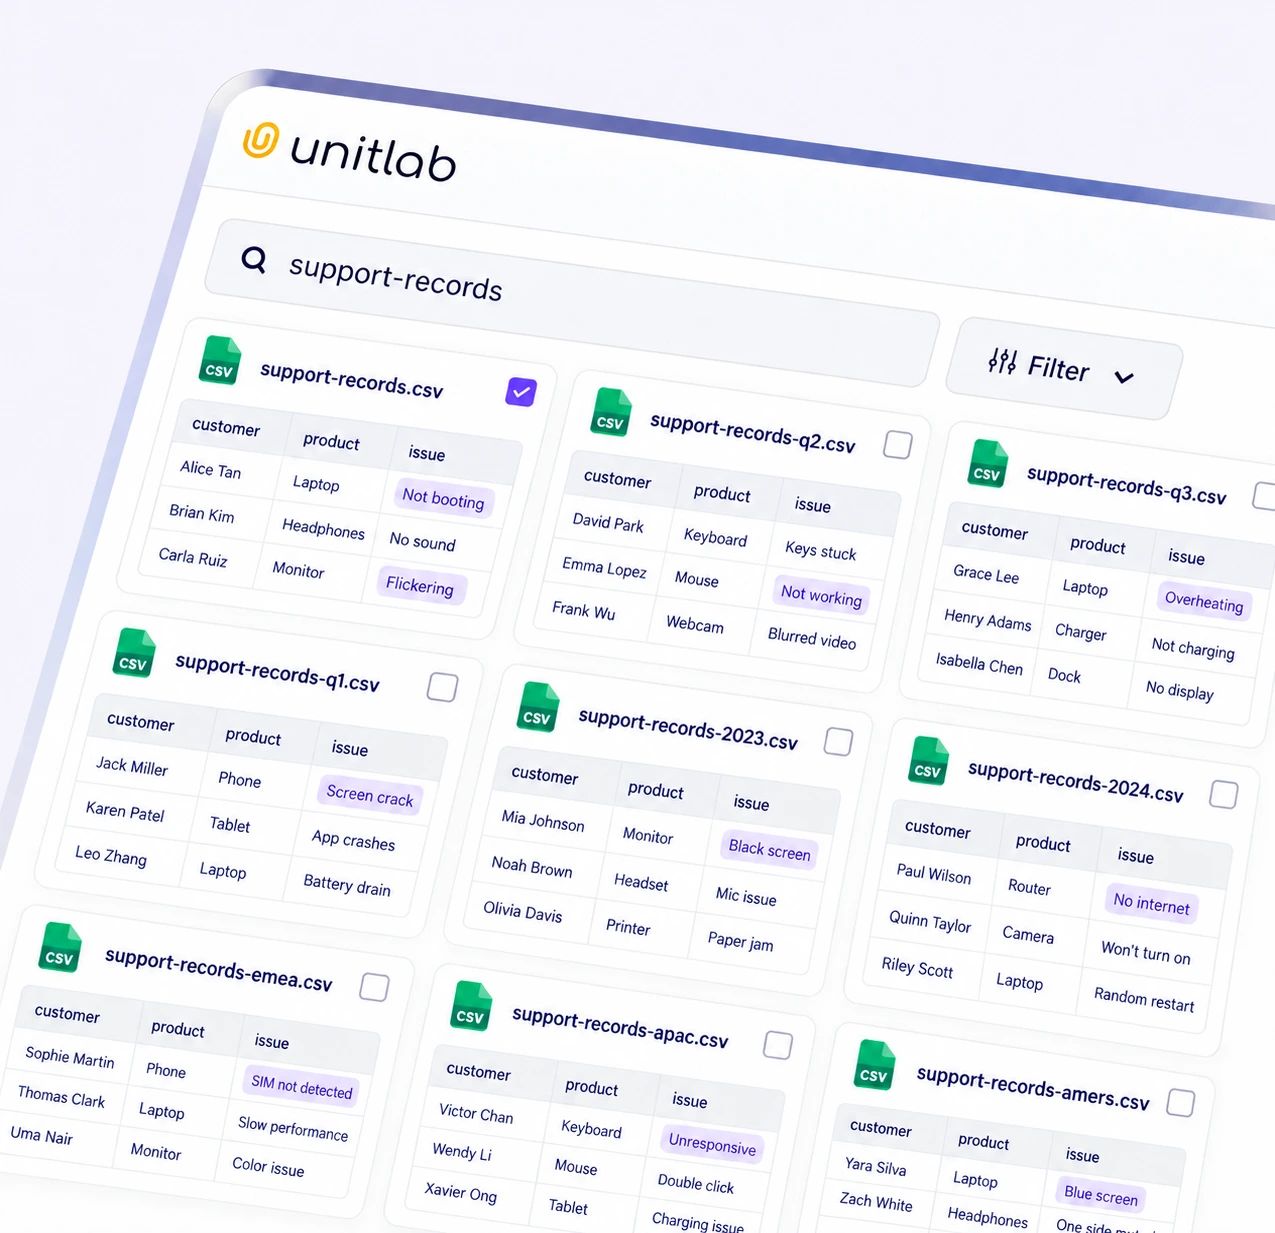
검색, 메타데이터, 태그, 필터로 관련 CSV 자산을 찾습니다. 어노테이션이나 검토를 배정하기 전에 필요한 레코드를 선별하세요.
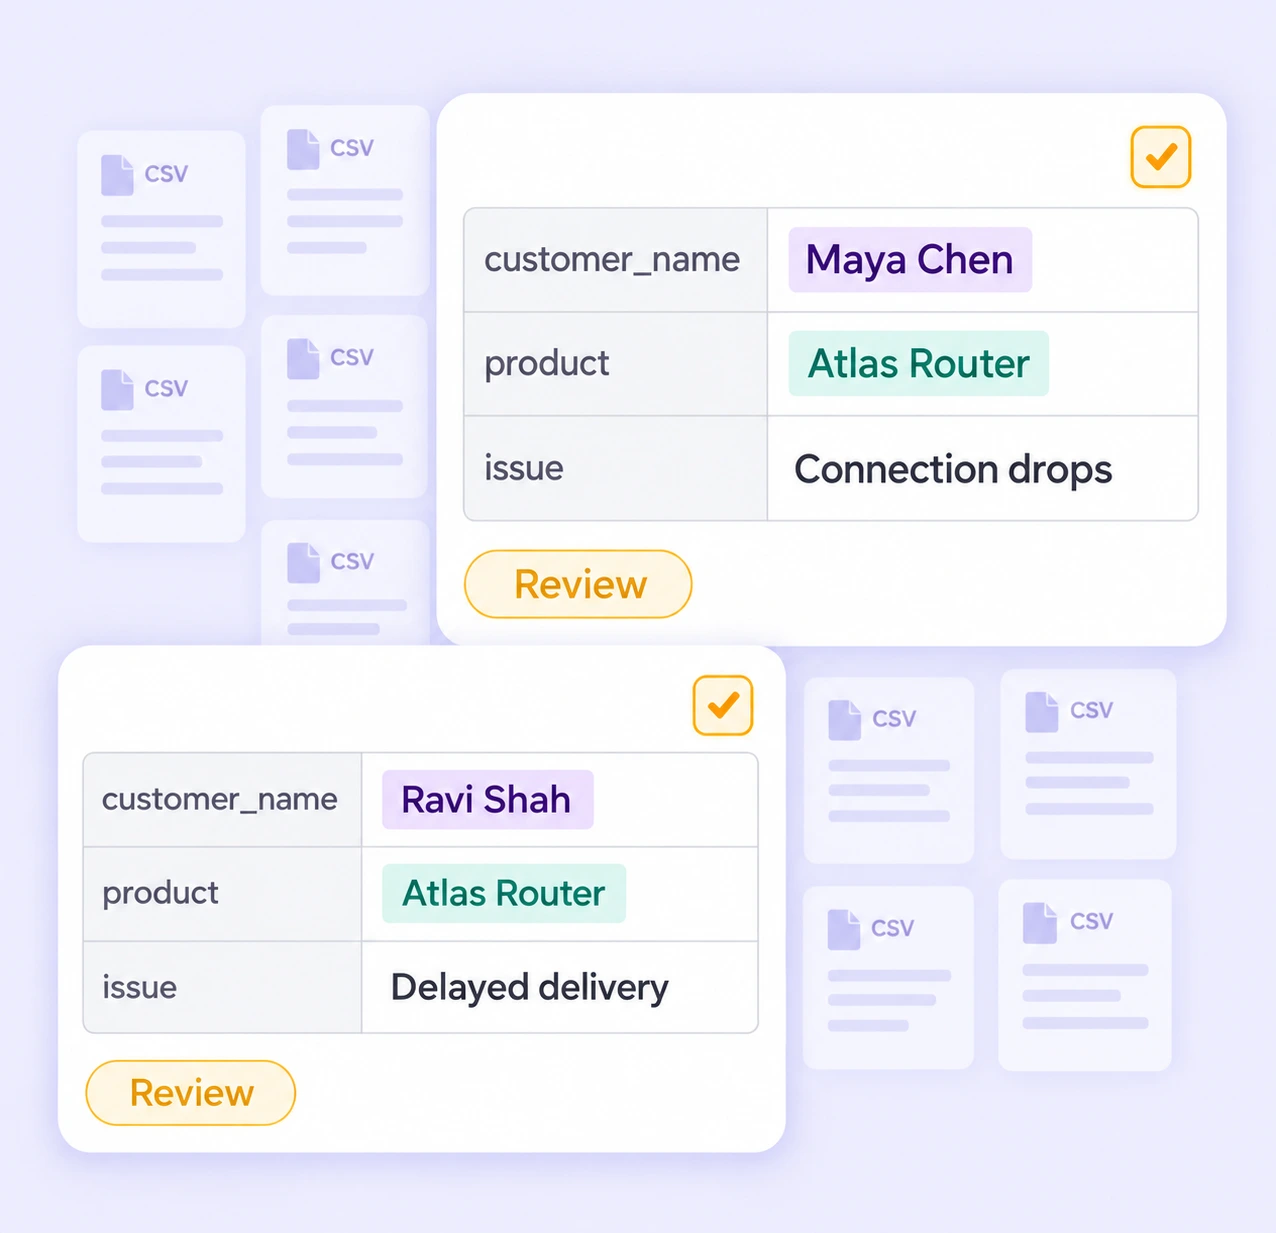
어노테이션 전에 CSV 필드와 샘플 행을 미리 봅니다. 원본 맥락을 유지하며 확인이 필요한 레코드와 라벨을 검토하세요.
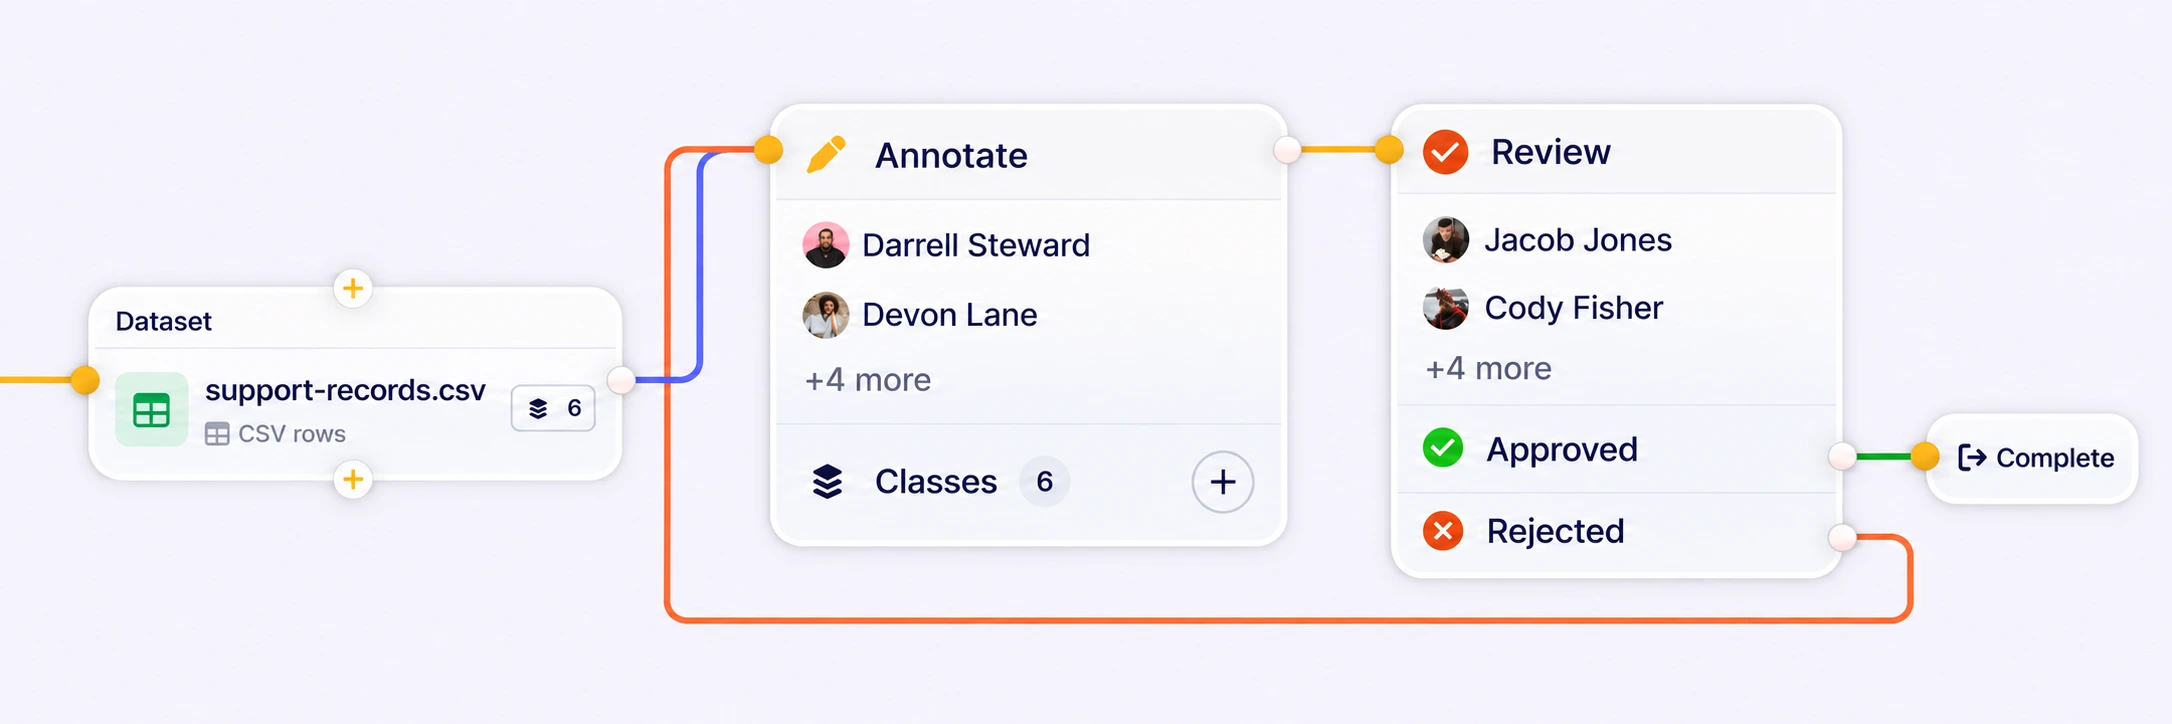
레코드를 어노테이션, 검토, 재작업, 완료 단계로 전달합니다. 각 단계에서 작업 배정과 품질 판단의 연결을 유지하세요.
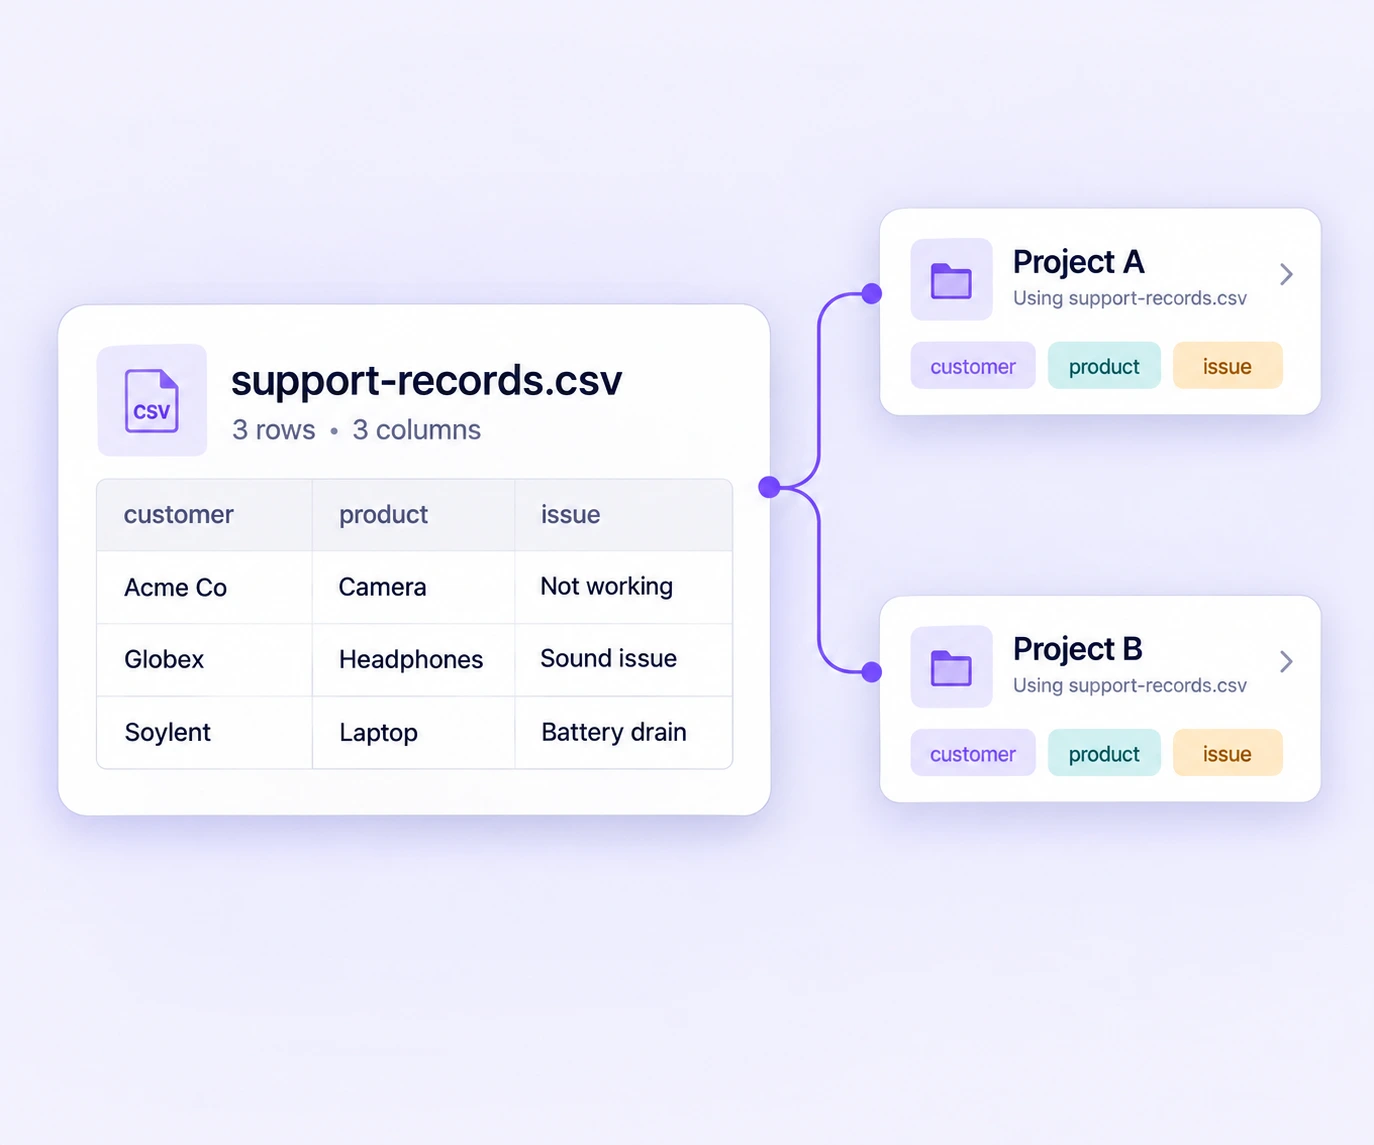
여러 프로젝트에서 원본 CSV를 재사용하고 작업에 맞는 해석 방식을 선택합니다. 원본 자산을 보존하면서 프로젝트별 라벨과 워크플로를 관리하세요.
고객 지원 인텔리전스, 제품 이해, 필드 추출을 위한 라벨링된 레코드와 품질이 관리된 AI 데이터셋을 준비합니다.
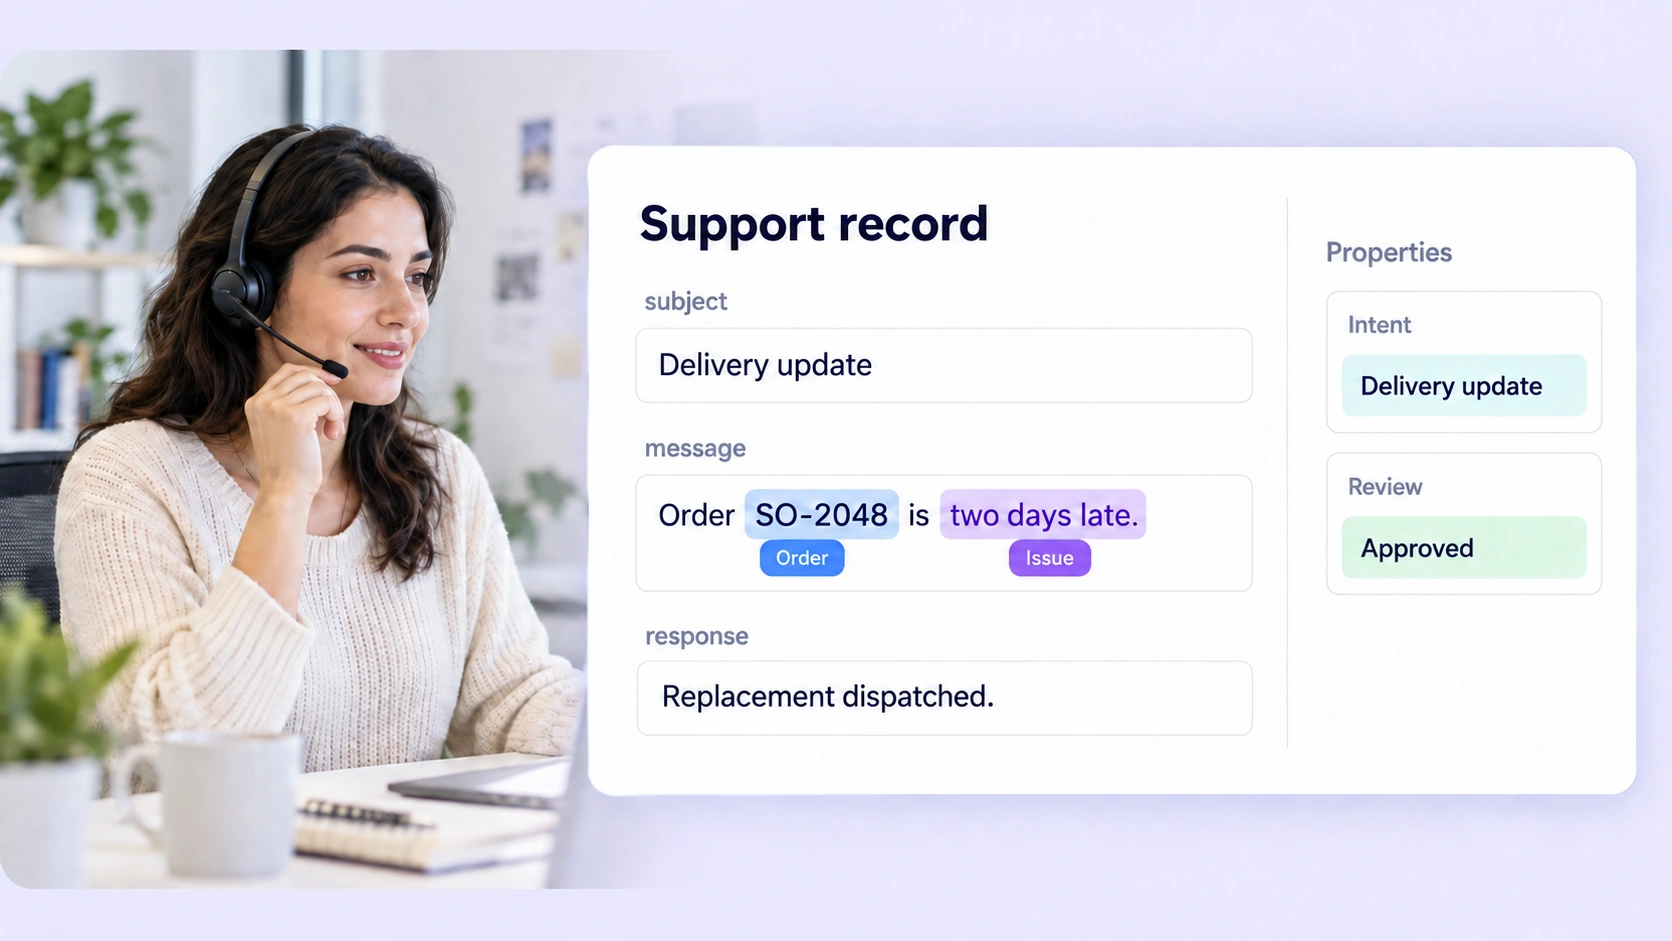
고객 지원 레코드의 여러 필드에 걸쳐 고객, 제품, 의도, 문제를 라벨링해 라우팅 및 문제 해결 모델의 학습을 지원합니다.
Explore support intelligence →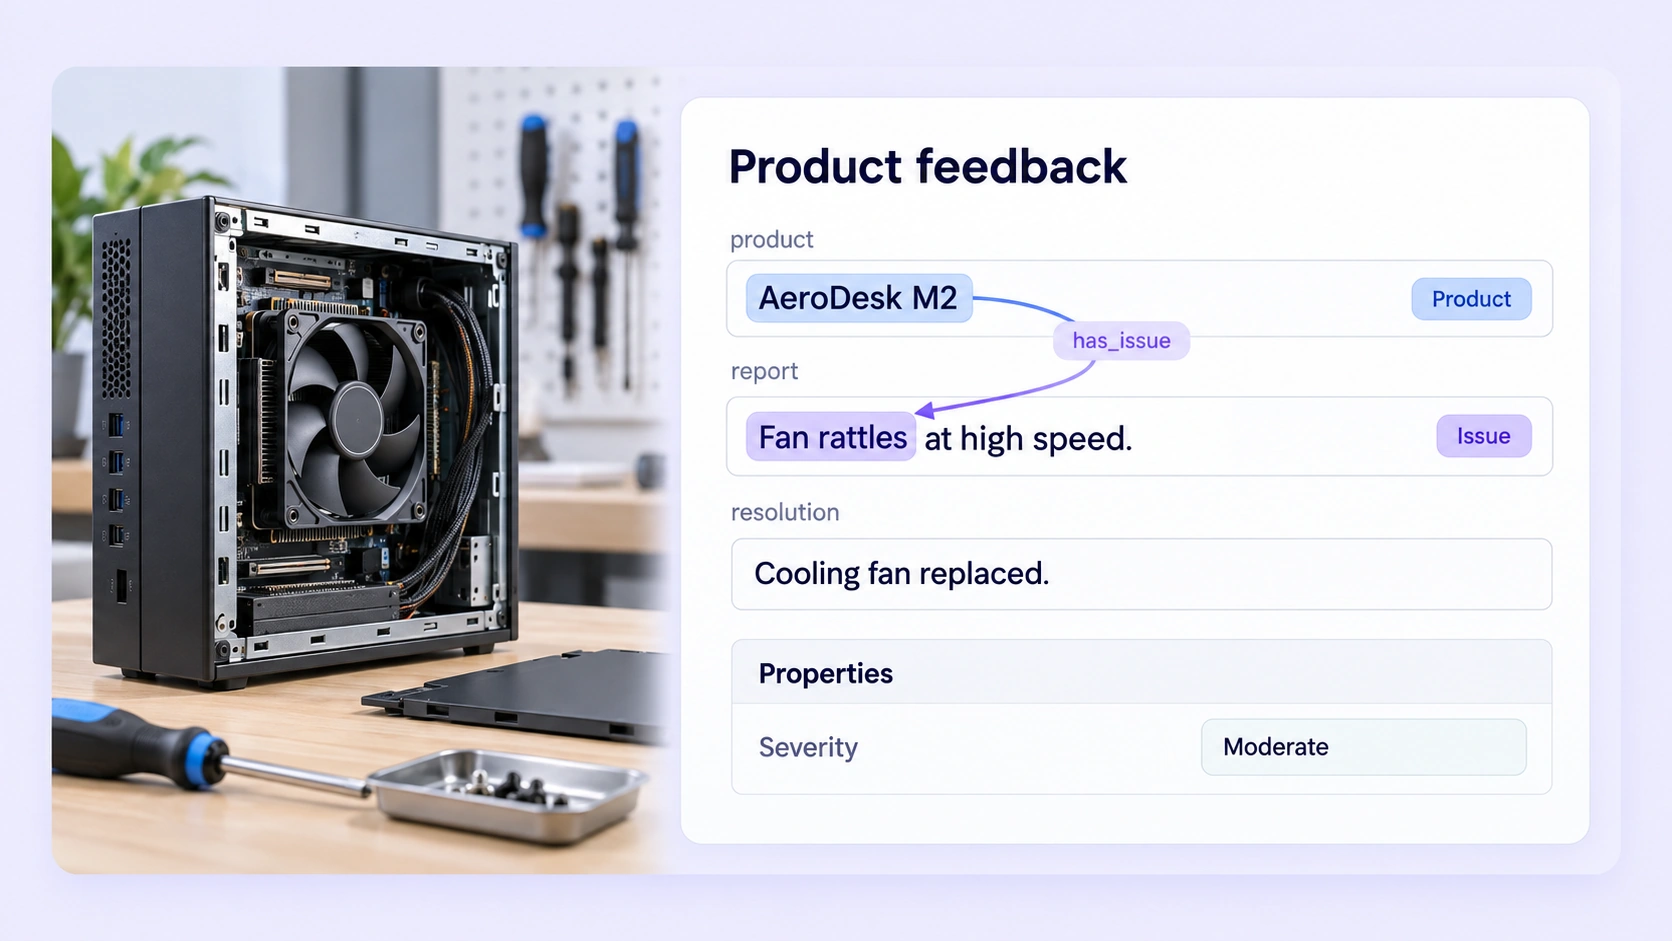
각 레코드에서 제품과 보고된 문제를 연결해 관계가 명확한 학습 데이터를 만듭니다.
Explore product understanding →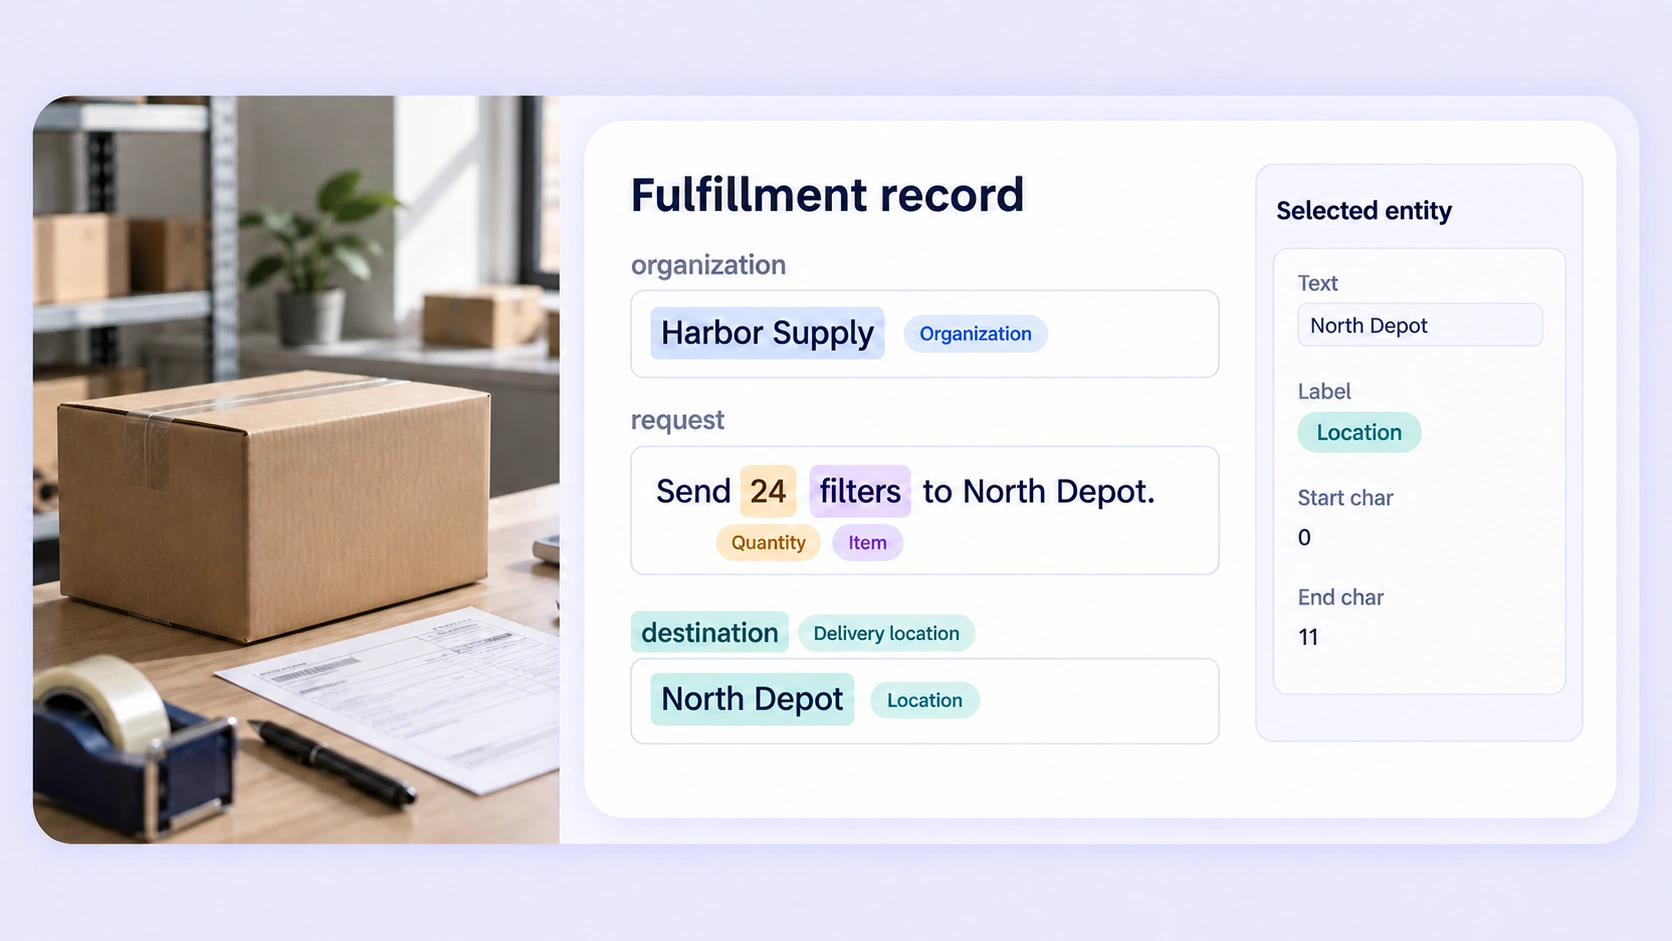
업무용 CSV 레코드의 엔티티와 필드 의미를 라벨링하며 원본 열의 맥락을 유지합니다.
Explore field extraction →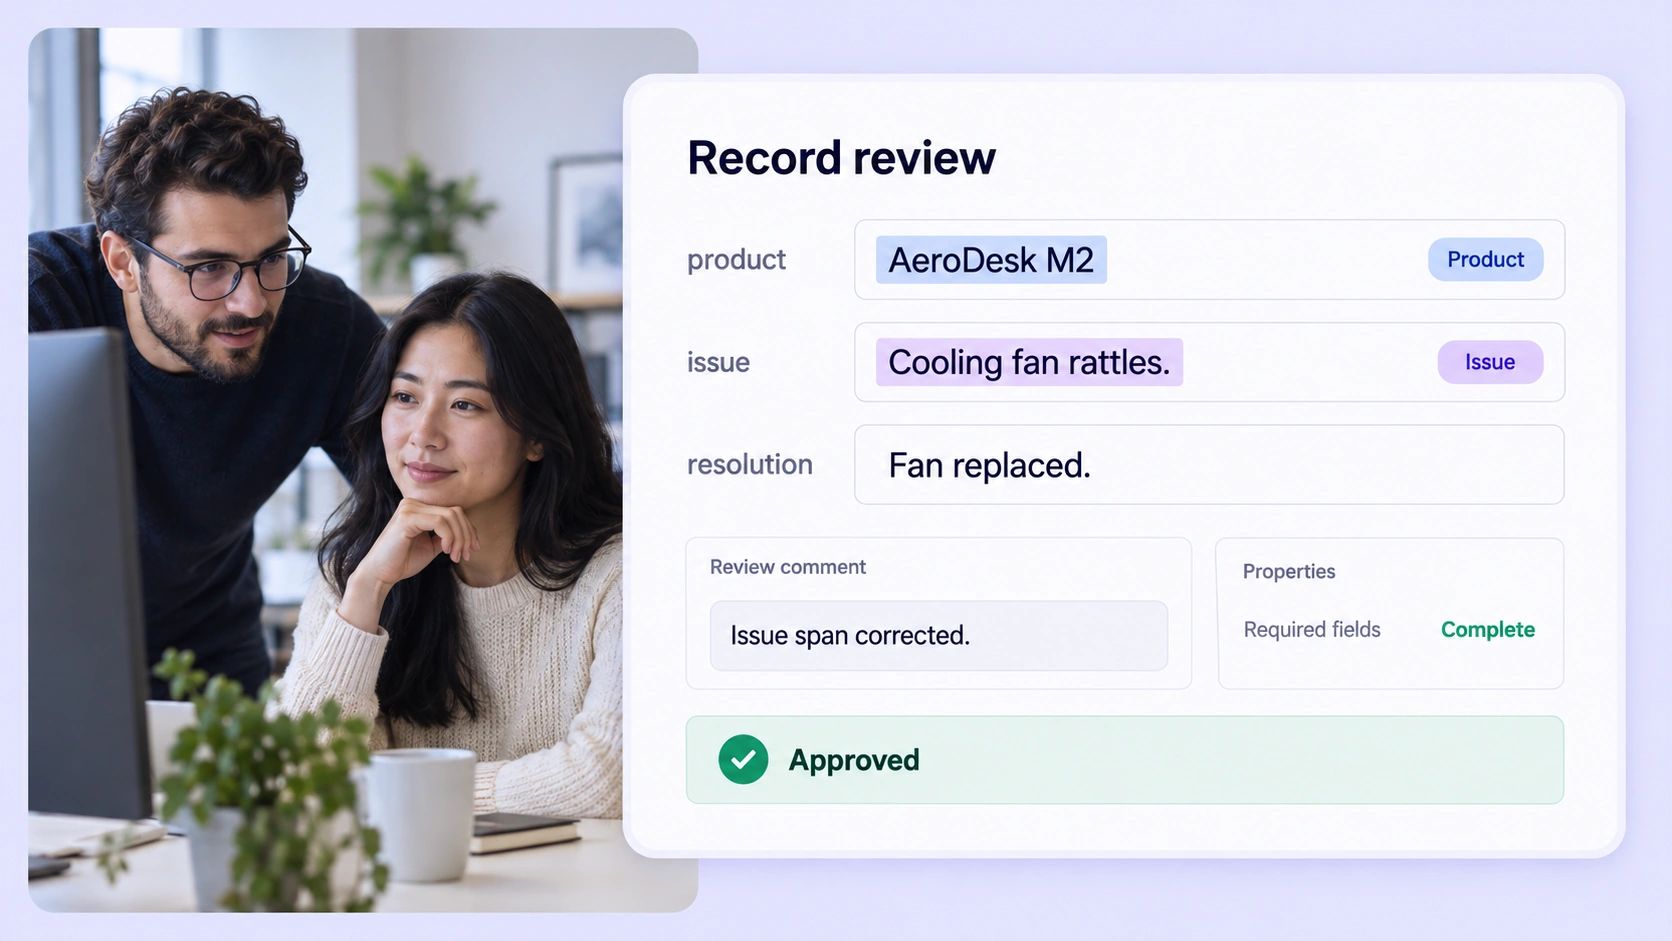
레코드 단위 라벨을 검토하고 의견 차이를 해결한 뒤, 후속 모델 개발을 위한 일관된 구조화 데이터셋을 릴리스합니다.
Explore tabular data quality →CSV 레코드, 셀과 헤더 라벨, 필드 관계, 공유 온톨로지, 품질 검토, 구조화된 어노테이션 내보내기를 알아보세요.
Unitlab 팀과 상담하기테이블 데이터 어노테이션은 구조화된 레코드와 필드 내부의 텍스트에 라벨을 추가하는 작업입니다. Unitlab은 CSV 행을 어노테이션 작업으로 전환해 레코드 분류, 엔티티 라벨링, 필드 간 정보 연결을 지원합니다.
표 형식 데이터 어노테이션 가이드Unitlab은 행 모드의 CSV 파일을 지원합니다. 각 행은 별도의 어노테이션 항목이 되며, 라벨링과 검토에 필요한 열 이름과 값이 보존됩니다.
표 형식 데이터 어노테이션 가이드네. 모든 텍스트 열에서 엔티티를 라벨링할 수 있습니다. 각 어노테이션에 열 정보와 문자 오프셋이 보존되므로, 서로 다른 필드의 동일한 텍스트 위치도 명확하게 구분됩니다.
표 형식 데이터 어노테이션 가이드네. 온톨로지에 정의된 관계를 사용해 같은 레코드의 여러 필드에 있는 라벨링된 엔티티, 열 라벨, 헤더 텍스트 범위를 연결할 수 있습니다.
표 형식 데이터 어노테이션 가이드레코드는 어노테이션, 검토, 재작업, 완료 단계를 거칩니다. 검토자는 맥락 속에서 라벨과 속성을 확인하고 댓글로 문제를 해결합니다. 설정된 워크플로에서는 합의나 승인된 기준 어노테이션을 적용할 수 있습니다.
검토 단계테이블 모드는 CSV의 각 행을 개별 레코드로 처리합니다. 시계열 모드는 CSV 전체를 X축과 수치 채널이 있는 차트로 표시합니다. 프로젝트 설정에서 작업에 맞는 해석 방식을 선택할 수 있습니다.
센서 어노테이션 가이드JSONL 내보내기는 레코드당 한 줄로 구성되며, 행 값, 열 스키마, 라벨링된 엔티티, 관계, 지원되는 레코드 속성을 포함합니다. 필드 식별 정보와 문자 범위도 어노테이션과 함께 보존됩니다.
내보내기 문서


