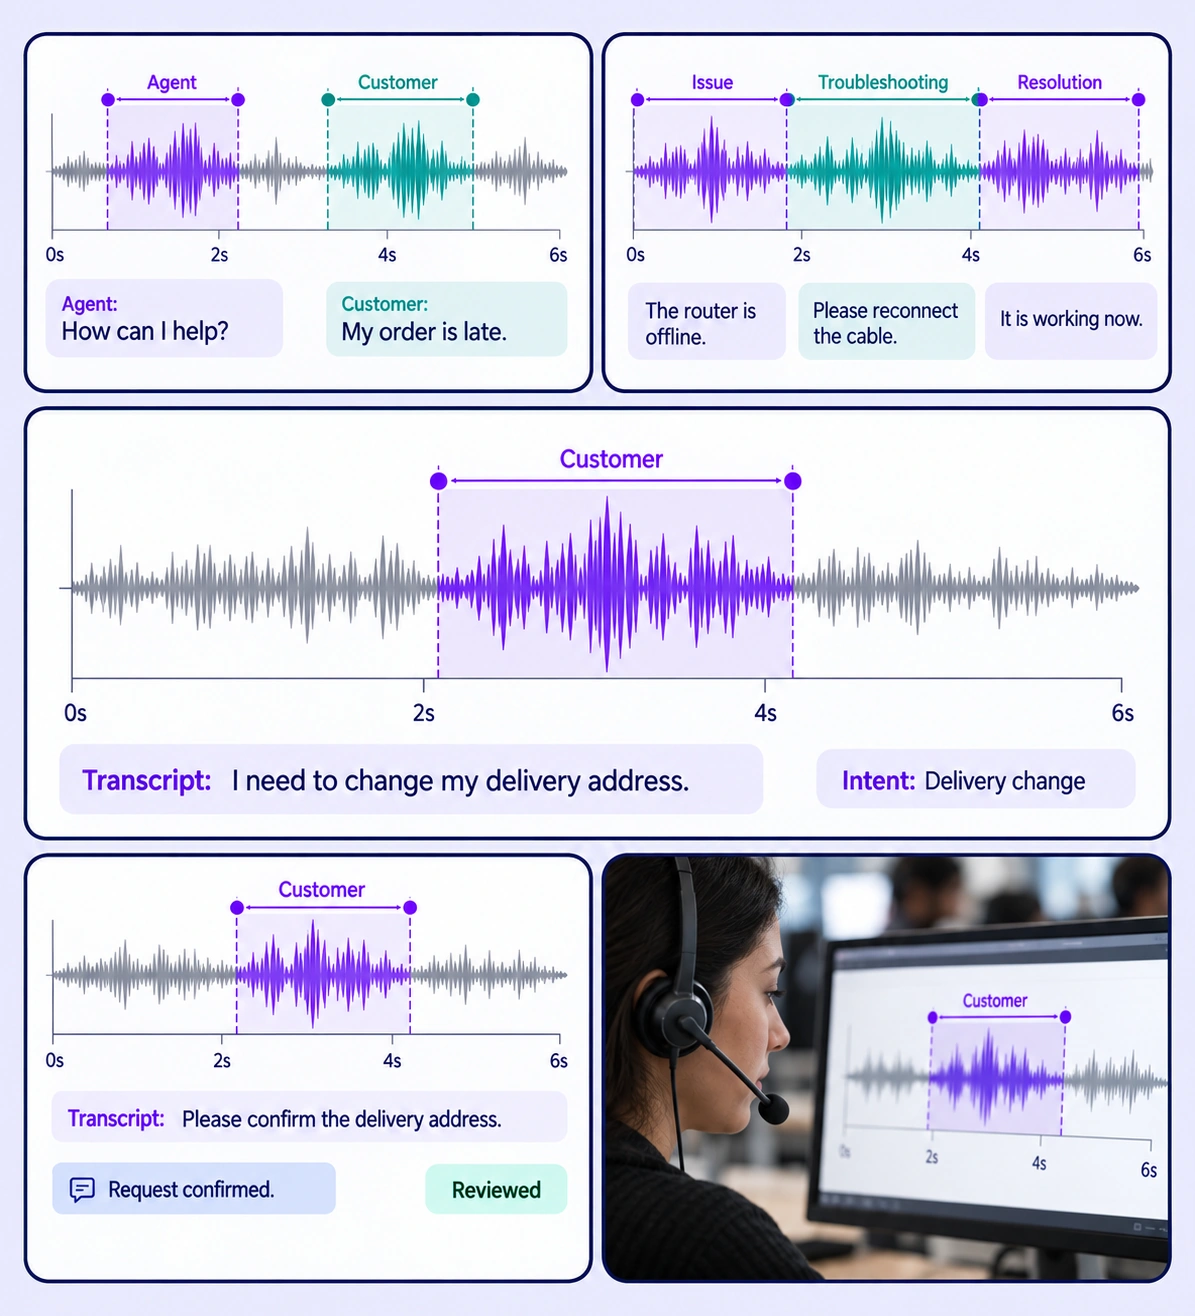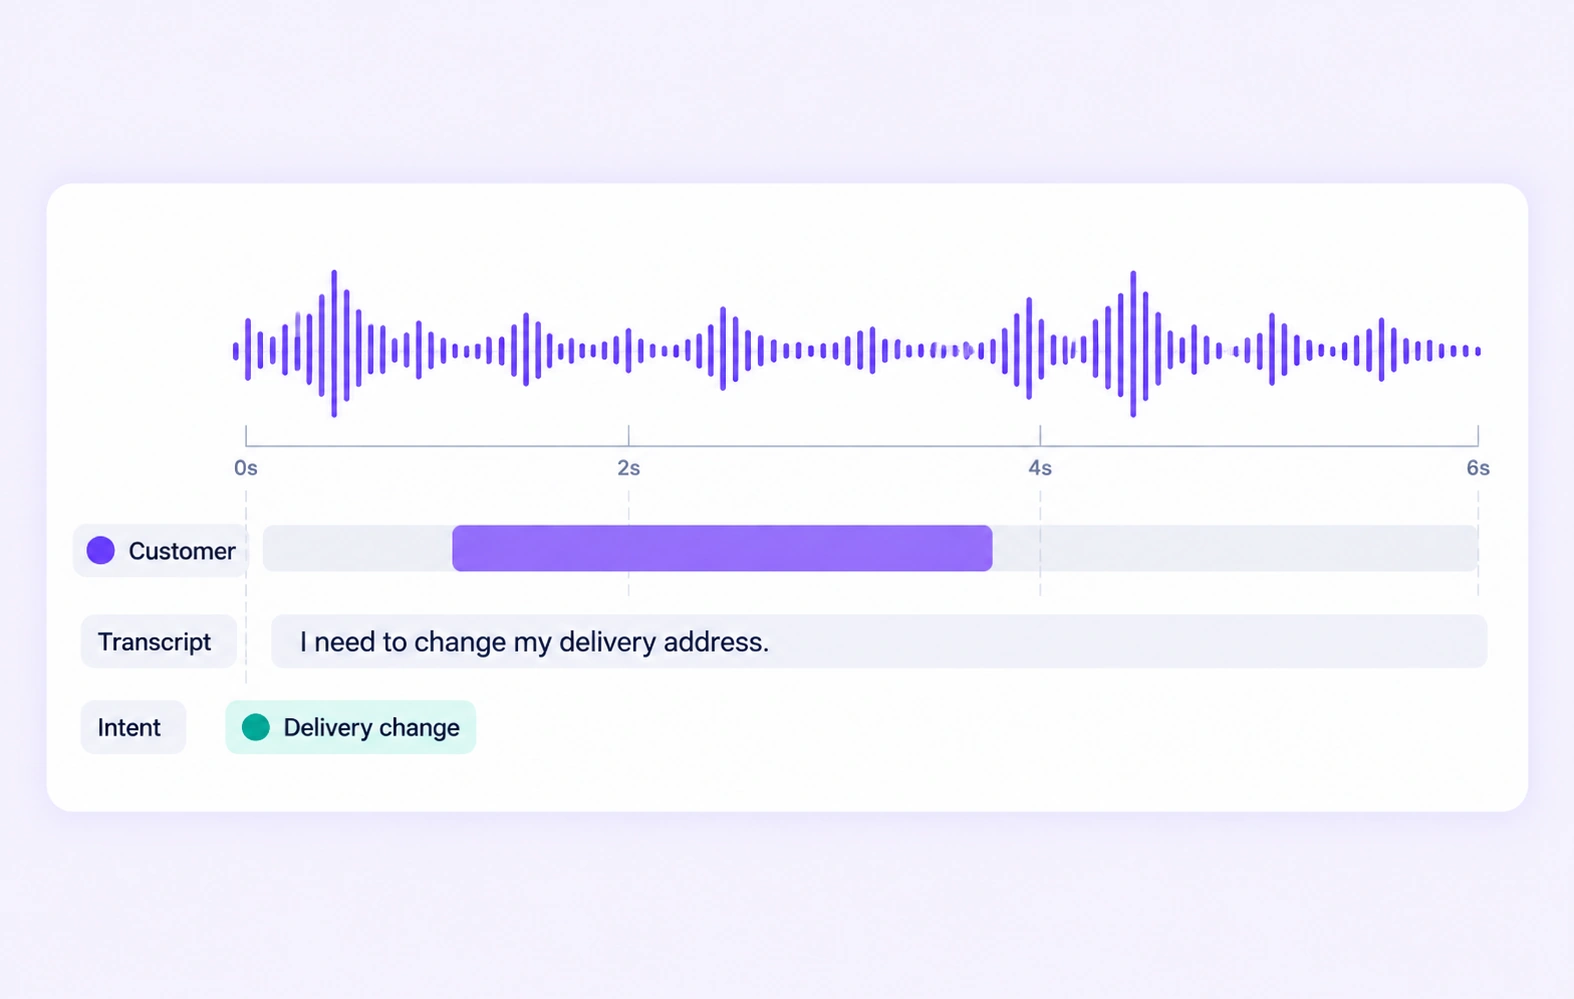
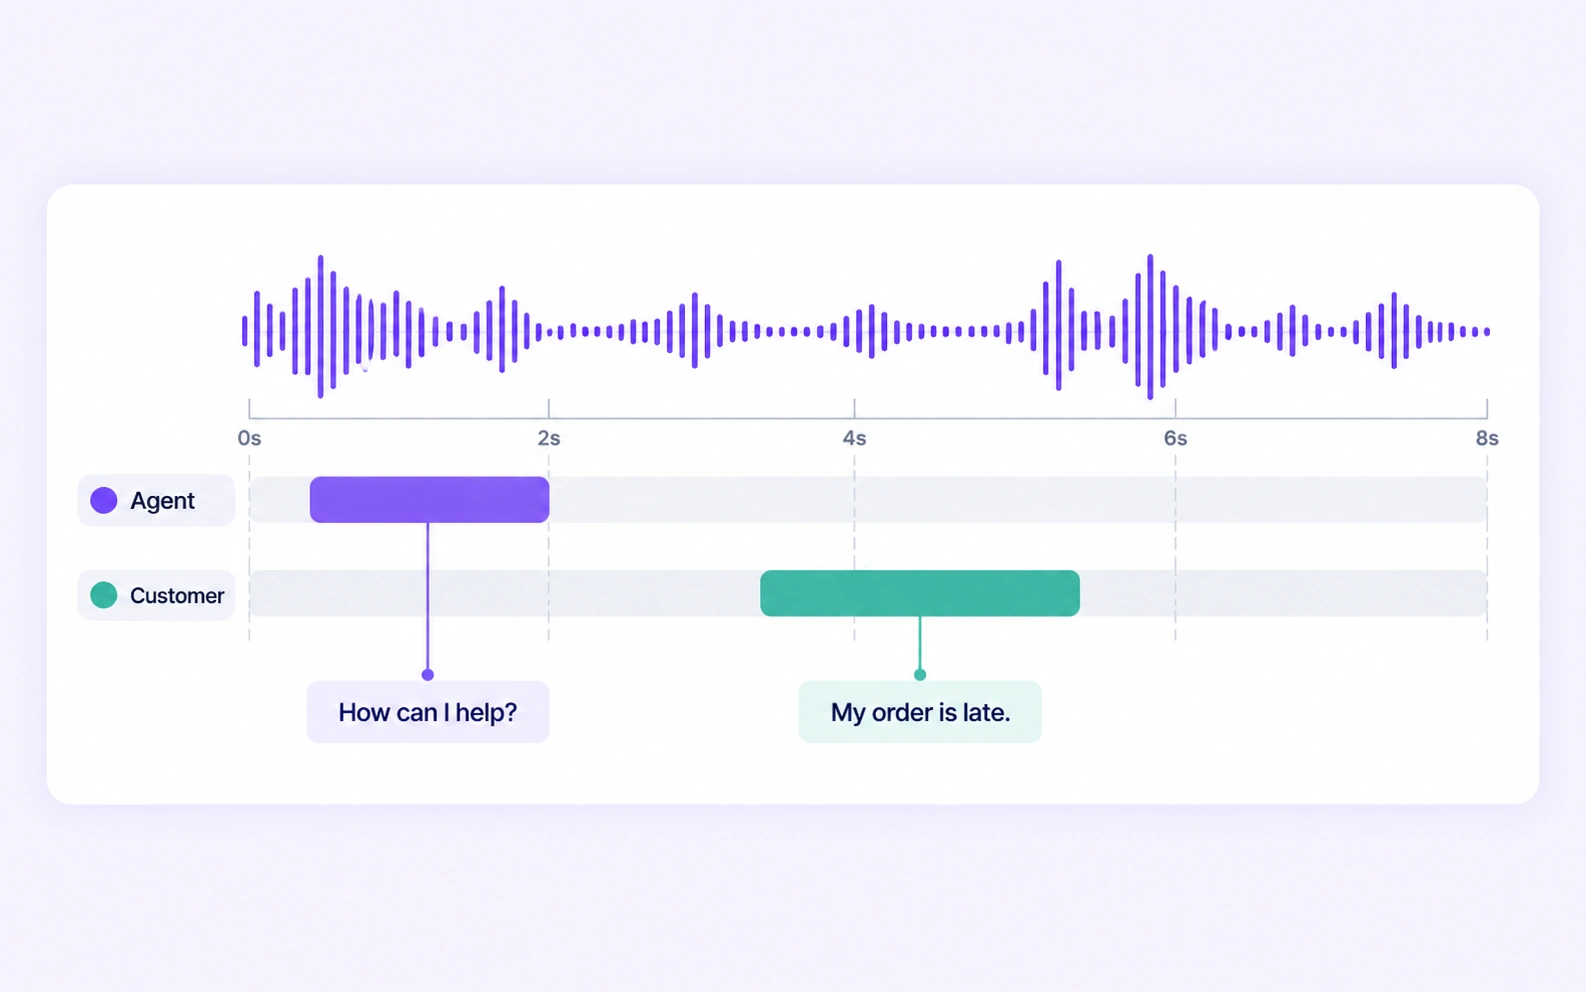
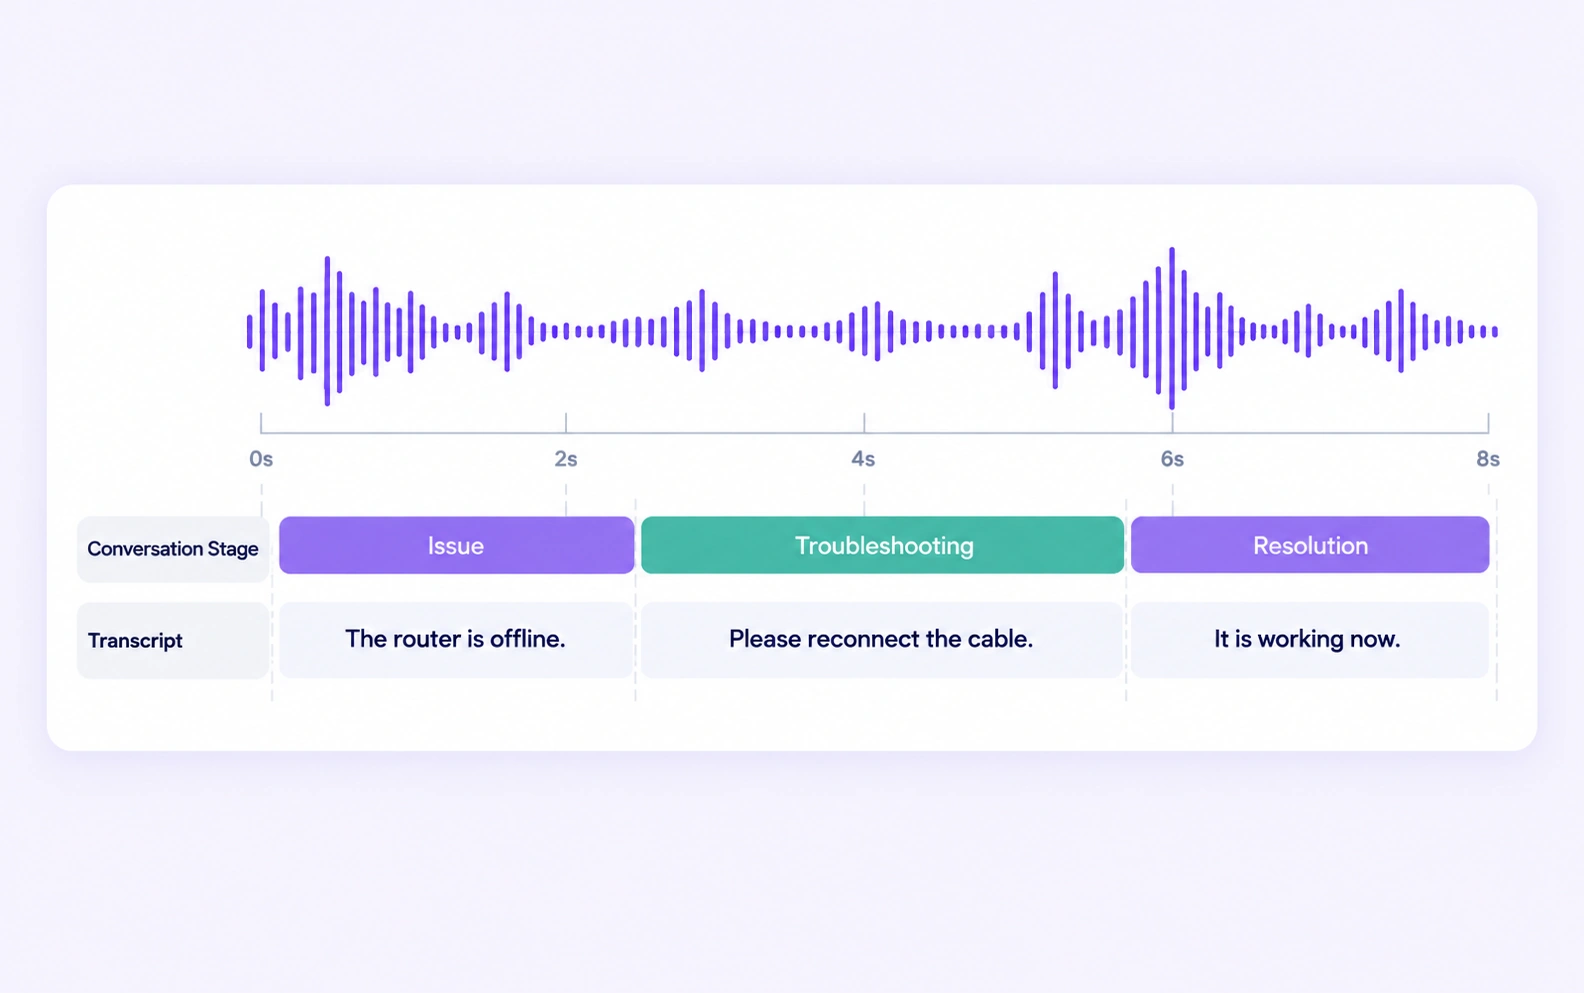
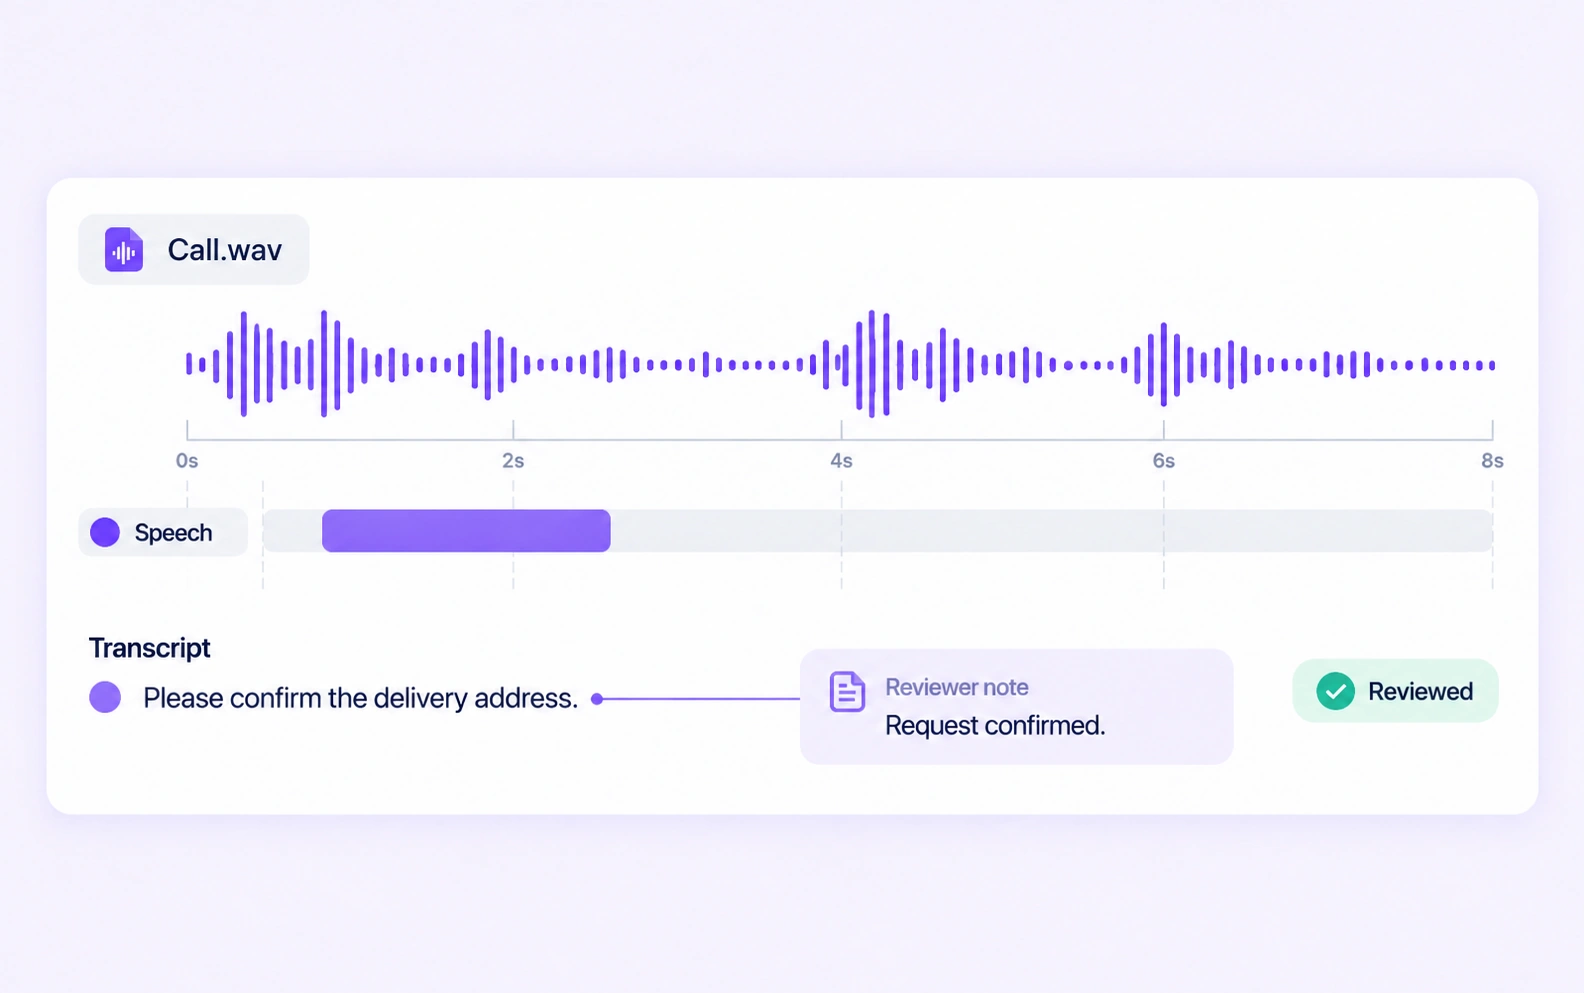
将转写文本和说话人角色属性关联到正确的时间区间。对照原始通话审核文字和发言轮次边界。
使用结构化标签描述客户明确表达的请求和已定义的对话状态。保留转写文本中支持这些标签的原始表述。
常见训练数据包括时间对齐的转写文本、坐席与客户的发言轮次、客户意图,以及已定义的问题或解决阶段。Unitlab 将这些标签与原始通话录音和审核流程关联起来。
可以。定义意图类别,以客户明确表达的请求为依据,标注相关录音或语音区间。对含糊不清或包含多种意图的对话采用明确规则进行审核。
可以。带有时间信息的音频标注可包含转写和角色属性。审核人员可以同时检查文字、说话人标签和时间区间。
可以。定义可观察的对话阶段,并标注相关时间区间或属性。标注指南应明确说明每个阶段需要哪些证据支持。
此工作流保留通话音频、说话人时间信息和口语上下文。表格型客服记录标注则标记结构化客服记录中的字段及关系。
开始工作前定义共用类别、结构化属性和清晰的标注指南。通过代表性样本和结合上下文的审核,解决联络中心语音智能数据集中的标注分歧。
可以。将音频标注流转至审核和返工阶段。审核人员可以检查源数据、修正标签,并在需要进一步处理时退回该数据项。
可以。利用数据集搜索、元数据、标签和可用筛选条件选择相关音频资产。在准备过程中保留对代表性条件和困难样本的可见性。
根据标注任务,以支持的 Audio JSON、RTTM 或 UUEF 格式导出已审核的音频标签。数据集版本有助于团队确认哪些已准备样本属于某次发布。