自然语言处理标注质量保证

让文本标签准确表达语言模型需要学习的任务。结合原文审核文本片段边界、实体关系、类别选择与缺失属性。
Person and organization span review surrounded by text and document context.

在文本标签错误扩散前发现问题

借助共享本体和明确的标注示例,将语言歧义转化为可执行的审核决定。
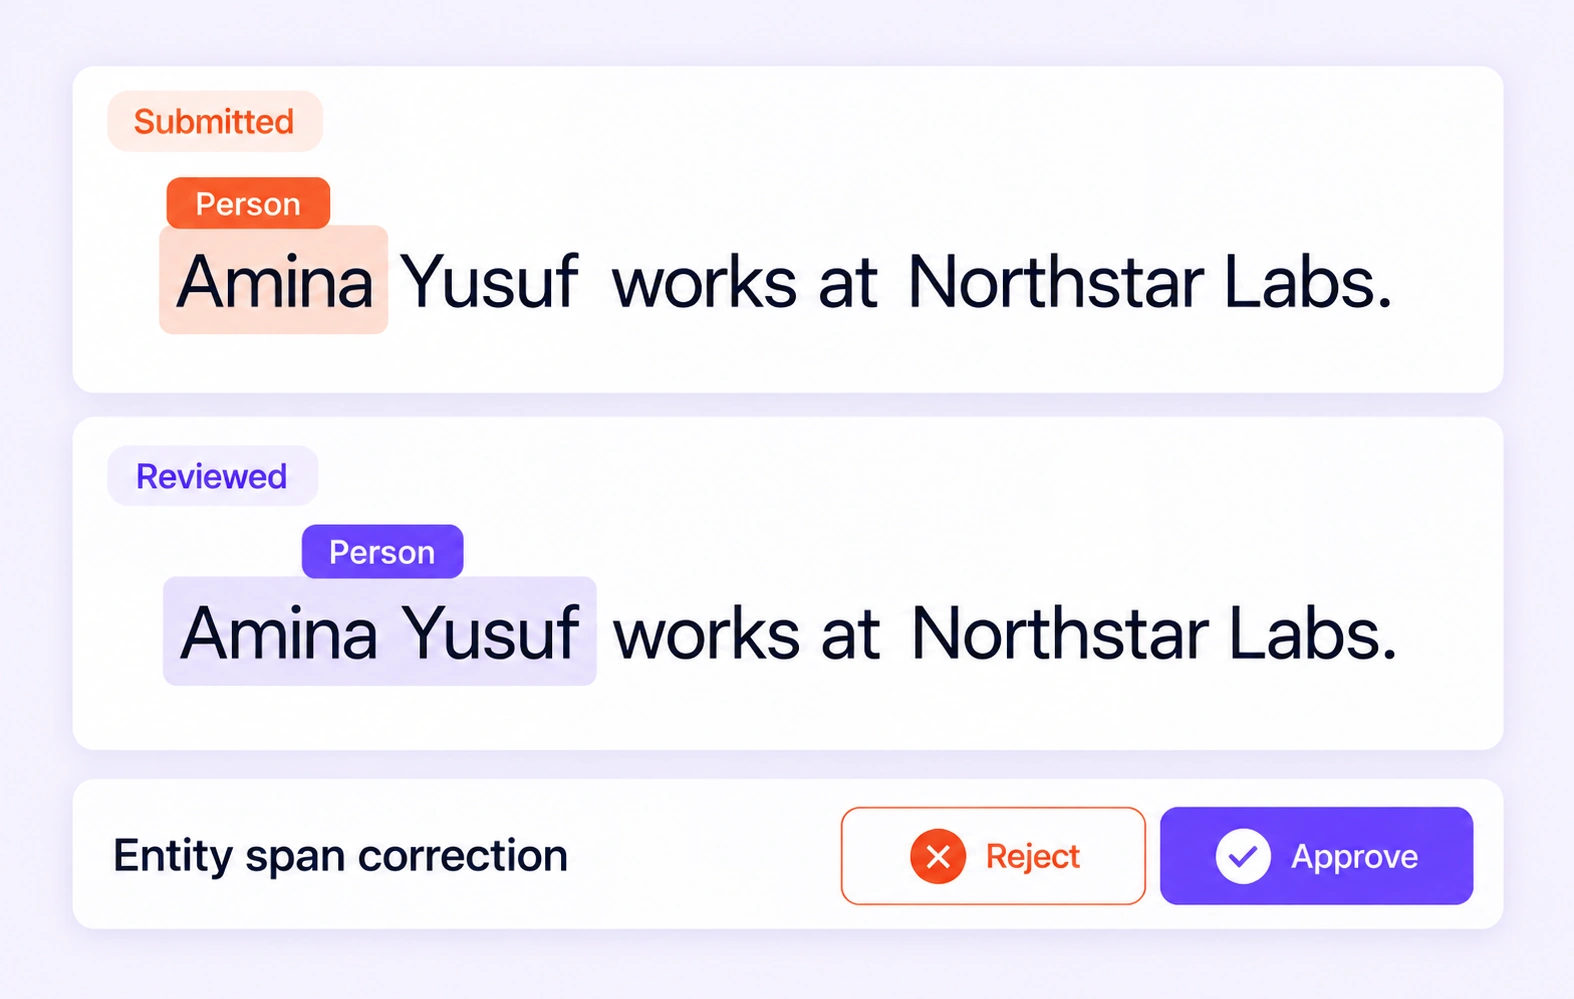
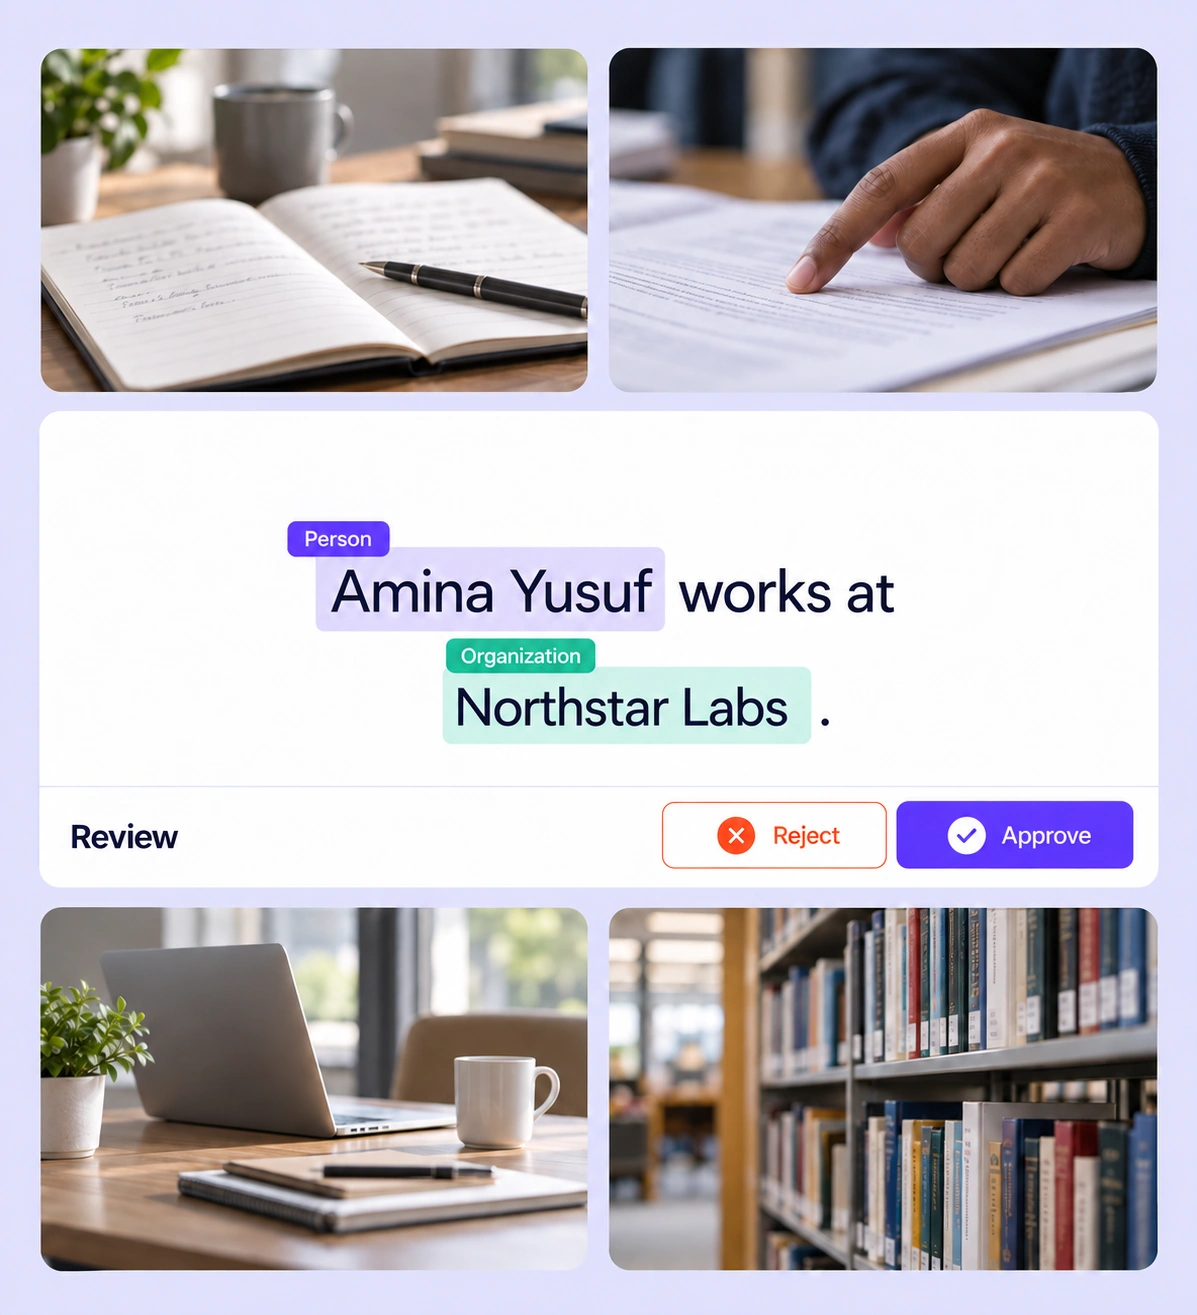
A partial person entity span is expanded to include the complete name Amina Yusuf.

实体片段边界

确认每个实体包含所需词语,并排除无关标点或上下文。修正不完整的名称、过长的片段及遗漏的实体。
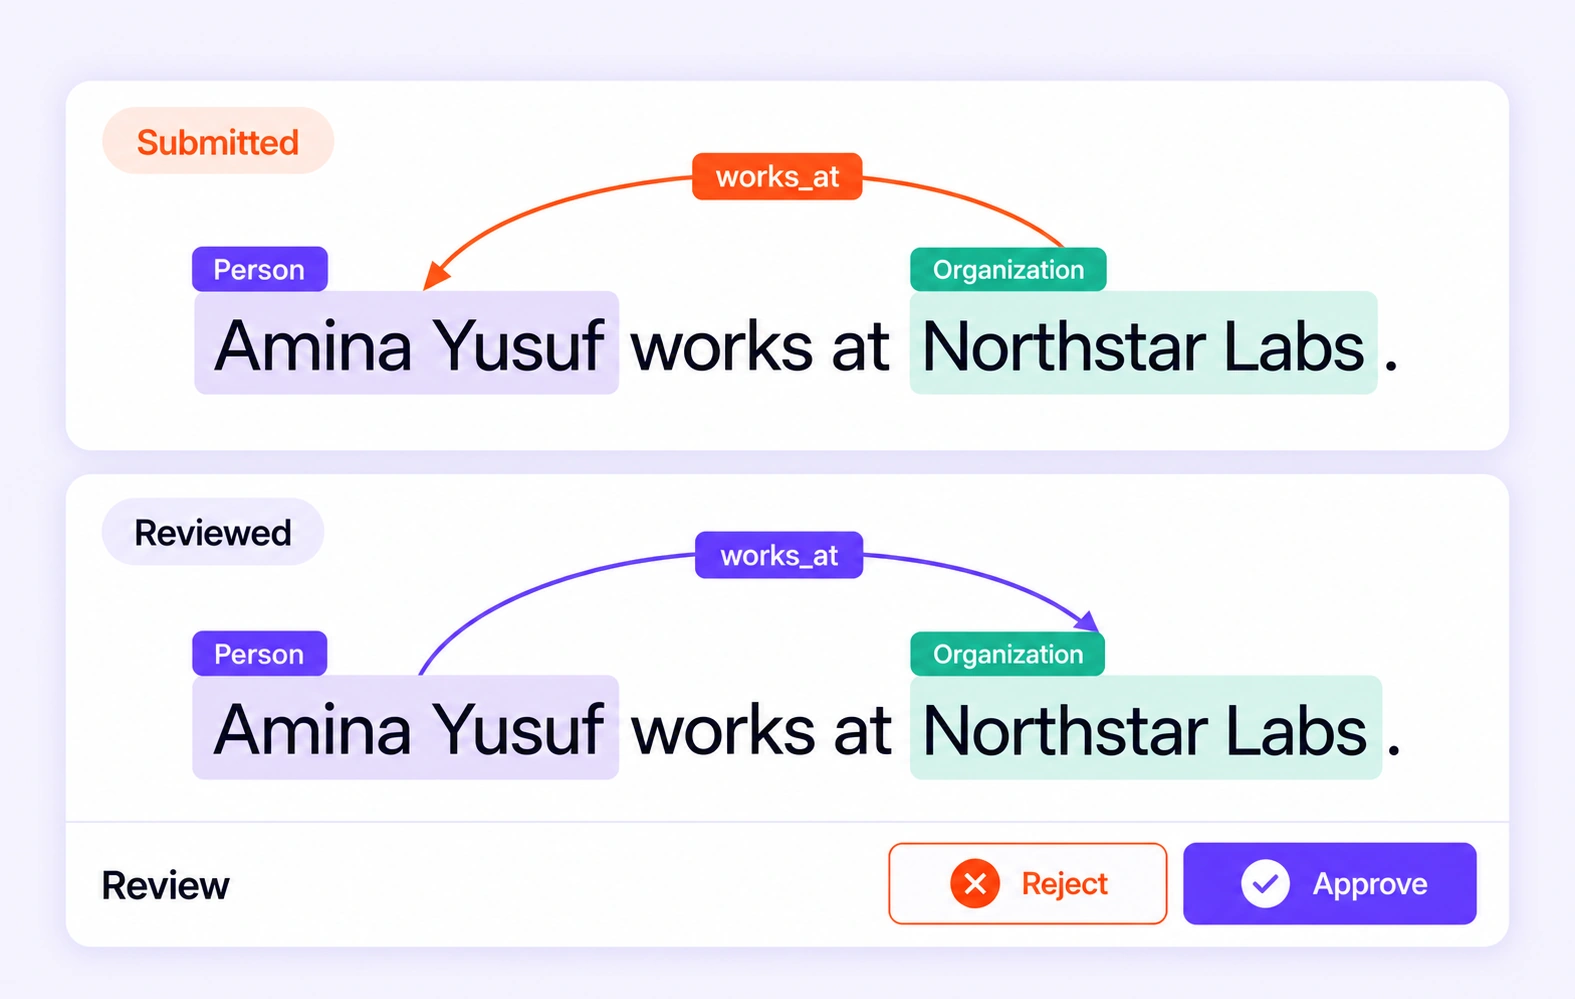
A reversed works_at relation is corrected to point from the person to the organization.

关系端点与方向

确认关系以正确的标签和方向连接目标实体,修正反向关系及错误连接的端点。
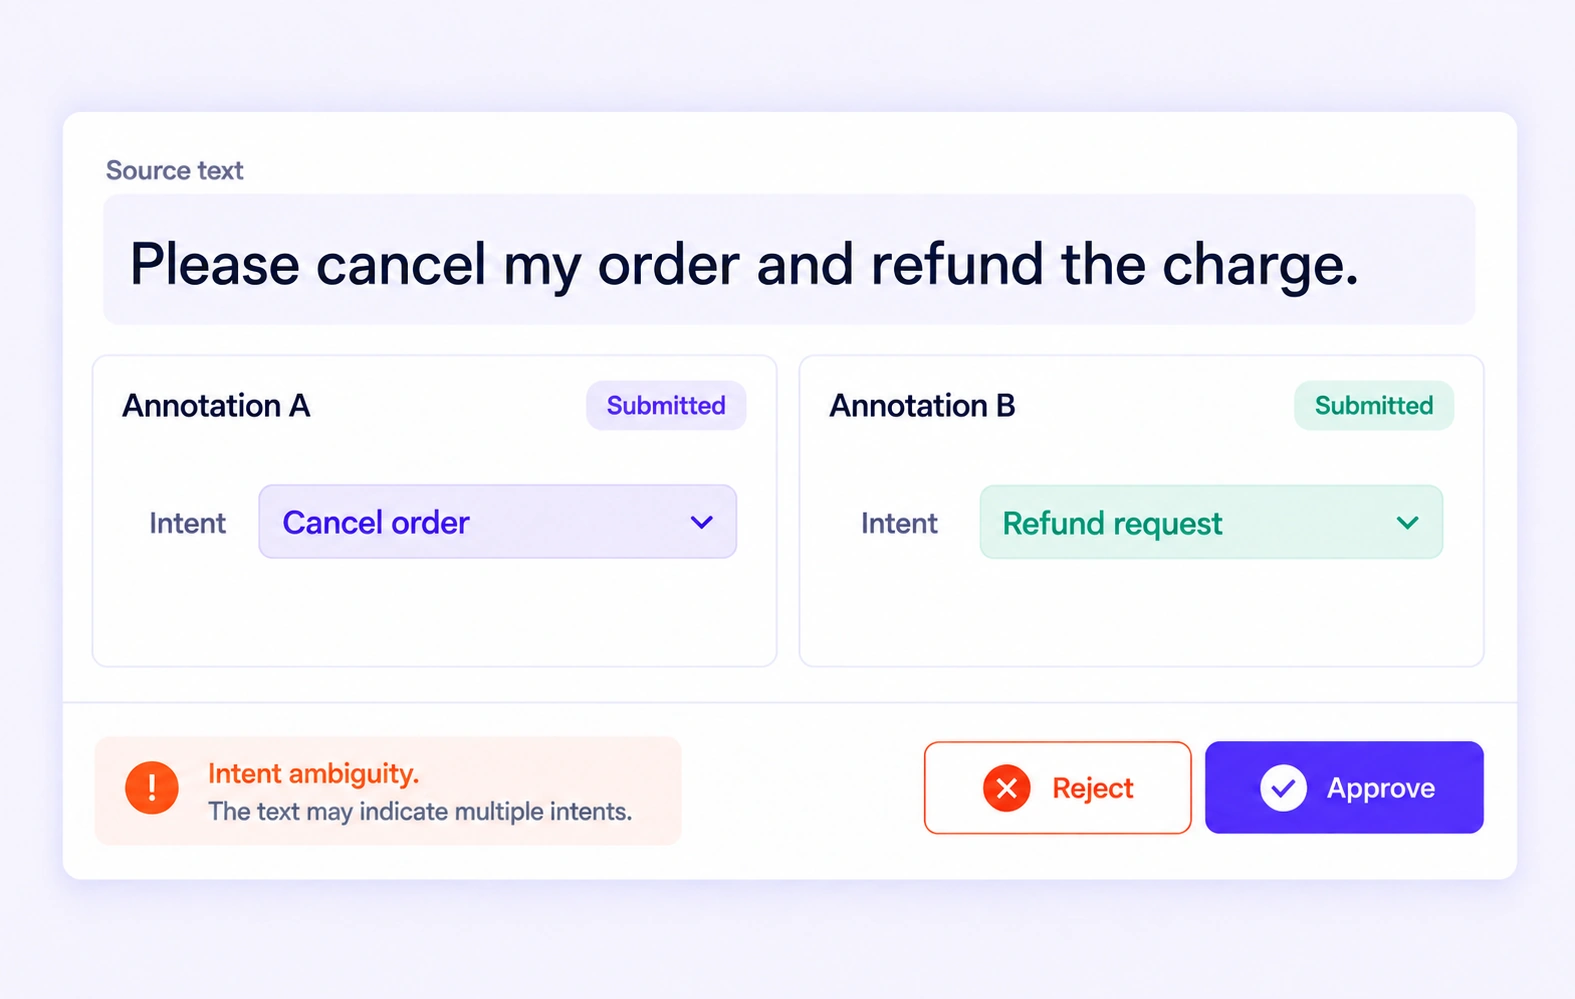
Two independent intent labels for the same cancellation and refund request await review.

意图与类别歧义

选择类别前检查完整文本,审核处于不同意图边界的示例,并在整个数据集中使用一致的定义。
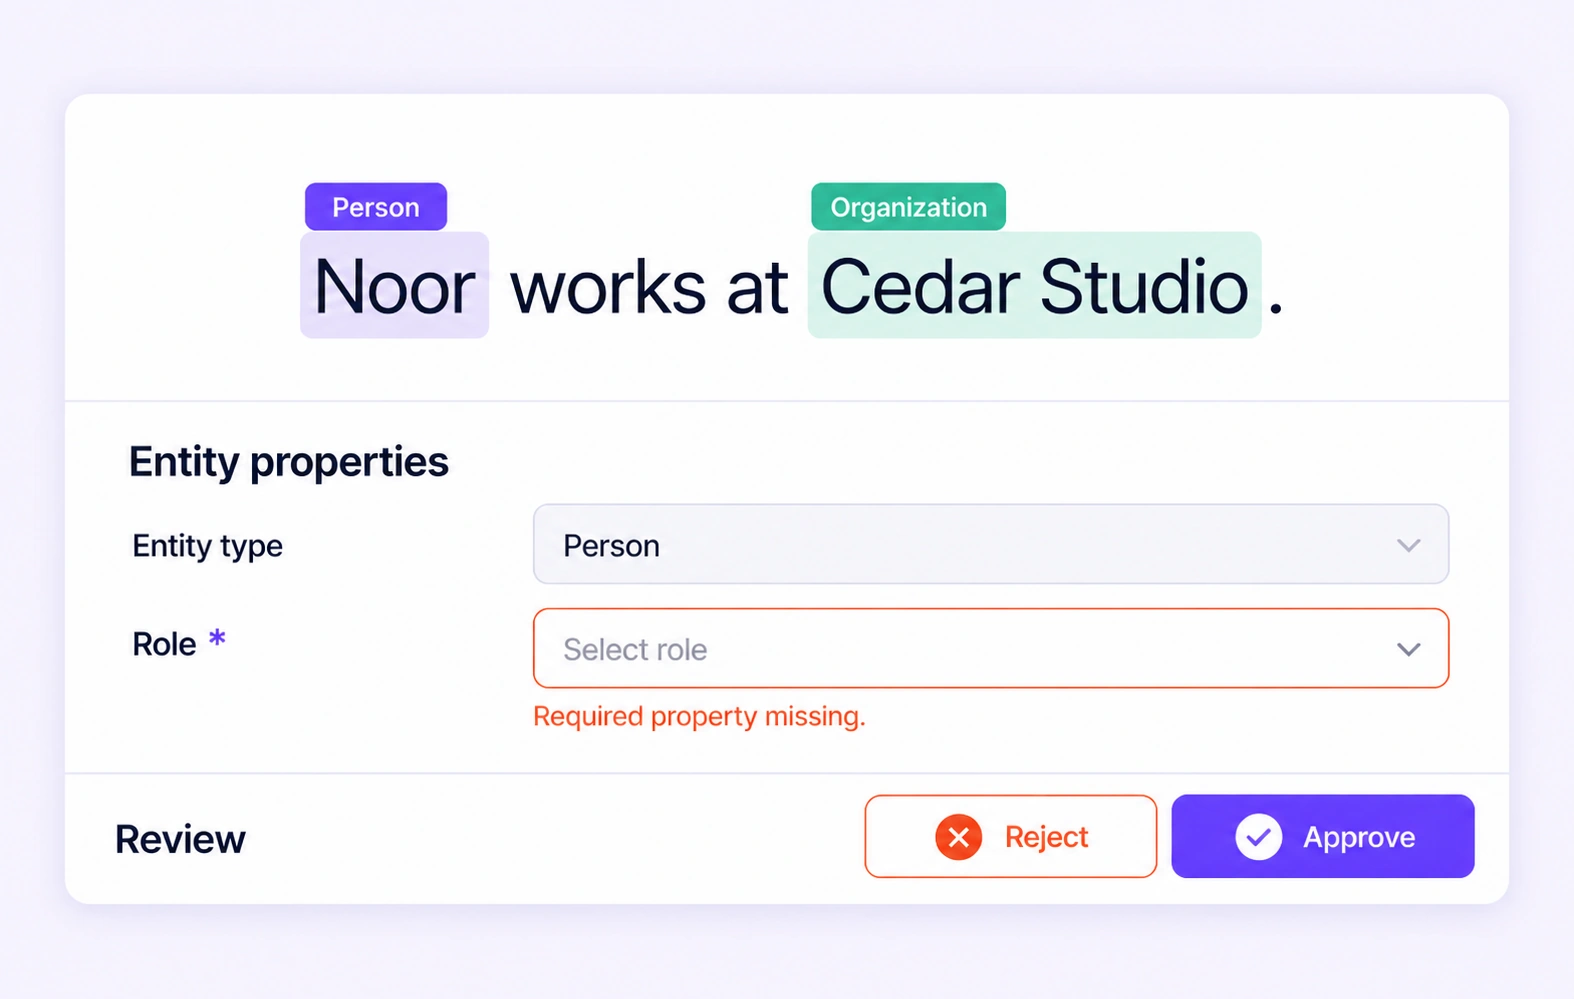
An entity annotation has an empty required Role property highlighted for review.

完整且有效的属性

审核实体或数据项的必填属性及本体校验结果,在批准数据项之前补全缺失值并修正不一致的选项。
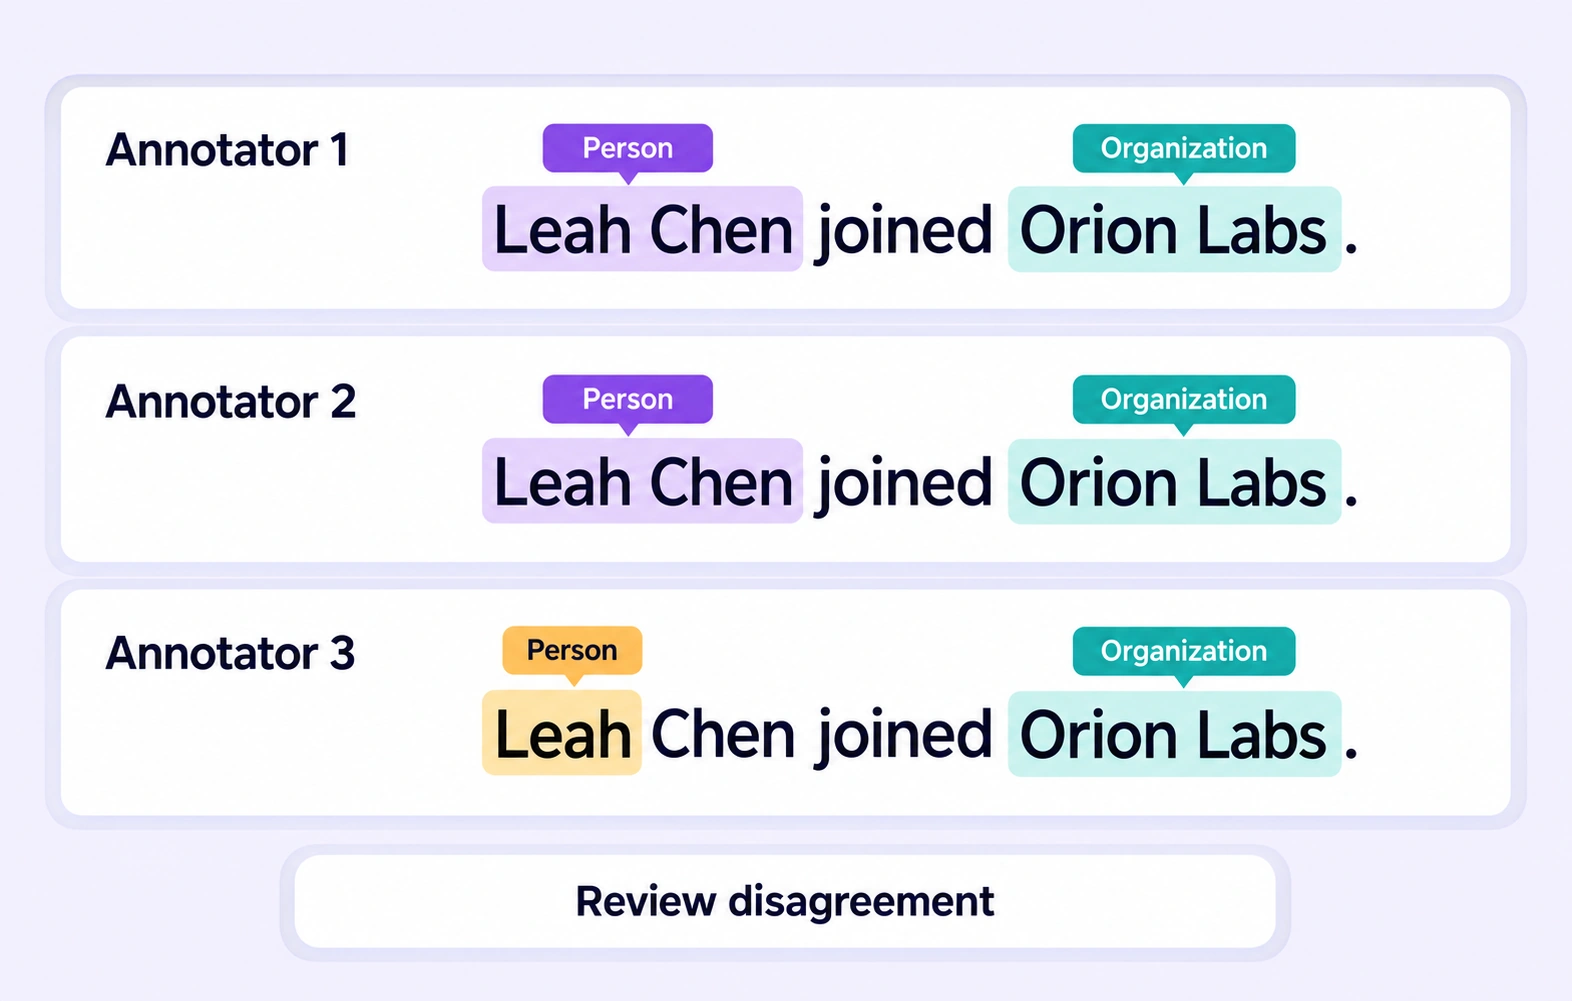
Three reviewers label the same sentence; one Person span omits Chen while the other two cover Leah Chen.

共识

收集同一文本的独立标签,比较片段边界、实体类别或数据项类别,并将分歧连同原文上下文一起提交审核。
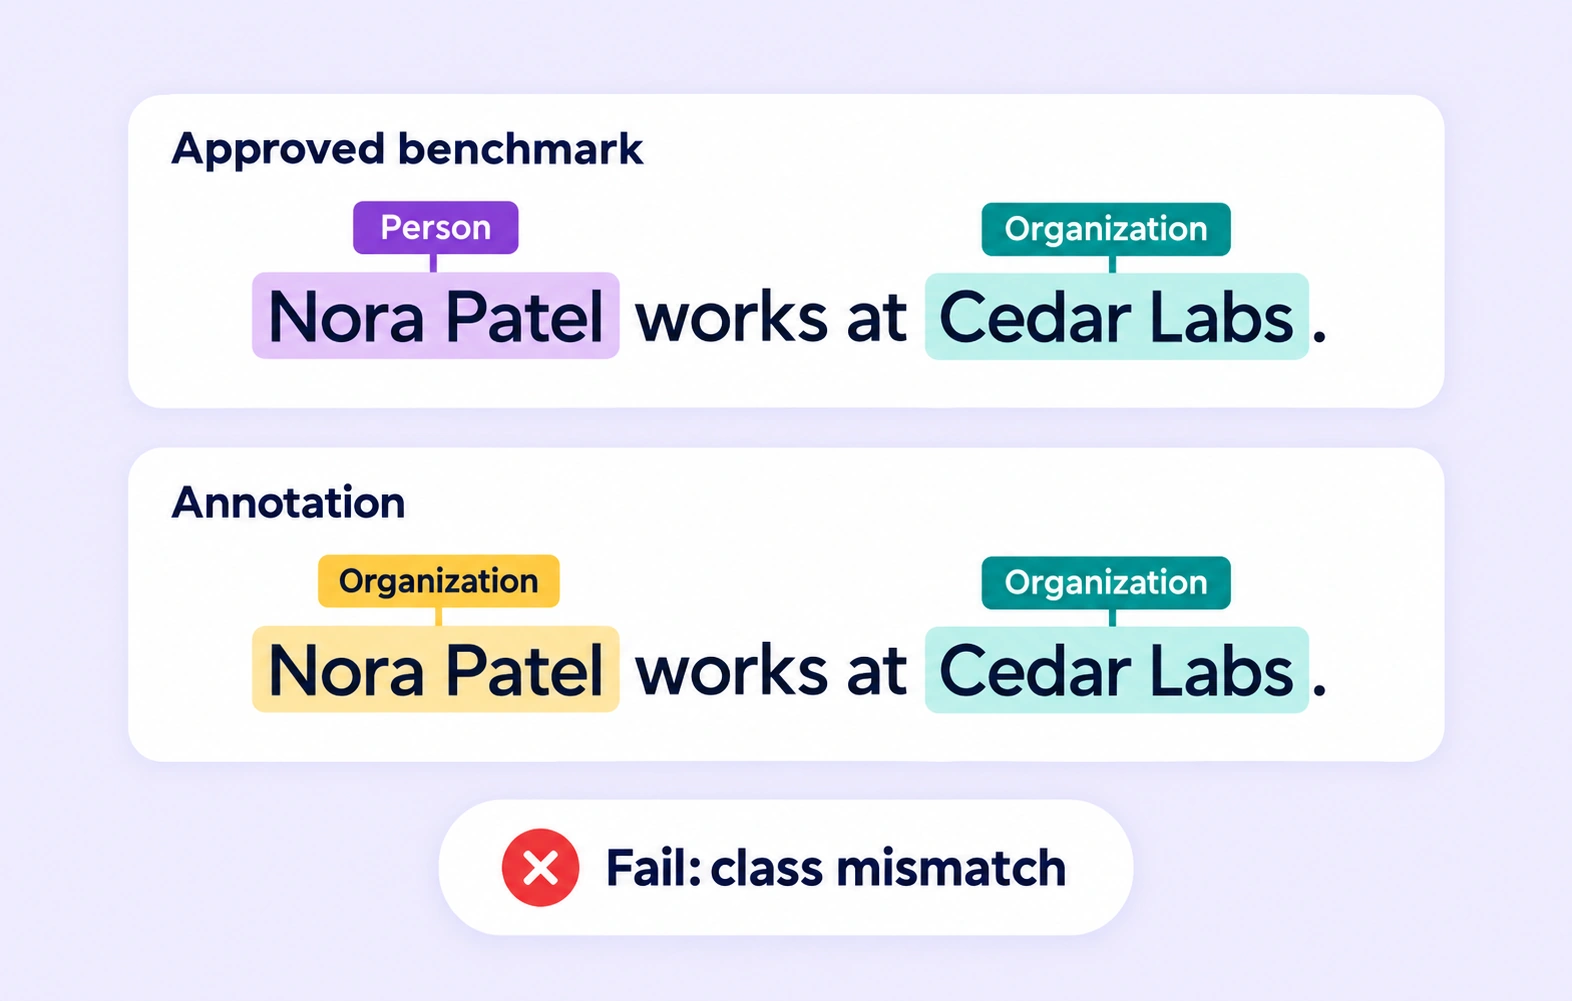
The same Nora Patel span is labelled Person in the benchmark and Organization in the submission, producing a class-mismatch result.

质量门禁(蜜罐)

对照隐藏的已批准参考答案检查支持的文本标注,识别片段、类别、关系或属性差异,并依据配置的质量阈值对比较结果进行分流。
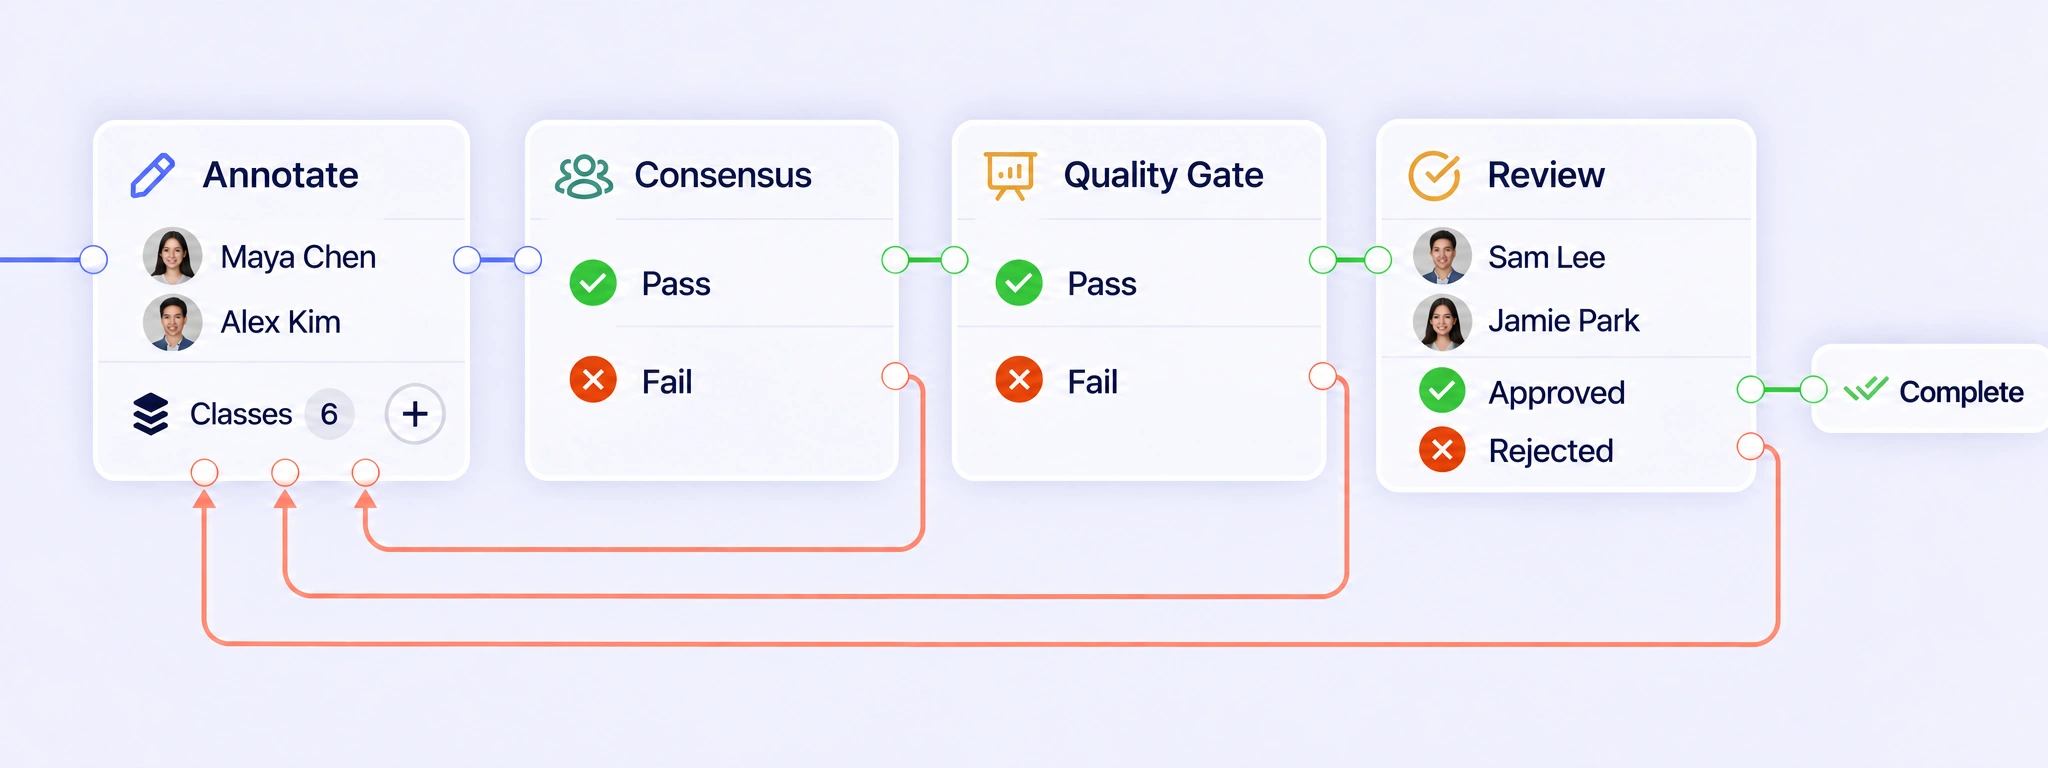
Approved Unitlab QA workflow connecting annotation, consensus, quality gates, expert review and correction paths.

质量保证工作流

连接文本标注、共识、基准比较与审核。将不完整的片段或不一致的类别退回修正,并在完成前审核修订后的数据项。

AI 团队为何选择 Unitlab

将原始文本、标签定义与审核决定保存在一起,让 NLP 团队在完善数据集时保留每次修正的上下文。
15X
更快的数据标注
60%
释放 AI 工程师的时间
5X
更低的 AI 开发成本

NLP 标注质量控制

精确对照原文审核片段与关系,再依据共享定义和独立标注解决类别分歧。
A partial person entity span is expanded to include the complete name Amina Yusuf.

核对准确的文本依据

结合上下文审核实体高亮与关系端点。在批准标注或要求返工前,修正边界、标签及属性。

解决类别歧义

独立标注可揭示标注员对同一文本的不同理解。依据标注规范审核分歧并完善结果。

Two independent intent labels for the same cancellation and refund request await review.

NLP 标注质量保证常见问题

什么是 NLP 标注质量保证?

NLP 标注质量保证审核文本标签的片段边界、实体类别、关系结构,以及类别和属性的一致性。Unitlab 将审核过程与创建标注时使用的准确原文连接起来。 质量保证概述

质量保证工作流如何处理文本审核与返工?

质量保证工作流连接文本标注、共识、质量门禁与审核。为比较阶段配置通过和未通过路径,随后批准已审核的数据项,或将不完整片段、错误关系及不一致类别退回修正。修订后的标注可再次送审,提交尝试与审核决定保留在工作流历史中。 质量保证工作流

共识如何比较 NLP 标注?

共识收集同一文本的独立标注,并依据一致性设置比较支持的片段、标签、关系与属性。审核员可结合原文检查不同理解并完善代表性结果。一致性衡量提交结果之间的统一程度,本身并不能消除语言歧义或证明标注正确。 共识标注指南

质量门禁(蜜罐)如何检查 NLP 标注?

质量门禁将支持的文本标注与对标注员隐藏的已批准参考答案比较,并依据配置的阈值判断是否通过。当比较数据不可用时,应将未评估结果单独处理,并为相应结果设置审核或返工路径。 质量门禁指南

如何修正命名实体识别的片段边界错误?

审核员检查准确的原文字符及周围句子,再修正不完整名称、过长片段、遗漏实体或错误类别。项目应定义各实体类型是否包含称谓、标点及修饰语,帮助团队对相似示例应用一致的边界规则。 审核阶段

如何检查关系端点与方向?

审核员确认每条关系以正确标签和方向连接预期的源实体与目标实体,判断依据来自原文与本体定义。支持的标注比较会在匹配端点后评估关系;当原文中的关系存在歧义时,由审核员作出判断。 审核阶段

如何审核有歧义的意图或文档类别?

将意图或文档类别配置为数据项属性,并结合完整原文进行审核。在规范中定义相近类别的区别并提供边界案例。审核员可一致地应用这些定义,同时将整项类别与单个片段上的实体标签分开管理。 审核阶段

本体校验能否帮助发现缺失的 NLP 属性?

必填属性及其他已配置的本体规则可产生供审核员检查的校验提示。审核员可据此在批准前补全缺失值或修正不一致的选项。校验提示可能仅起提醒作用,而非阻止每次保存,因此团队还应明确审核员必须解决的问题。 本体文档

基准比较能识别改写或语义等价吗?

支持的比较评估标注结构与已存储的属性值。标量文本属性采用完全相等判断,因此即使读者认为含义相近,不同措辞仍可能被判定为不一致。审核员应依据项目认可的表述与类别规则,处理改写、歧义及其他需要理解判断的情况。 审核阶段
需要设计 NLP 标注质量工作流?联系 Unitlab