文本标注平台

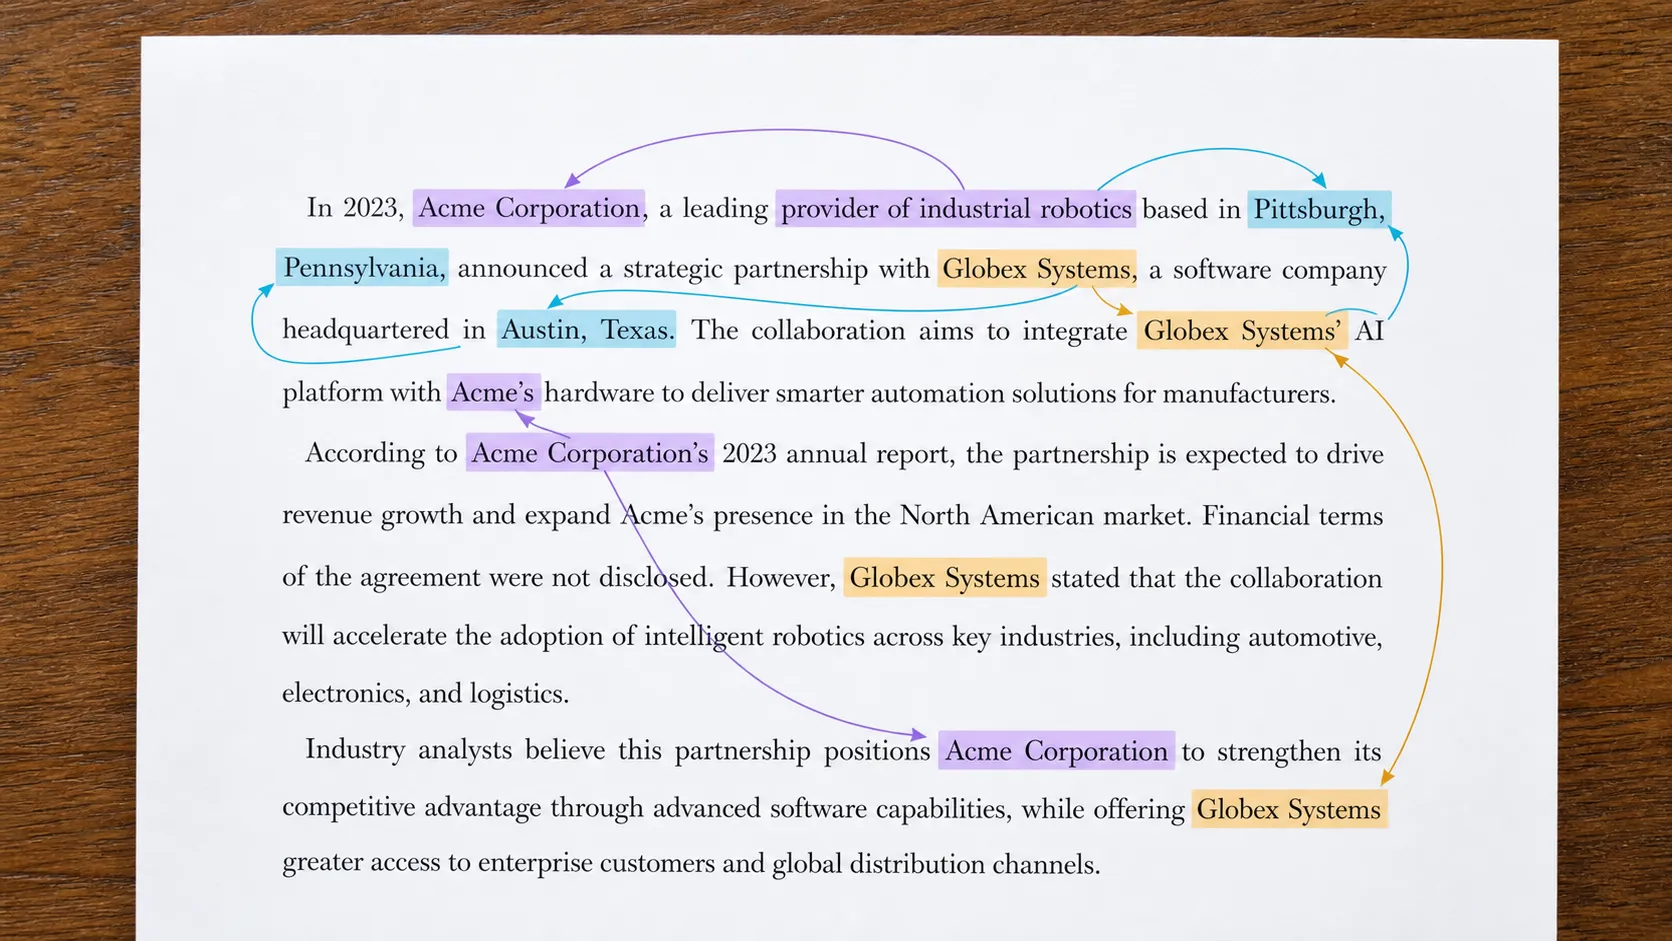
NER 和 NLP 文本标注平台

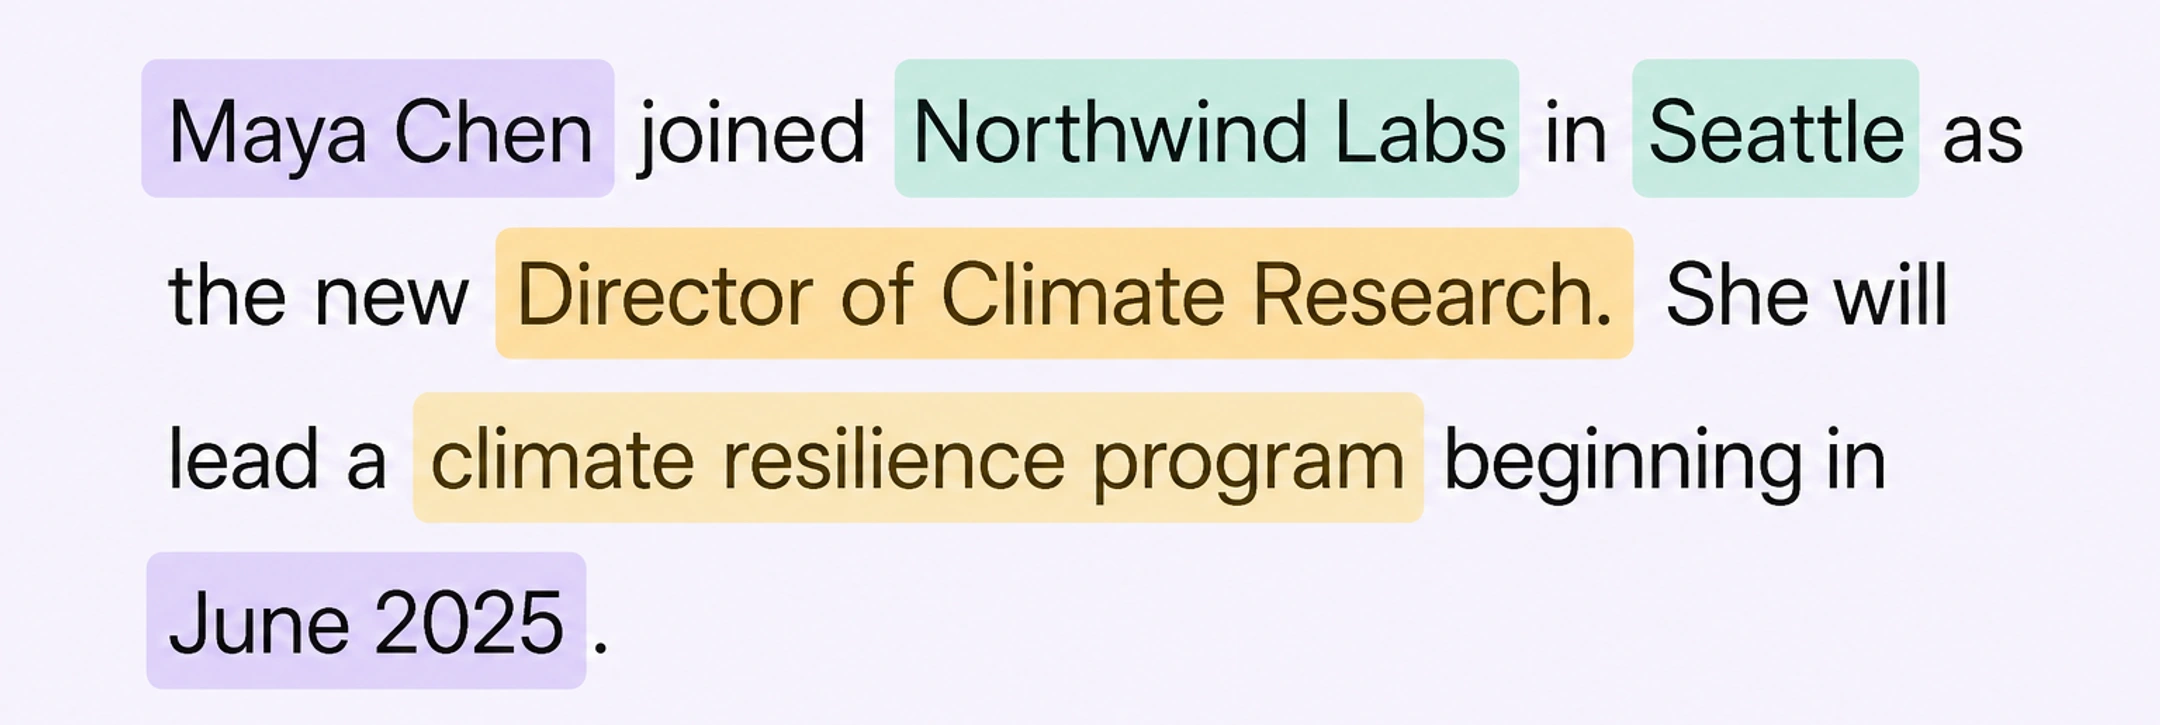
使用命名实体识别 (NER)、实体标注、关系提取、文本分类、意图和情感标签以及受监管的审核工作流程创建 NLP 训练数据。

文本标注功能

复杂文本标注所需的一切

标记精确的跨度、连接实体、保留文档上下文、构建高级本体并利用 AI 加速标注。

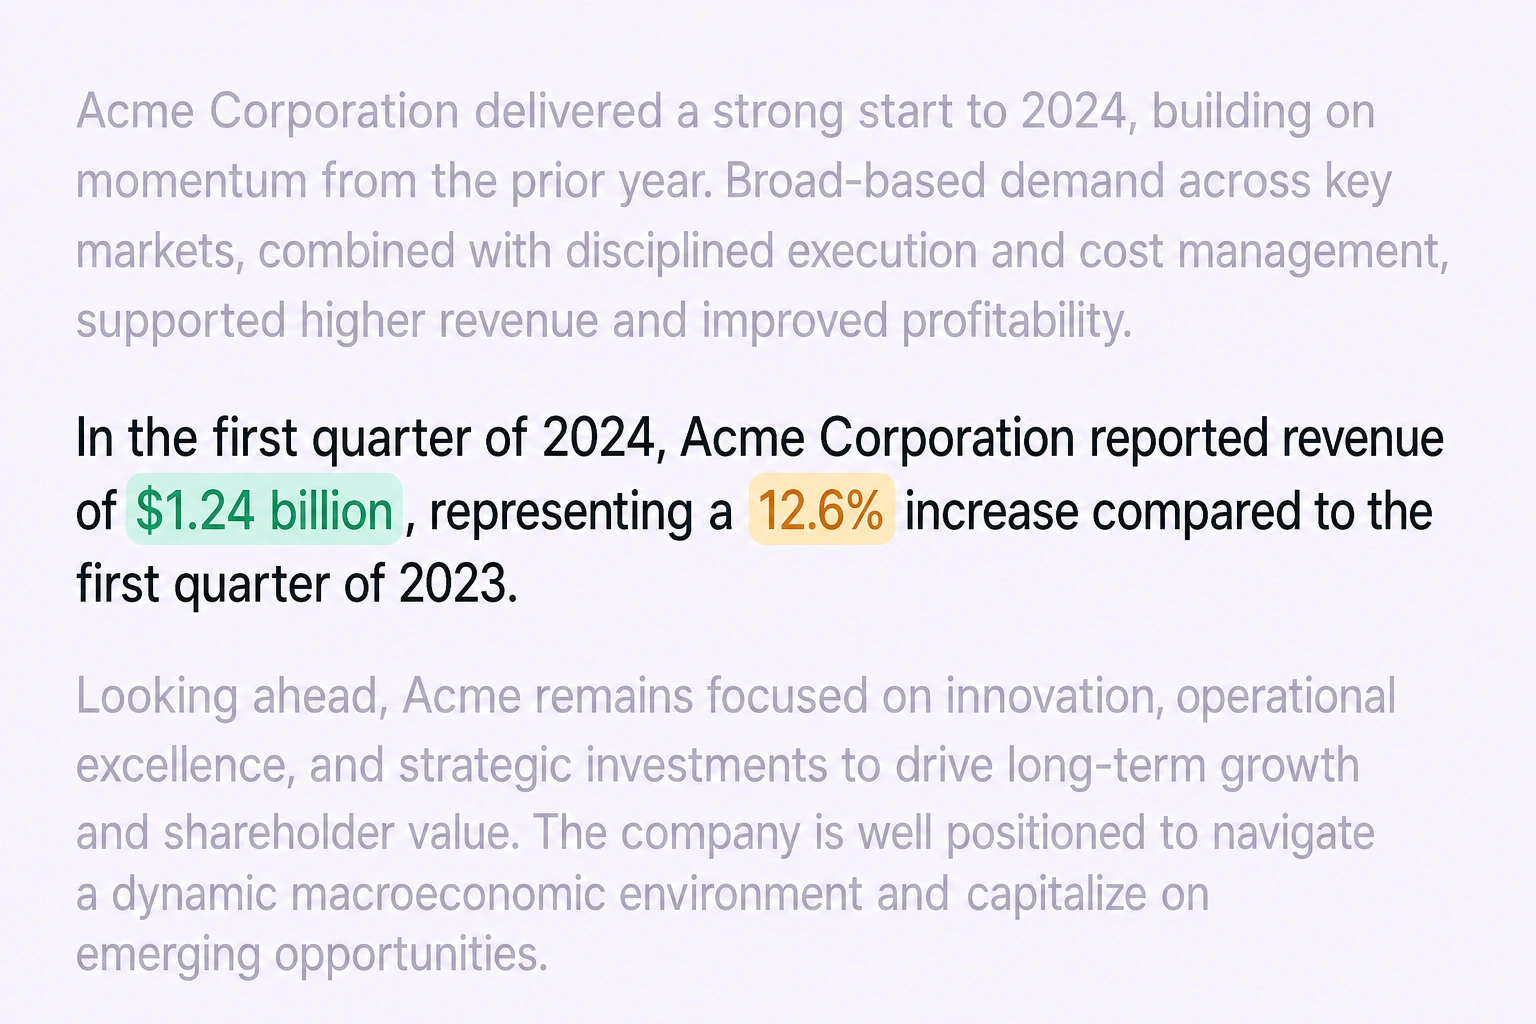
Printed text with precise person, organization, location, topic, and arbitrary span annotations
01 · 标签

命名实体识别 (NER)

标记人员、组织、位置、领域实体和任意范围,以进行命名实体识别和信息提取。

单词和短语
命名实体
任意跨度
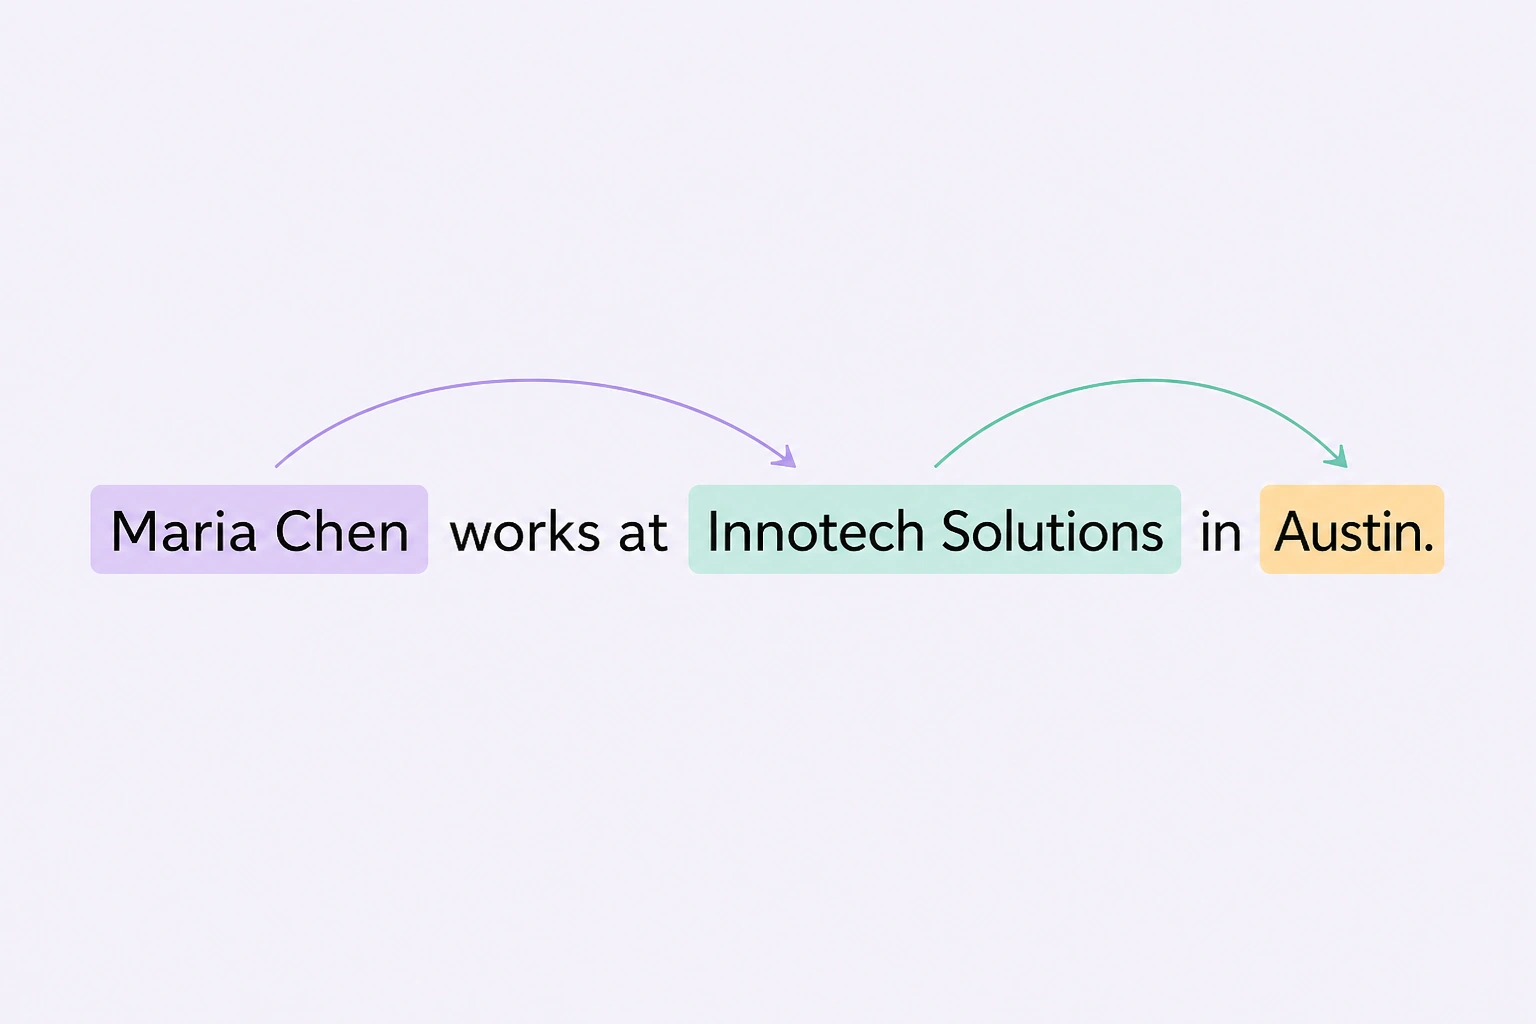
Printed sentence with directional relationships linking a person, organization, and location
02 · 链接

关系和实体链接

连接实体和跨度以捕获关系、引用和结构化关联。

Layered report pages preserving sentence, paragraph, and document context around labeled entities
03 · 背景

上下文感知标注

对文本进行标注,同时保留句子、段落和文档级上下文,以实现一致的标记。

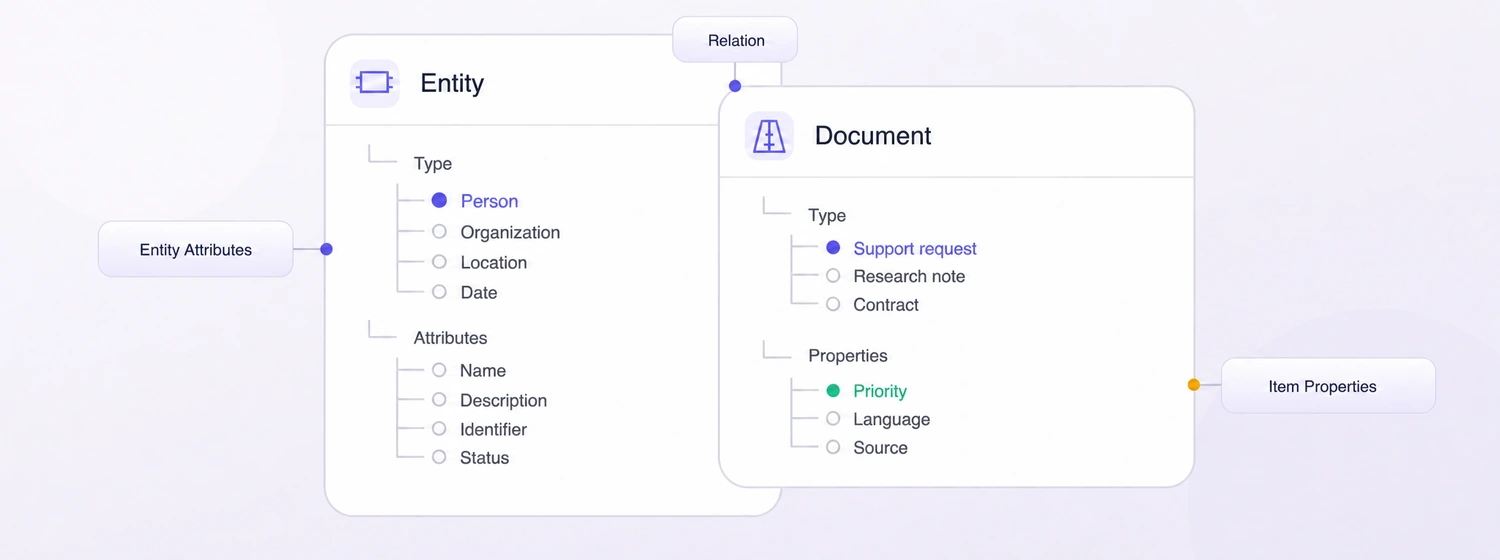
Video-style Unitlab ontology UI adapted only with text entity, document, attribute, relation, and item property use cases
04·本体

高级本体

定义分层实体类型、嵌套属性、关系和结构化标签模式。

Printed customer message with AI-suggested labels reviewed and refined by a human
05·人工智能辅助

人工智能辅助自动标记

使用 AI 预先标记实体、跨度和重复模式,然后审查和完善结果。

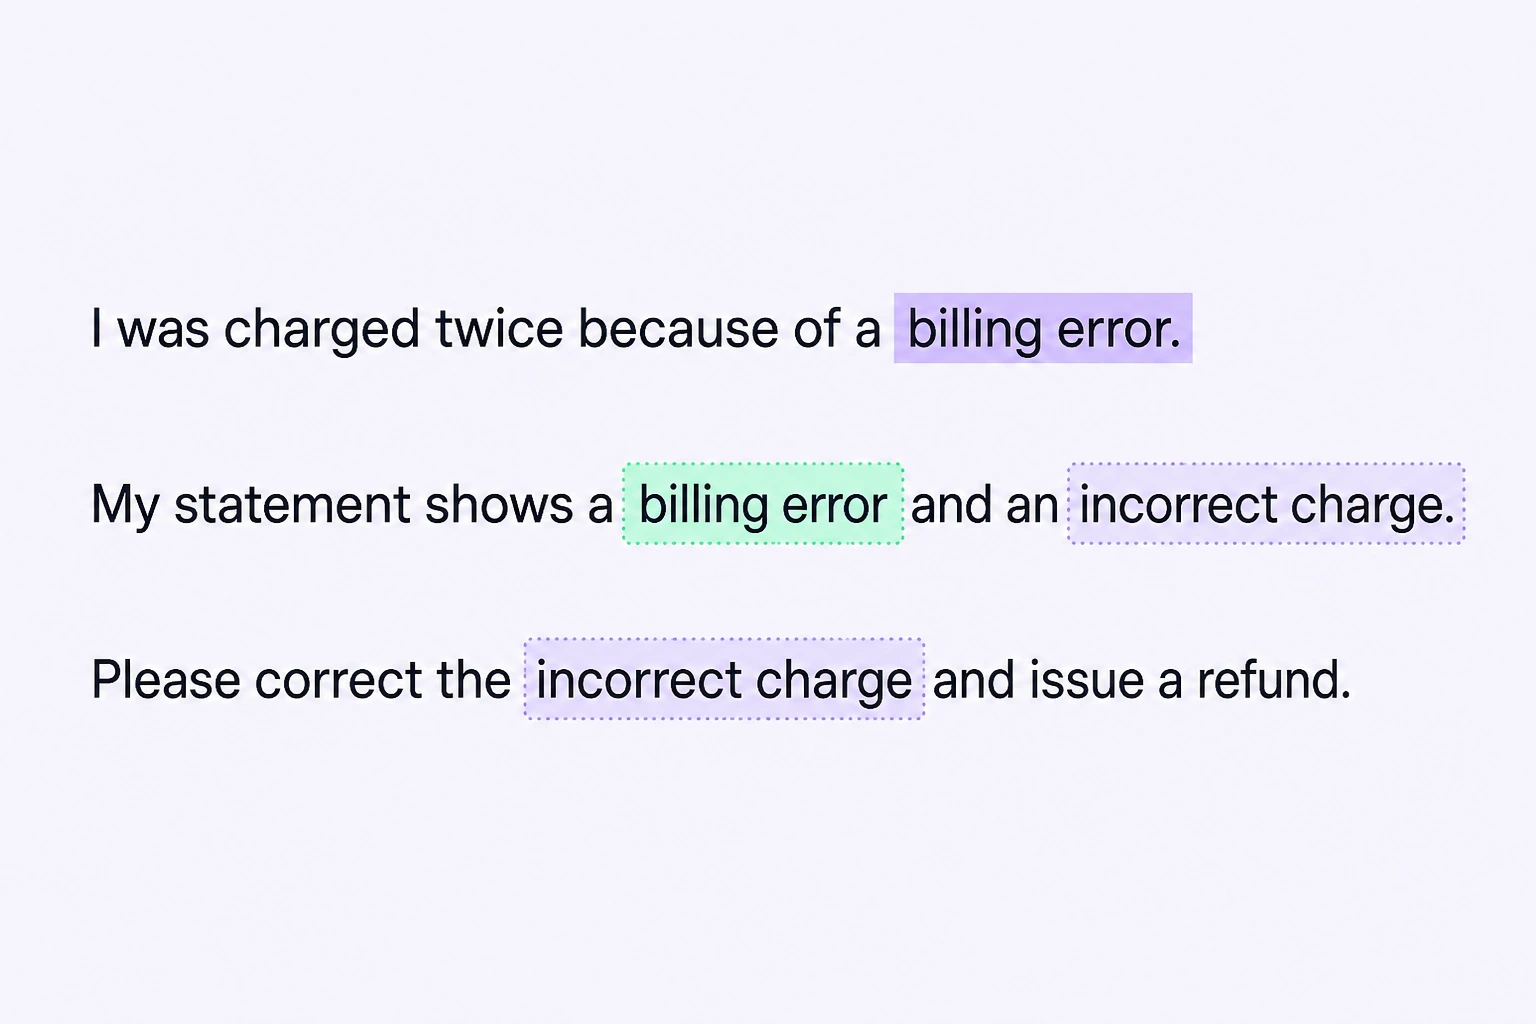
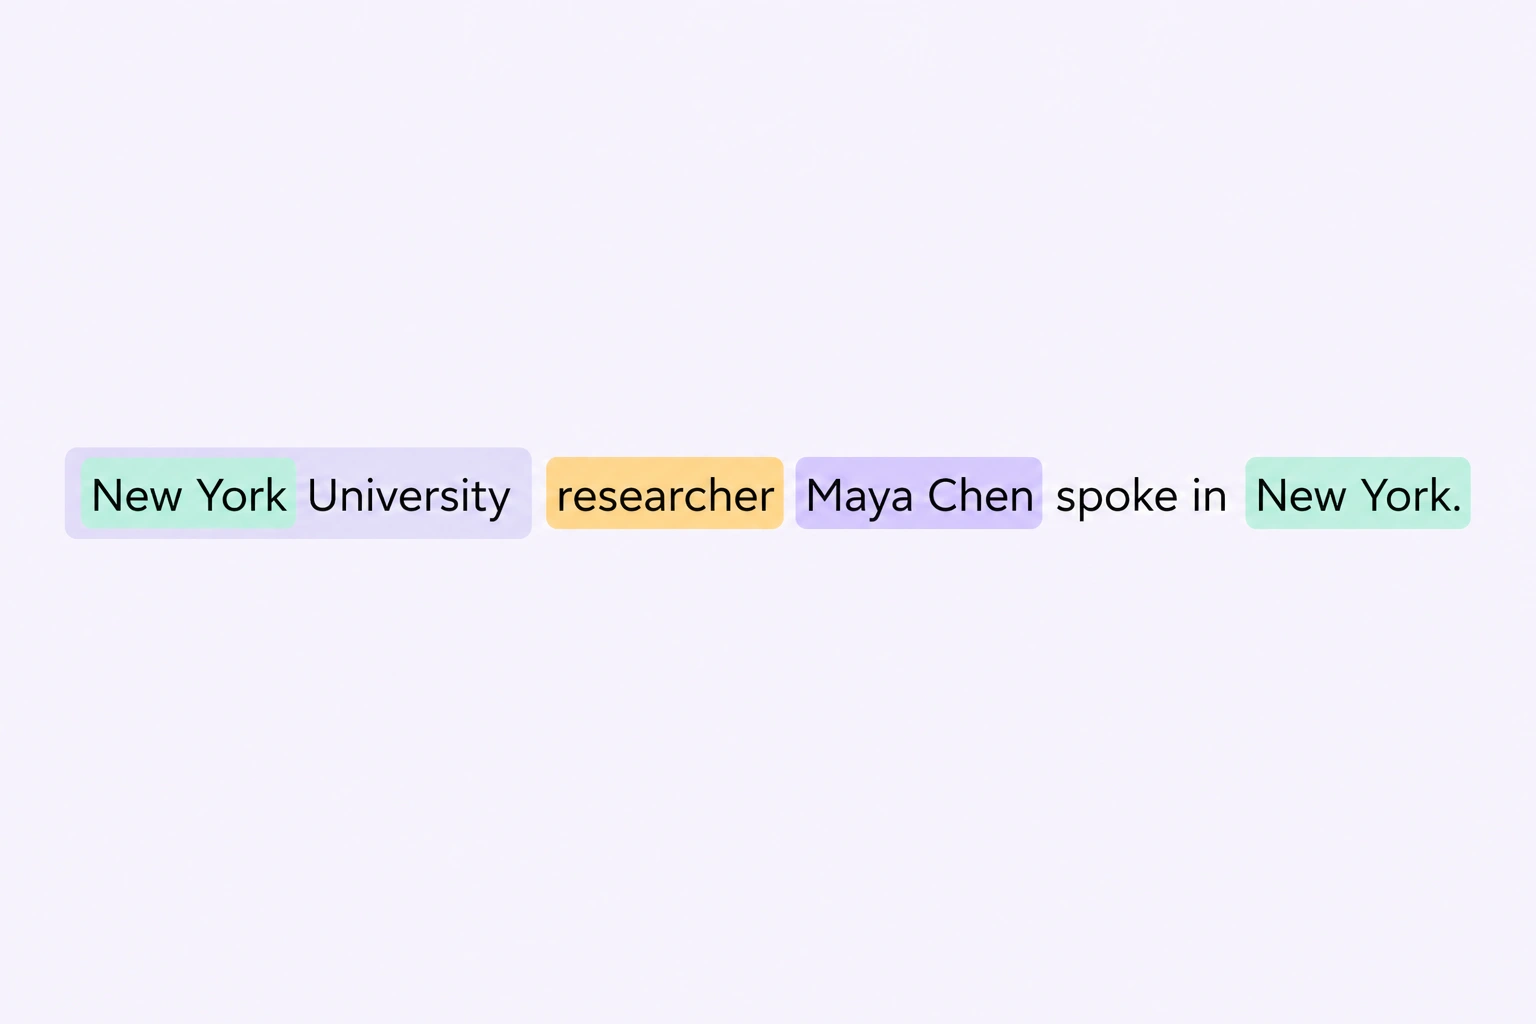
Printed research sentence with nested and overlapping entity spans preserved independently
06 · 筑巢

嵌套和重叠实体

标注重叠和嵌套跨度,同时保留每个实体及其关系。

嵌套跨度重叠跨度

为什么 AI 团队选择 Unitlab 进行文本标注

通过人工智能辅助自动化、可扩展的工作流程和更低的运营成本,更快地标注复杂的文本数据集。

20×
更快完成文本数据标注

模型辅助标注和自动化工作流,减少手动文本标注工作。

95%
文本自动标注

平均而言,95% 的文本标签会自动预标注,然后由人工审核和修订。

20×
降低训练数据成本

通过自动化数据筛选、标注和质检,单个已验收标签的成本最多可降低 20×。

支持的文本标注类型

所有文本标注类型 在一个平台上。

标记精确的跨度、连接关系、对完整项目进行分类并捕获结构化属性和特性。

01
文本选择

命名实体/跨度

使用可重用的实体类标记确切的单词或段落。

02
上下文链接

关系

将实体与类型化、定向关系连接起来。

03
整件商品标签

分类

指定意图、情绪、主题或文档类型。

04
结构化元数据

实体属性

将类型化属性附加到每个带标签的实体。

05
层次结构

嵌套属性

使用可重用的验证规则组织依赖属性。

06
文档元数据

项目属性

描述具有共享属性的完整文本项。

07
可编辑源代码

源文本编辑

更正源内容,同时保持标注一致。

08
长文本上下文

文本窗口上下文

通过稳定的偏移量和完整源上下文浏览长文本。

09
质量工作流程

审查状态

通过标注、审阅、返工和批准来安排文本任务。

文本标注质量保障

为每项文本标注建立质量检查。

比较同一原文中的标签,与已批准的参考答案核对,并在原文中解决问题。每项质量决策都与原始数据保持关联。
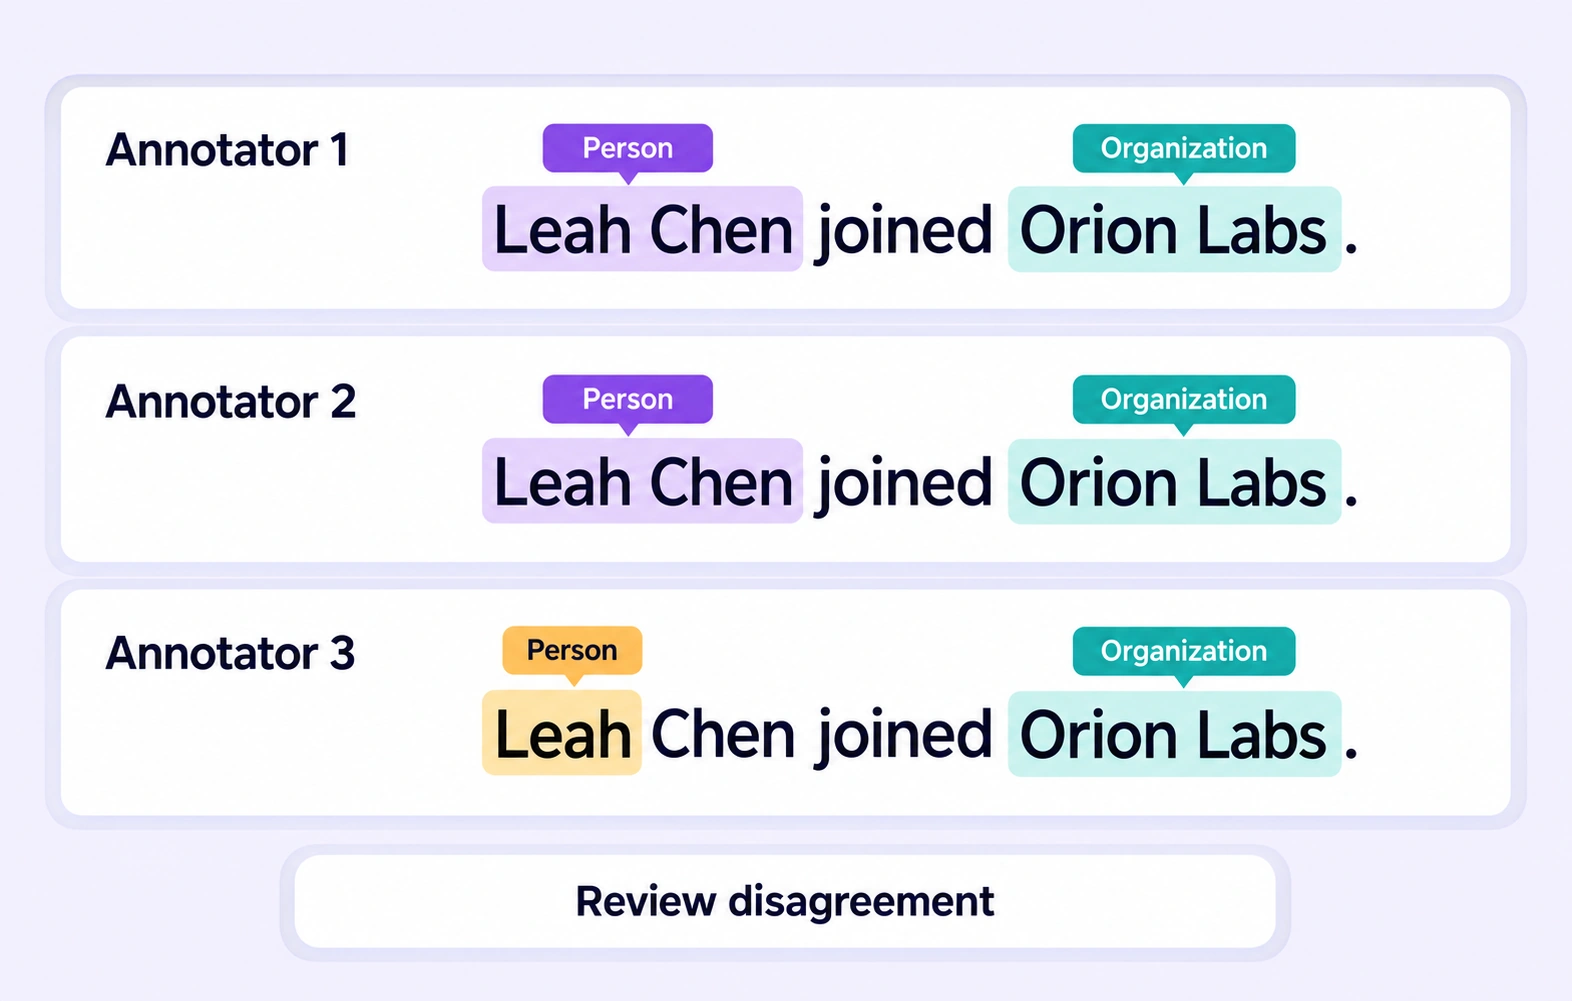
Three reviewers label the same sentence; one Person span omits Chen while the other two cover Leah Chen.
01 · 一致性

文本标注共识校验

比较独立完成的文本标注,检查实体跨度、类别和关系的分歧,并在批准前解决。

文本原始数据对比一致性检查分歧审核
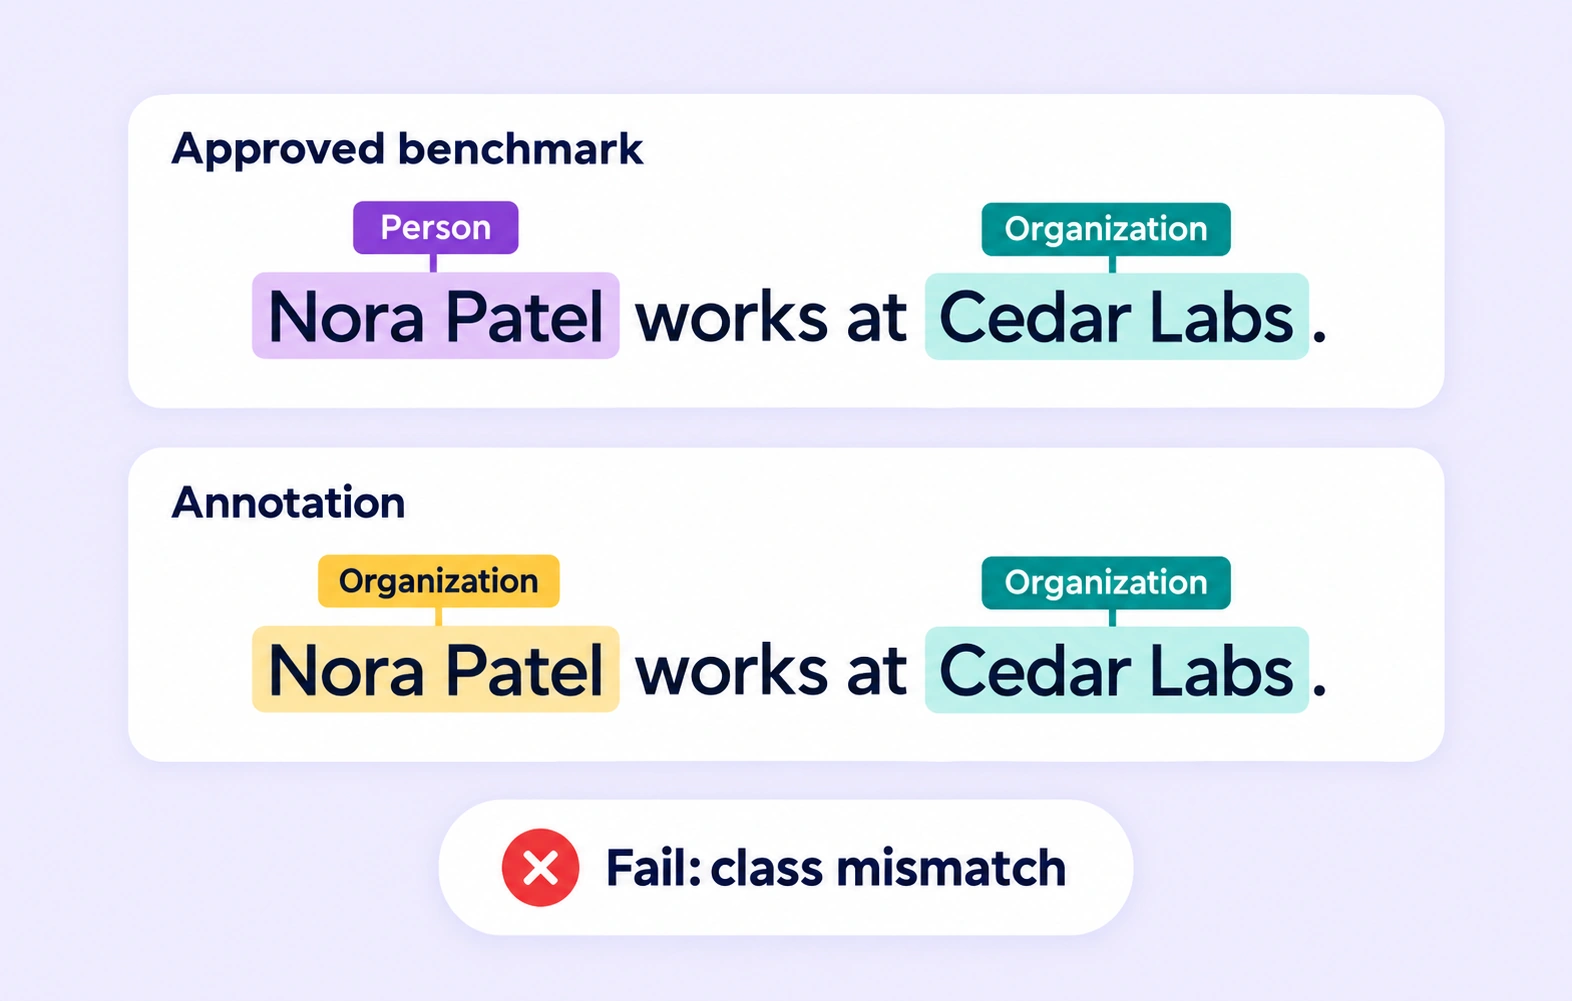
The same Nora Patel span is labelled Person in the benchmark and Organization in the submission, producing a class-mismatch result.
02 · 参考基准

质量关卡(隐藏基准)

将文本标签与对标注员隐藏的已批准参考答案比较,并根据设定的质量标准评估提交结果。
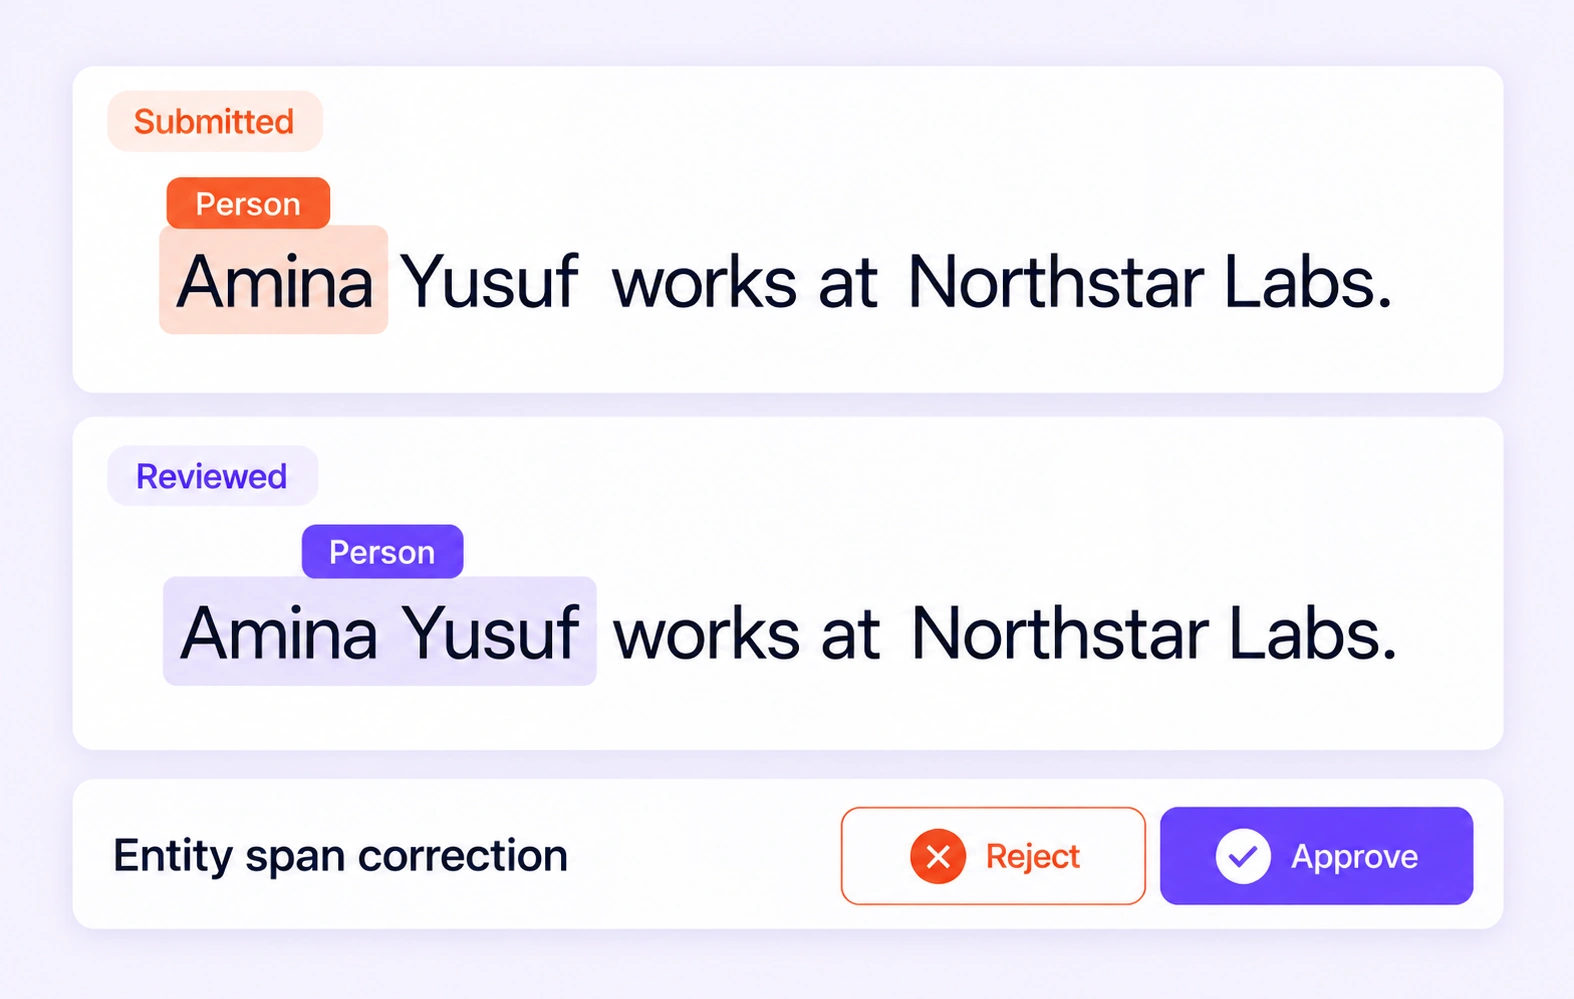
A partial person entity span is expanded to include the complete name Amina Yusuf.
03 · 验证

验证与问题解决

在原文中检查必填属性缺失及实体跨度与关系问题,修正相关标签,并在批准前处理审核反馈。
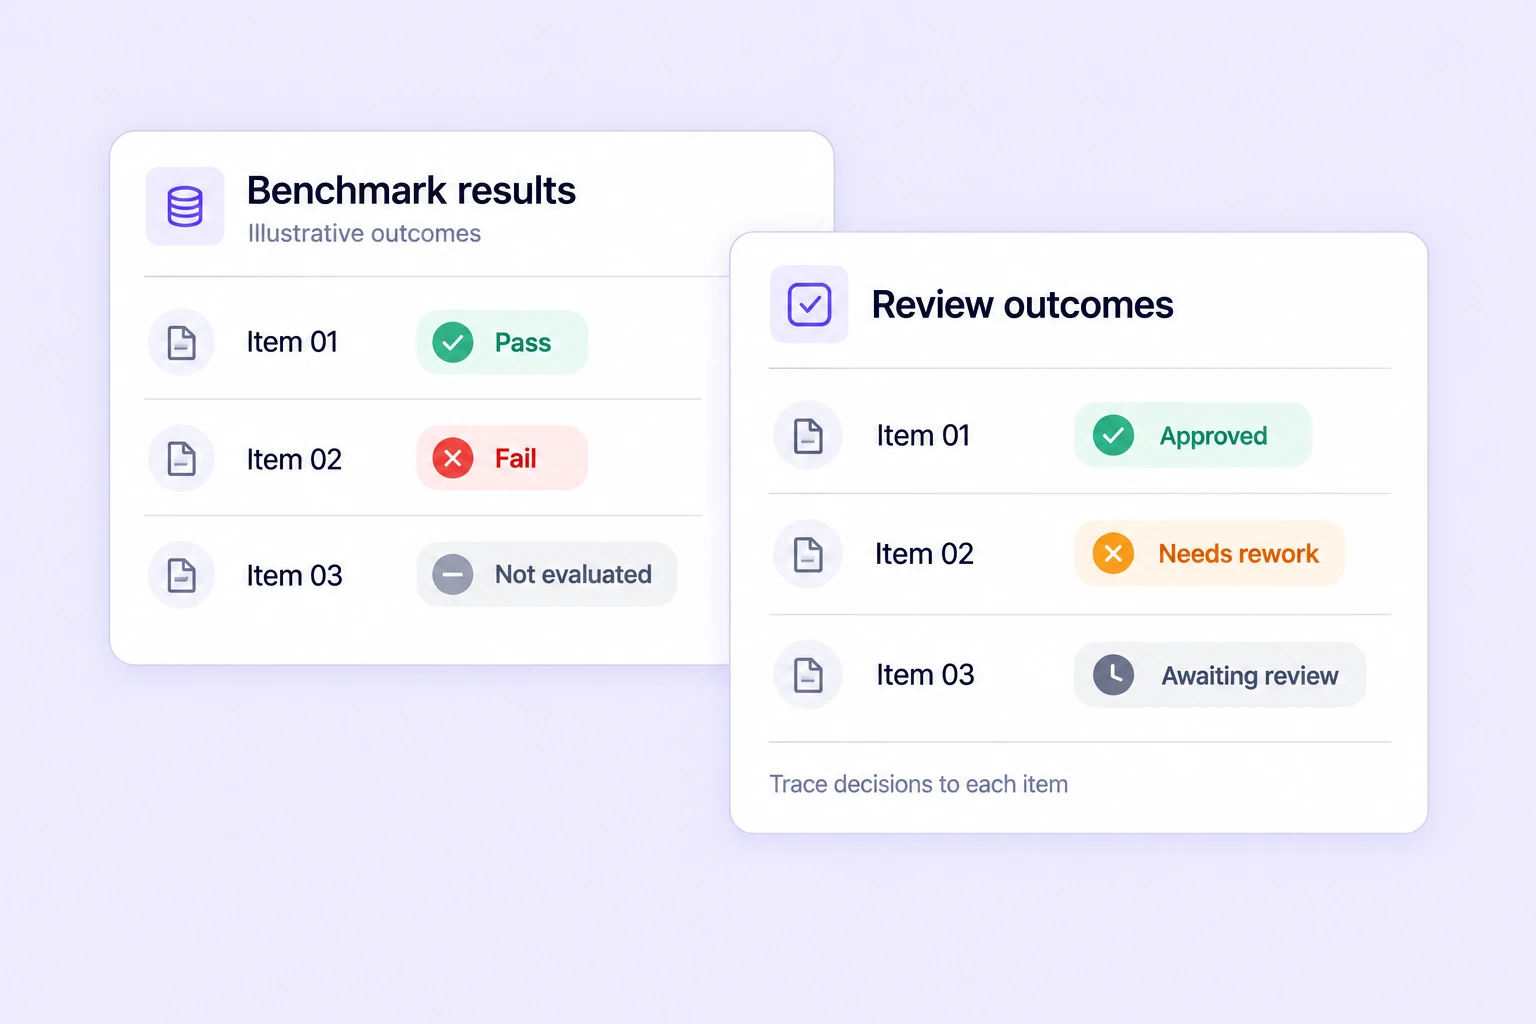
Illustrative benchmark and review outcomes for three matching item IDs, including pass, fail, not evaluated, approved, needs rework, and awaiting review.
04 · 分析

文本质检分析

追踪参考基准结果、共识情况和审核决策。识别跨度、类别和关系中的重复问题,确定审核优先级。

基准结果审核结果
文本数据集管理和标注工作流程

整理文本数据并自动化标注工作流程。

搜索、版本控制和检查文本数据集,连接 AI 模型,并通过审核和批准移动标注。
数据筛选 数据集管理
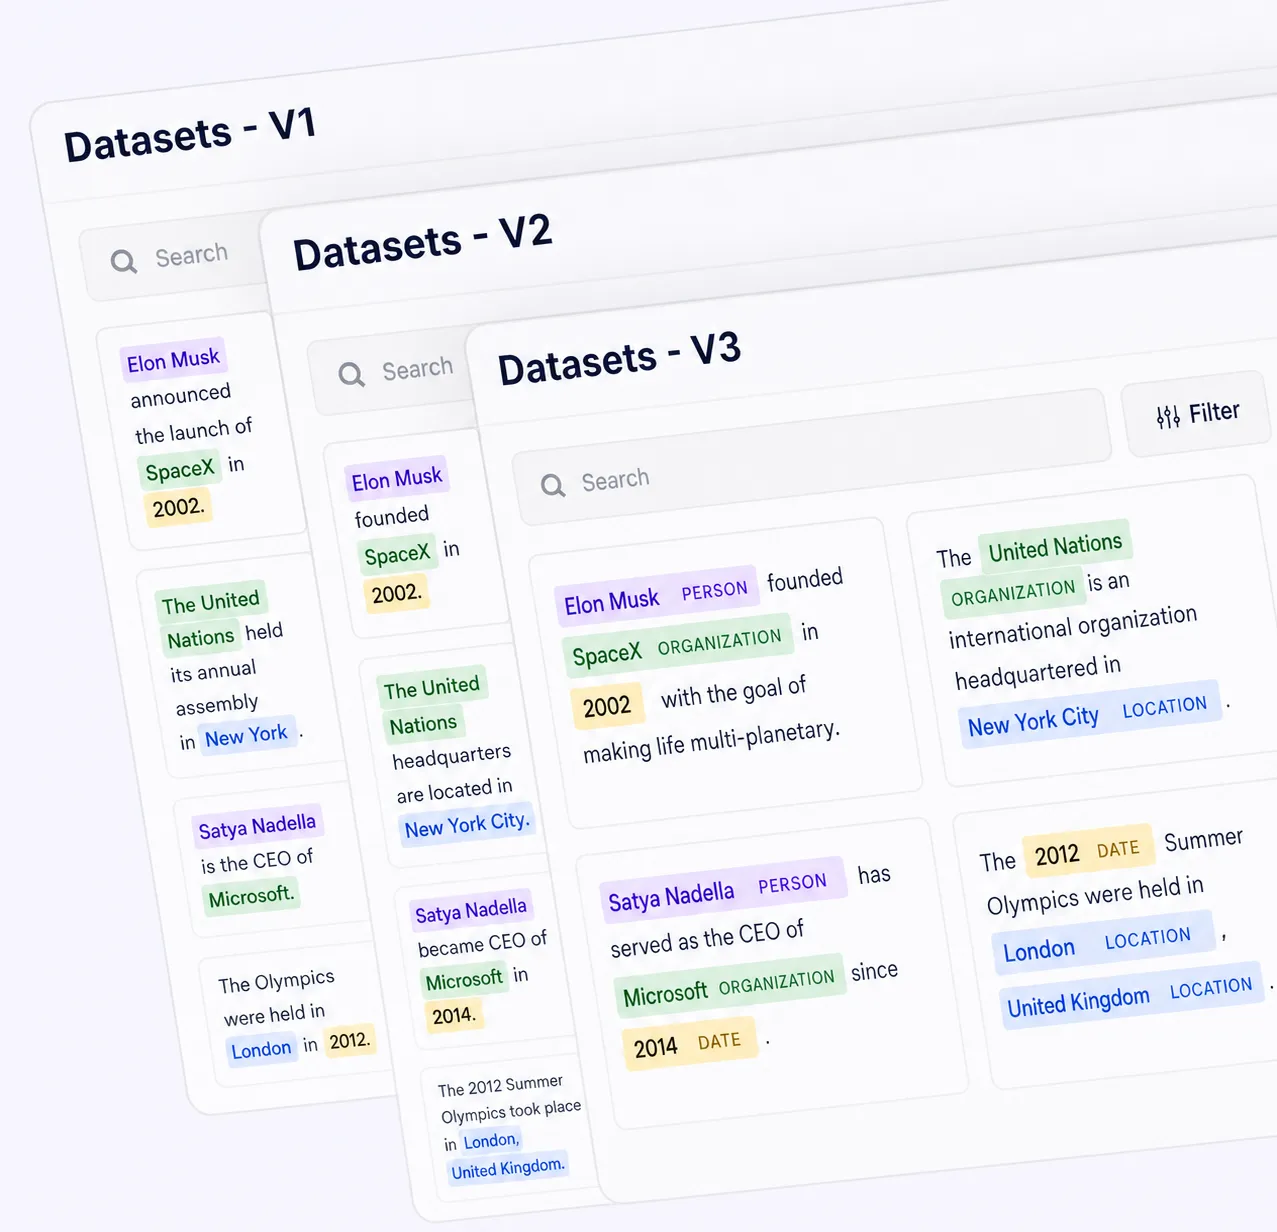
Text dataset version panels with document previews and entity annotations
版本

数据集版本

随着文本数据的发展创建和管理数据集版本。跟踪更改、分配工作并使每个版本保持可审核和生产就绪状态。
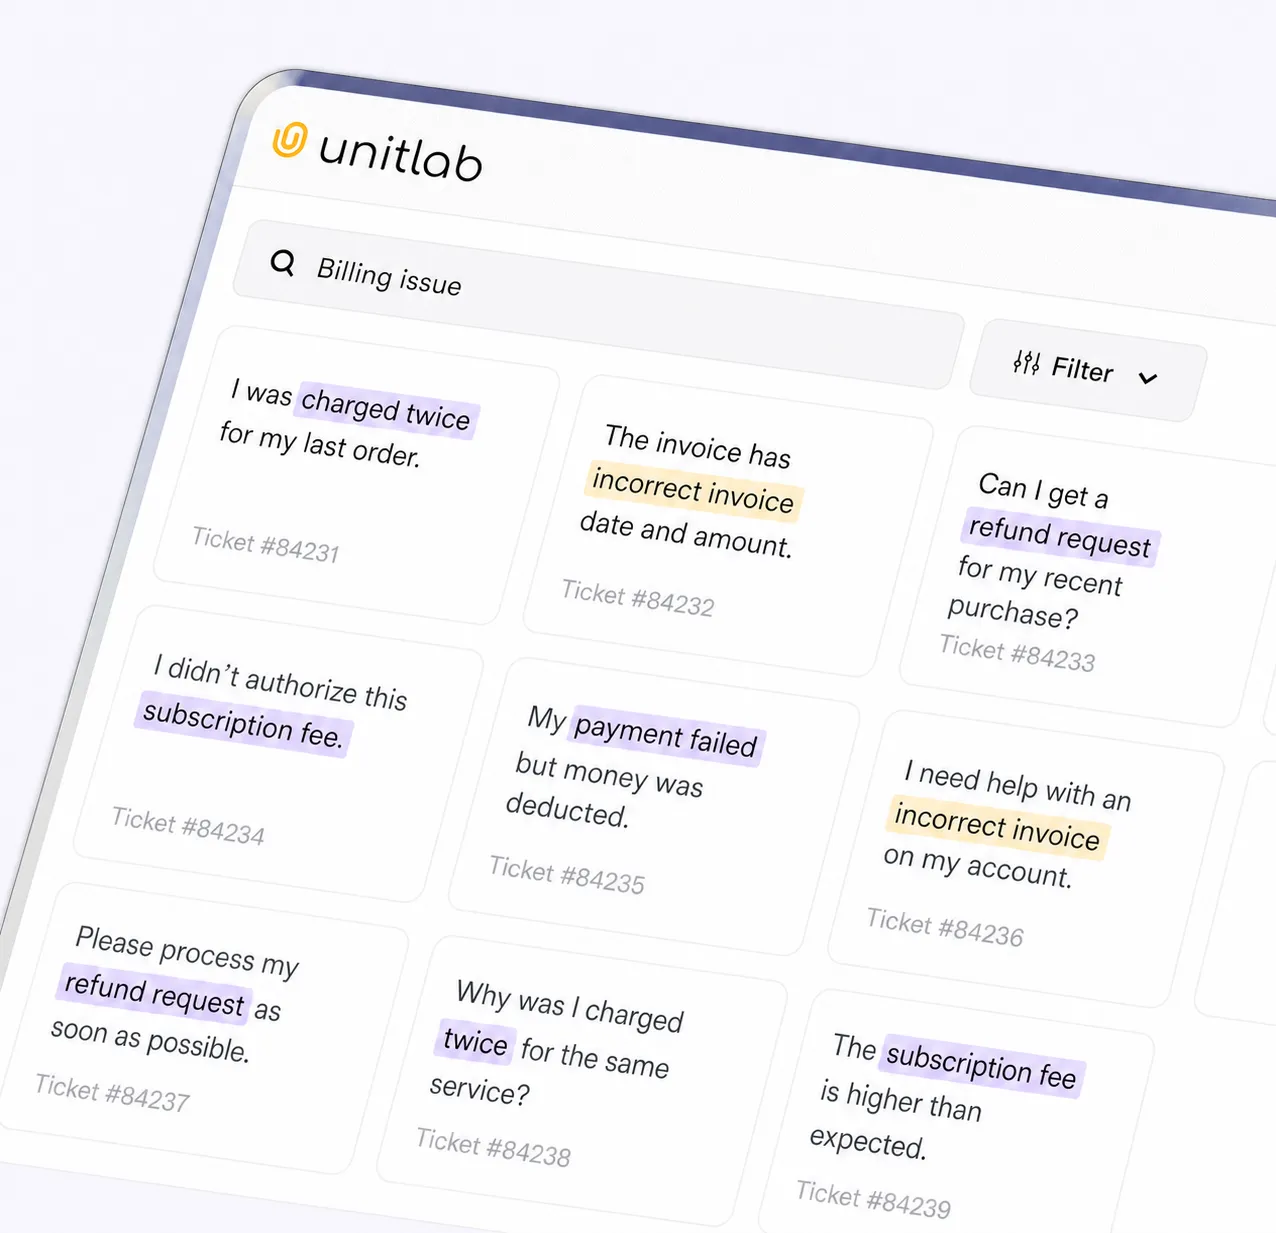
Semantic search results for text documents matching refund requests
发现

语义搜索

通过语义理解而不是手动过滤器来探索大型文本数据集。查找不同语言的匹配文档和段落。
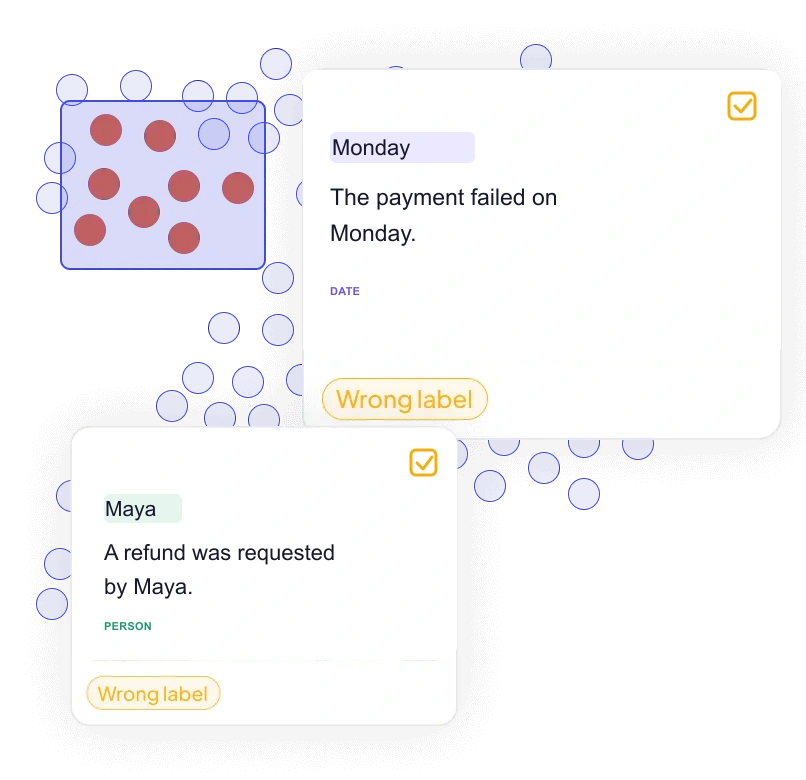
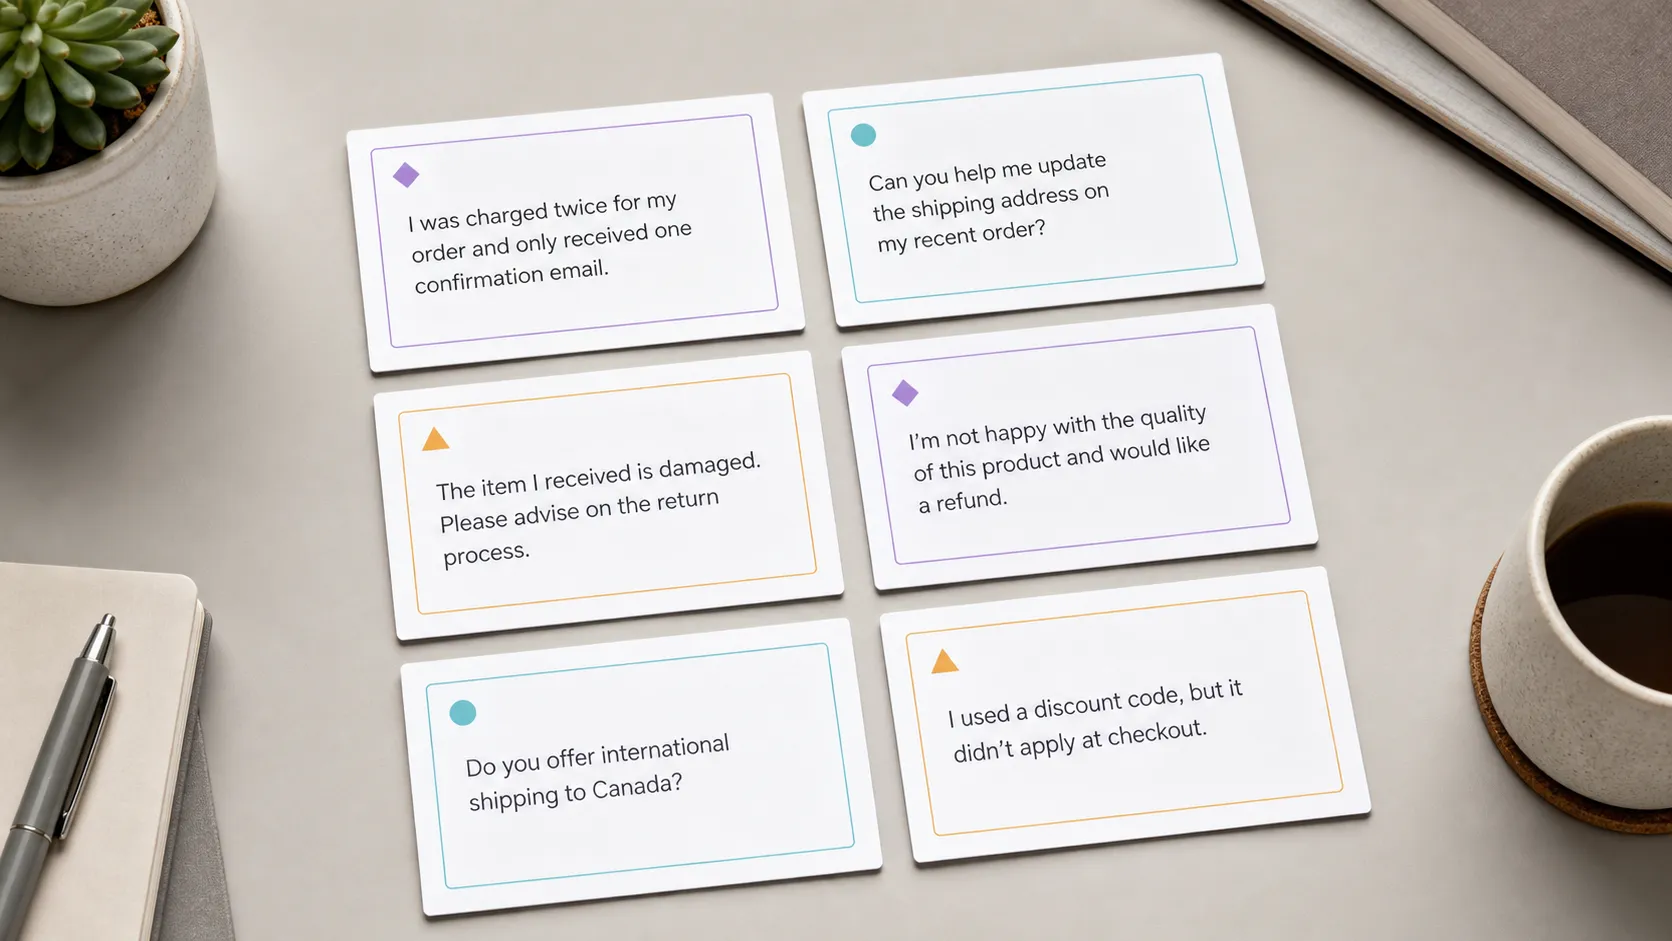
Text dataset embedding clusters with two centered review cards
检查

嵌入视图

可视化数据集结构,识别异常值和标签问题,并在训练前提高文本数据质量。

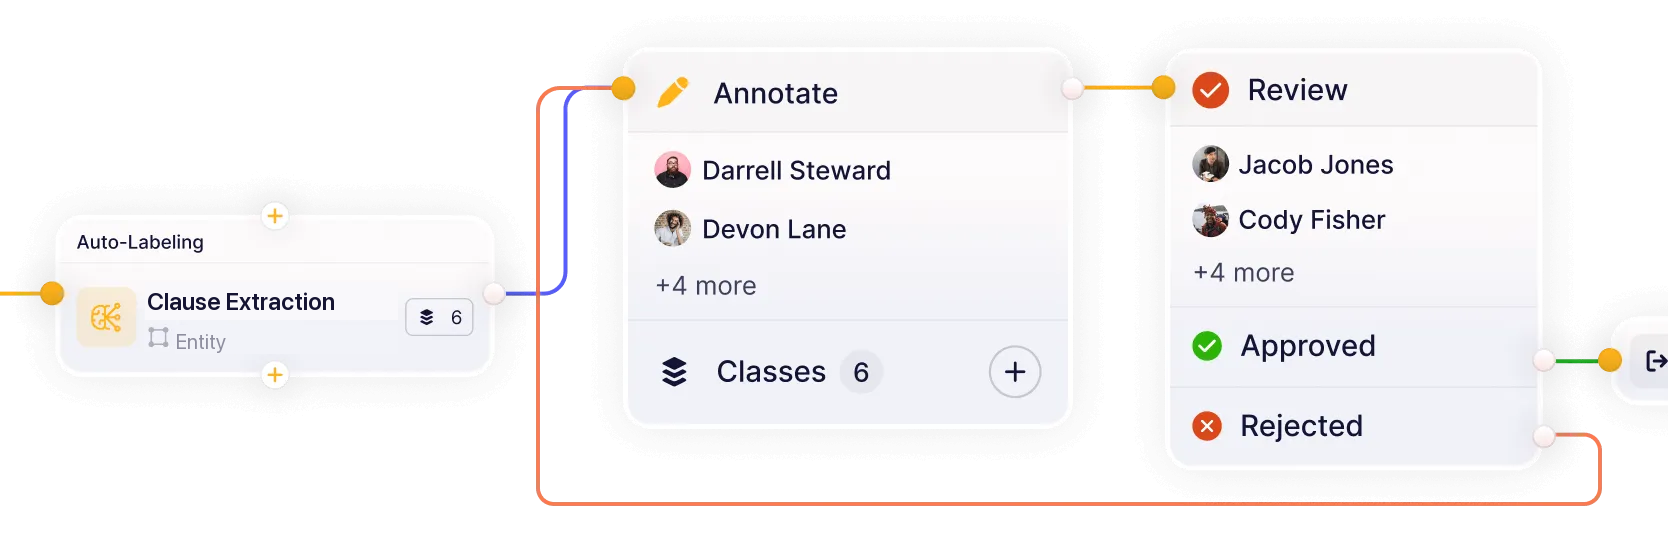
Unitlab workflow connecting entity extraction, annotation, review, approval, and rejection
编排

集成工作流程

构建在一个连续循环中连接模型、标注、审查和质量保证的工作流程。减少交接并保持数据集从标记到批准的过程。

Bring your Text model into Unitlab’s annotation workflow
整合

带上你的文本模型

连接您自己的 AI 模型以进行预标记和模型辅助标注。提高现实世界文本数据集的准确性并更快地迭代。

问题,已回答

文本标注平台常见问题解答

有关 Unitlab 中命名实体识别、实体标注、关系提取、文本分类、意图和情感标记、本体、质量工作流程和 NLP 数据集操作的解答。

与 Unitlab 团队交谈
What text annotation types does Unitlab support?+

Unitlab 支持命名实体识别 (NER)、实体和跨度标记、类型化关系、文本分类、实体属性、嵌套属性、项目属性、可配置文本窗口和受控源文本编辑。

文字标注文档
How does Unitlab support entity and span labeling?+

标注者选择准确的单词或段落,分配可重用的实体类,添加结构化属性,并将实体与类型化关系连接起来。审阅者可以在批准之前检查并更正每个标签。

实体与关系标注文档
Can Unitlab handle long documents?+

是的。可配置的文本窗口允许标注者在长文档中移动,同时保留完整源上下文、稳定的标注偏移、实体属性和关系。

多相机文本文档
How do ontologies and nested properties work in text annotation?+

嵌套本体定义实体类、分类、属性、关系和项目属性。可重用的规则使结构化标签在项目、标注器和数据集版本之间保持一致。

属性和关系文档
How does Unitlab manage text annotation quality and review?+

可配置的工作流程通过标注、审阅、返工和批准来路由文本任务。说明、作业、评论、问题、标注历史记录、数据集版本和发布使个别专家和企业团队的质量决策保持可追溯性。

标注和审查文档
Can teams use their own AI models for text pre-labeling?

是的。 Unitlab 可以将自定义模型引入标注工作流程以生成预标签和预测。标注者审查并纠正模型输出,而不是从零开始,而人工批准仍然是受控质量流程的一部分。

模型集成文档
Can Unitlab curate, annotate, and version text datasets in one platform?

是的。团队可以使用元数据过滤器、语义搜索、嵌入、相似性和异常值发现来管理文本数据,然后标注选定的样本、审查结果并发布受控数据集版本以进行可重复的人工智能开发。

数据集管理文档
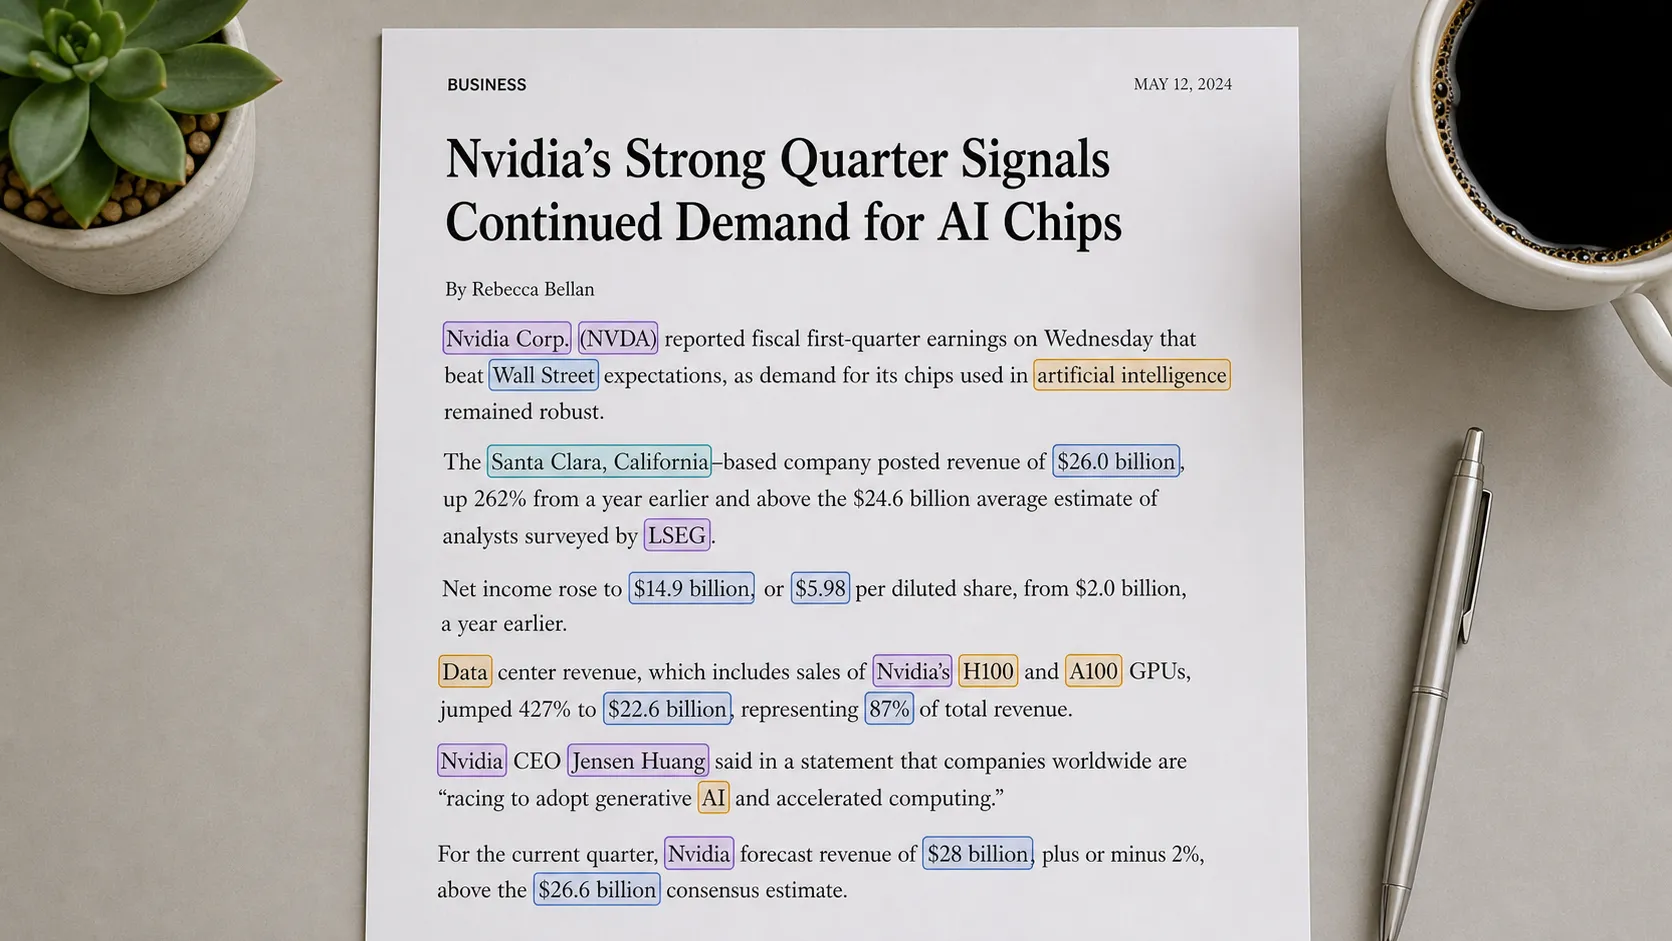
文本标注平台

使用 Unitlab 构建可投入生产的文本数据集

在一个人工智能辅助工作区中对复杂的文本数据进行标注、分类、审查和管理。借助 AI 辅助和内置质量控制,更快地从原始语言数据转变为可用于生产的 NLP 数据集。