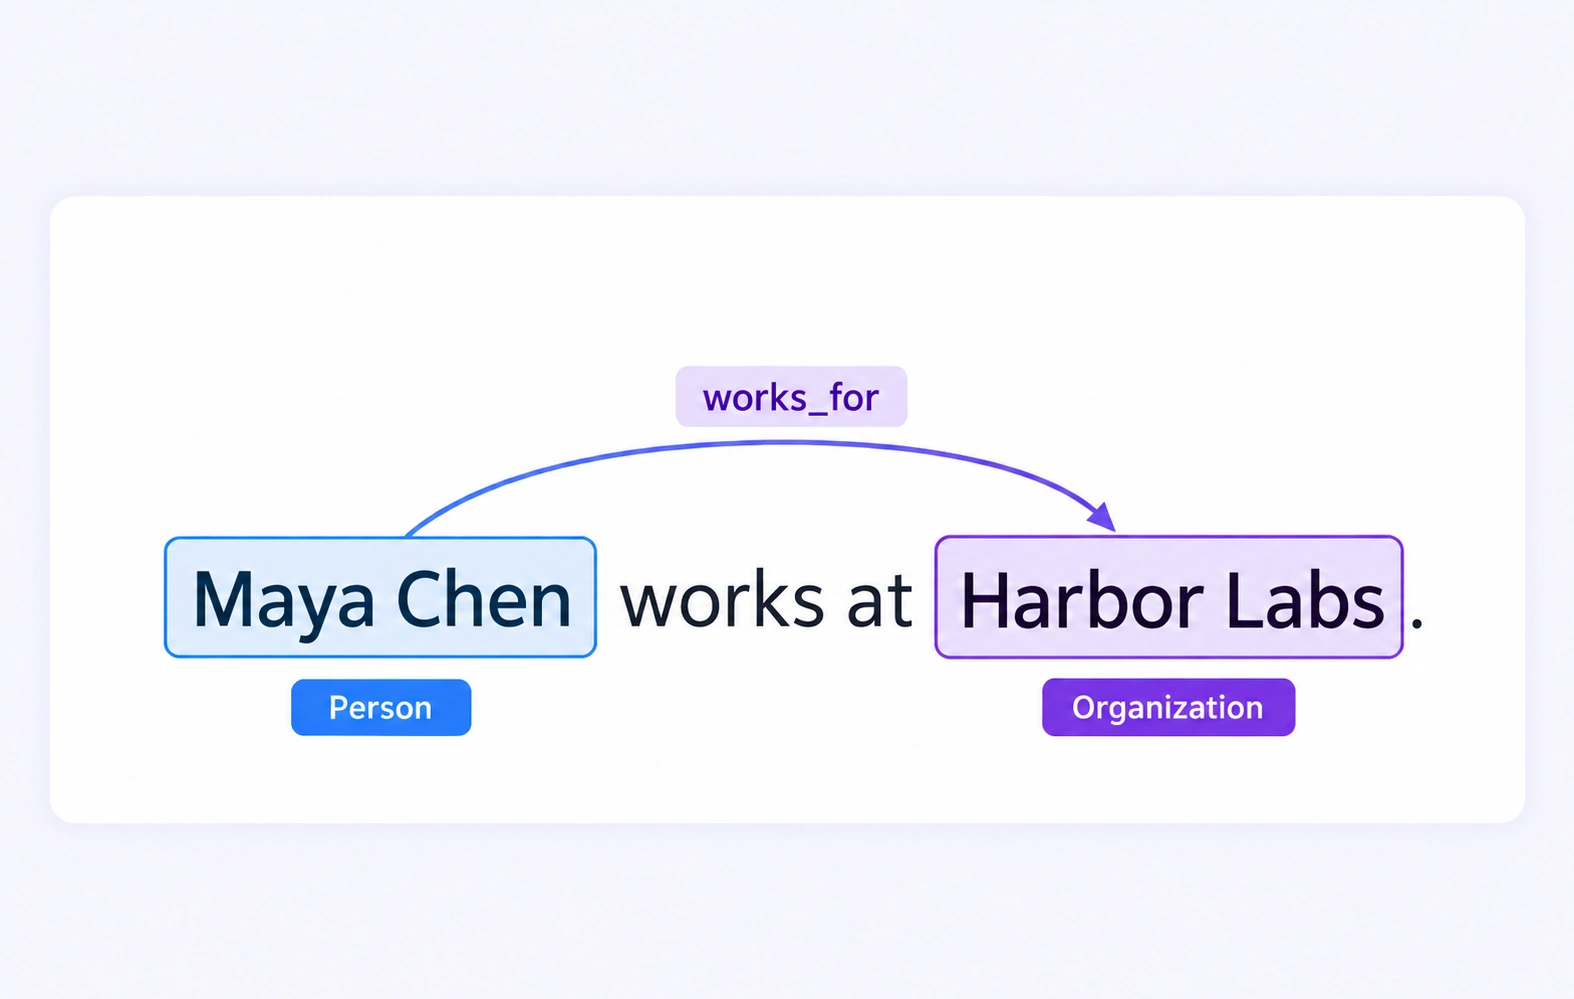
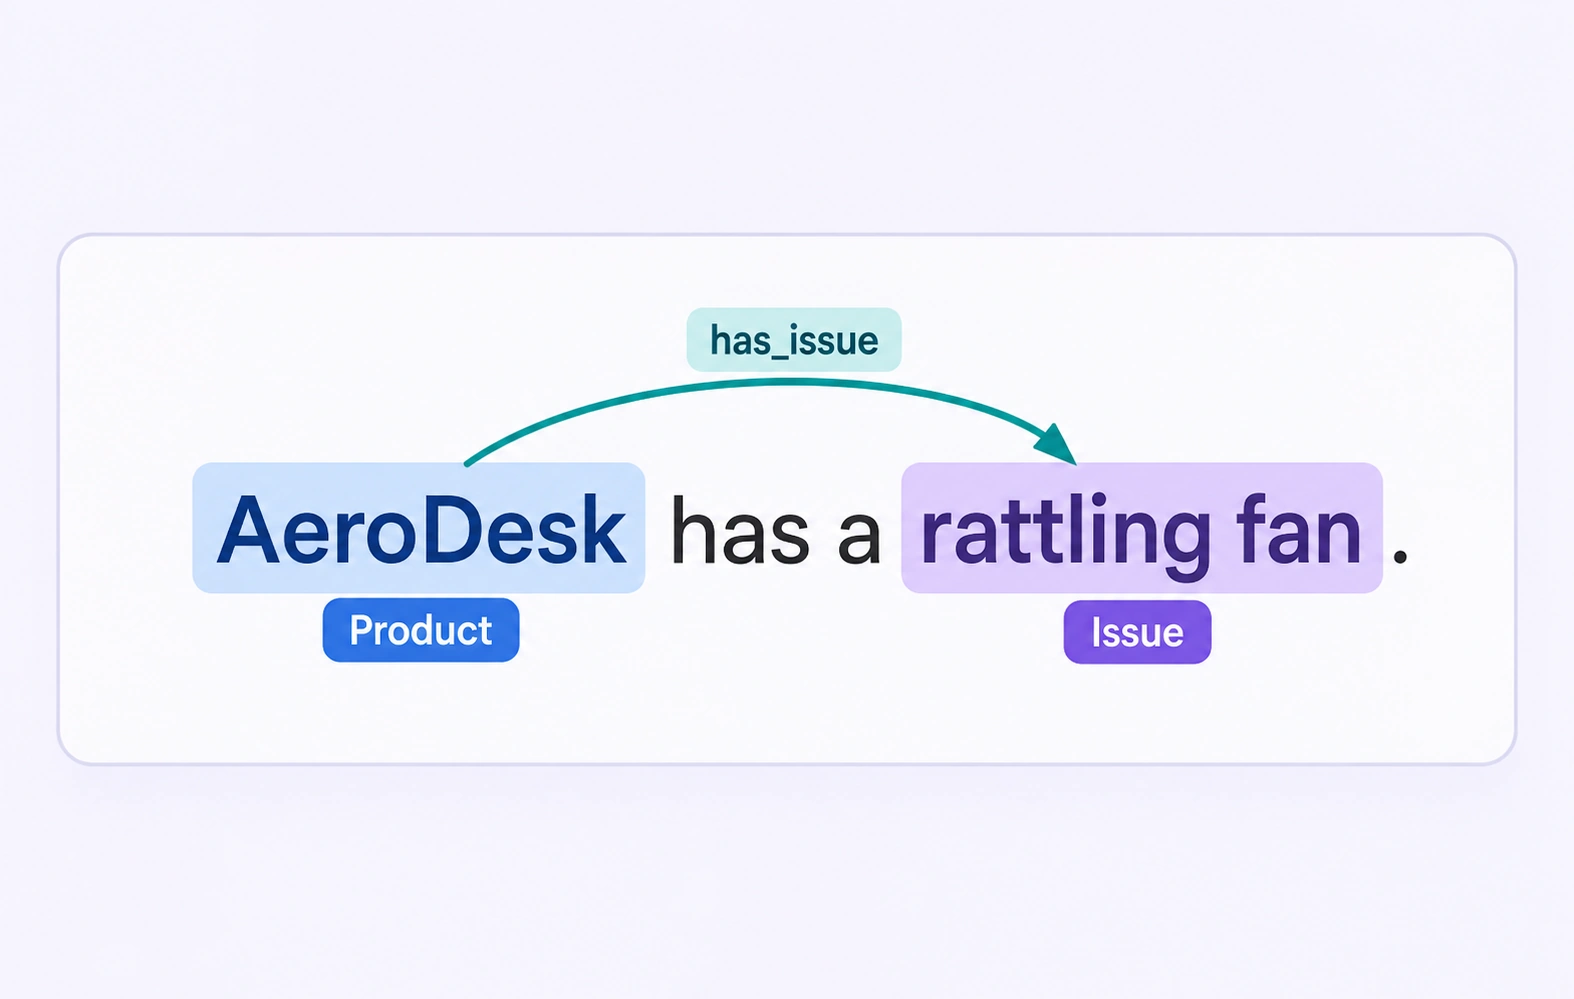
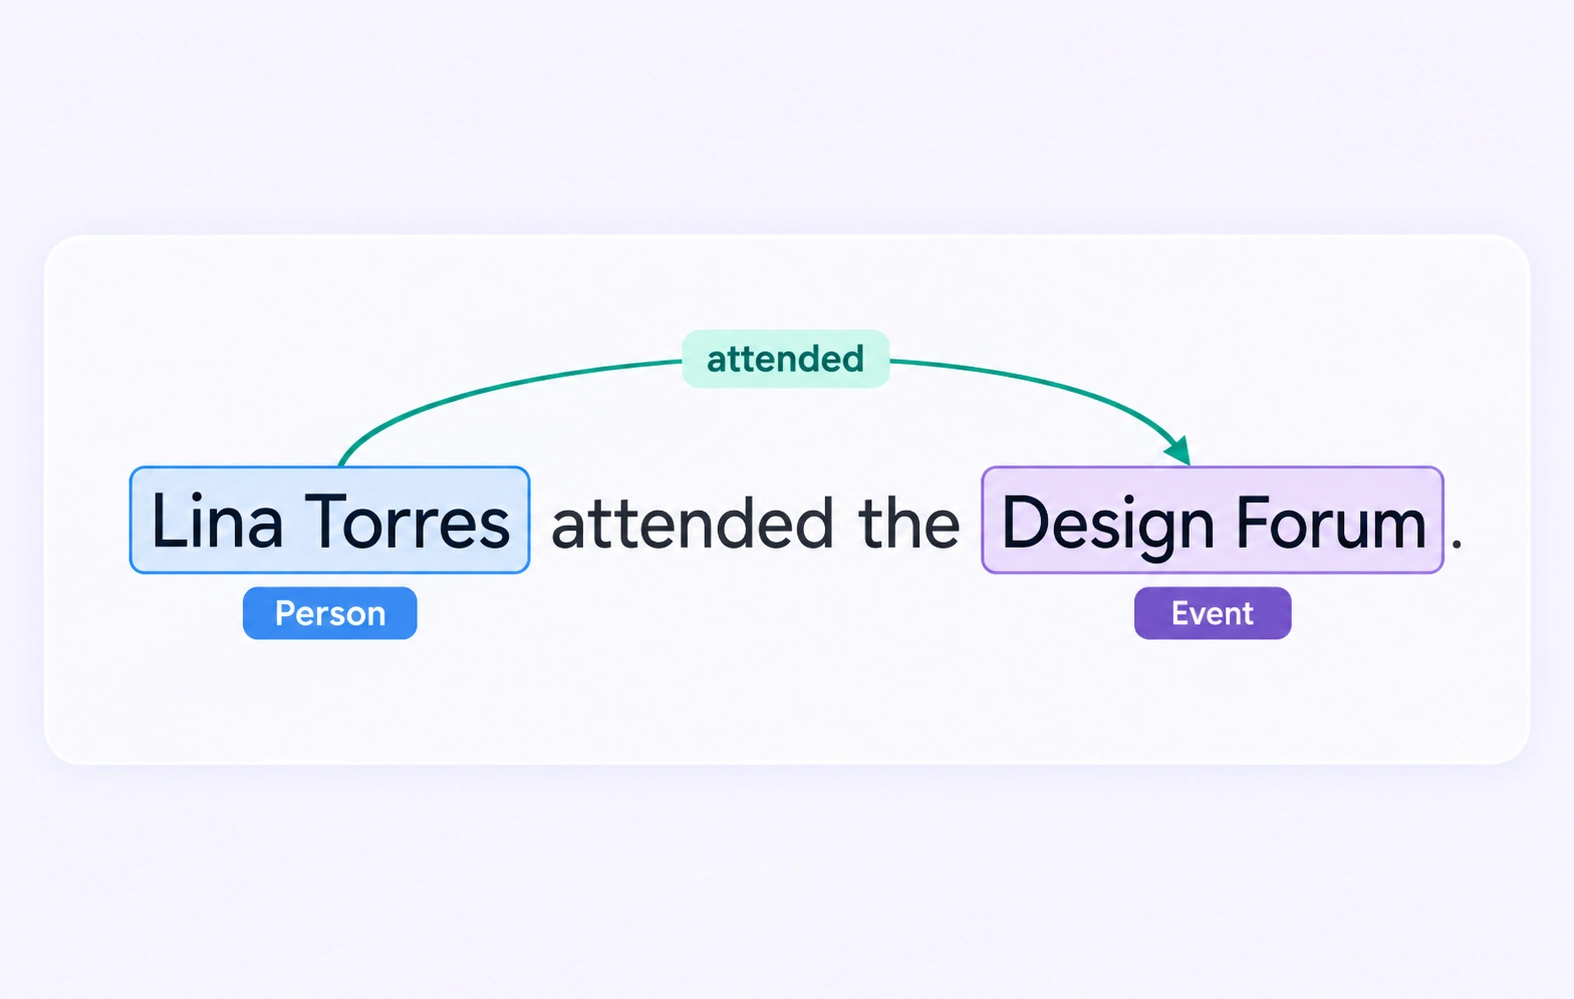
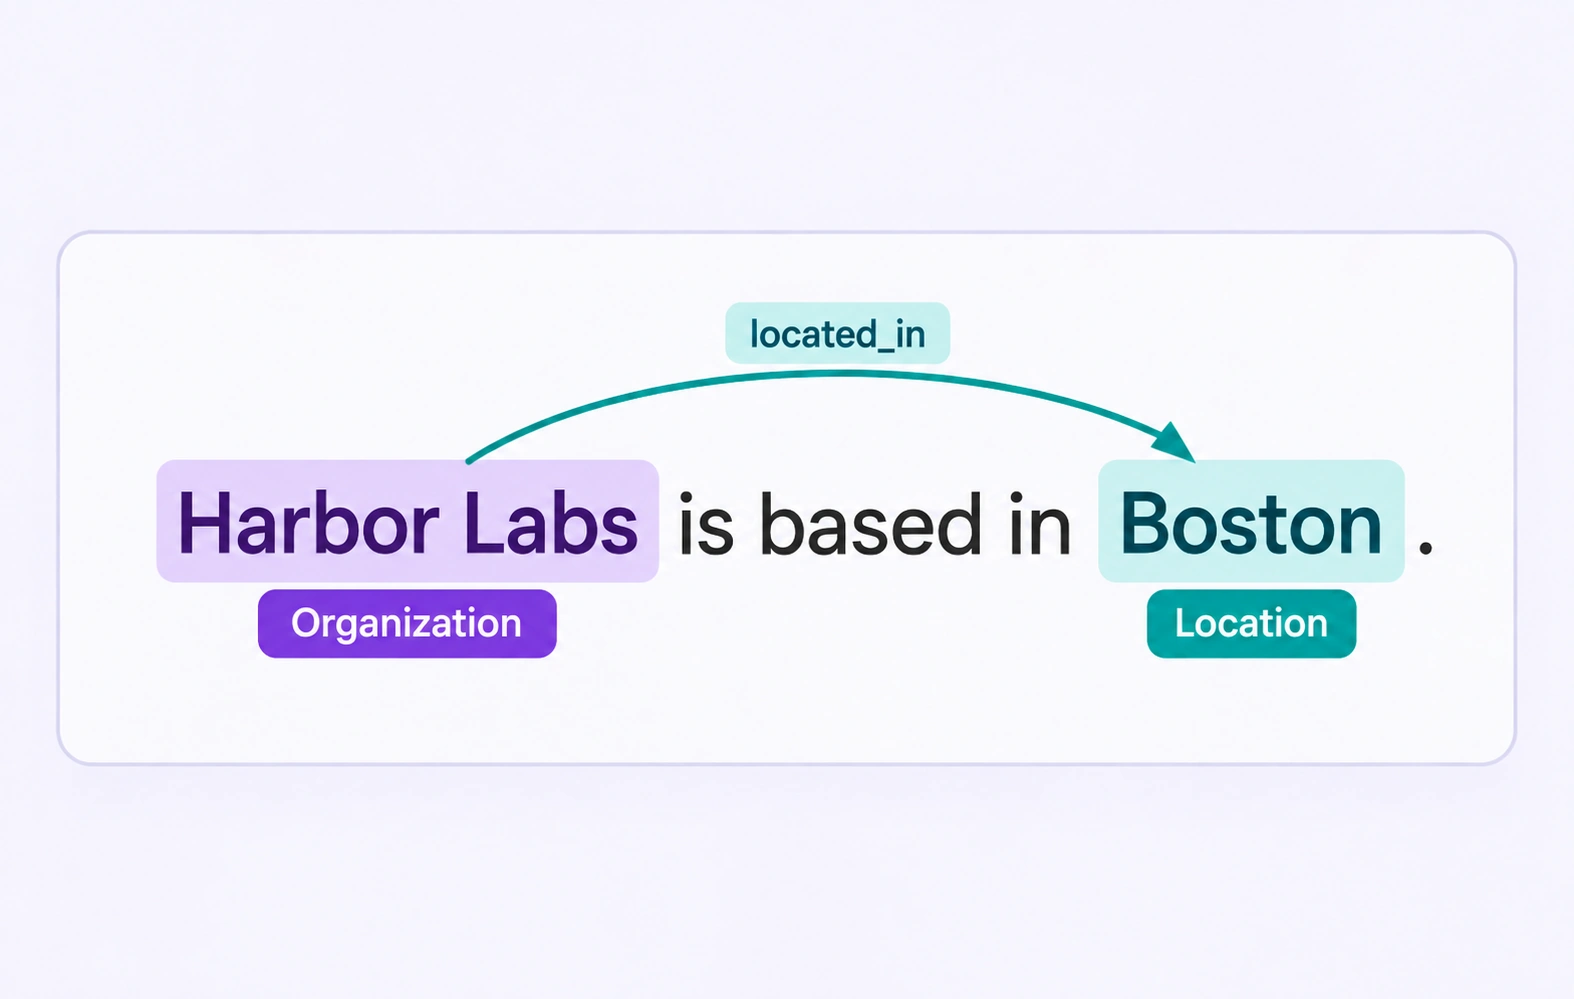
精确标注每个关系的源实体和目标实体对应的文本片段。
使用已定义关系连接已标注提及,并结合原文检查关系的两个端点。
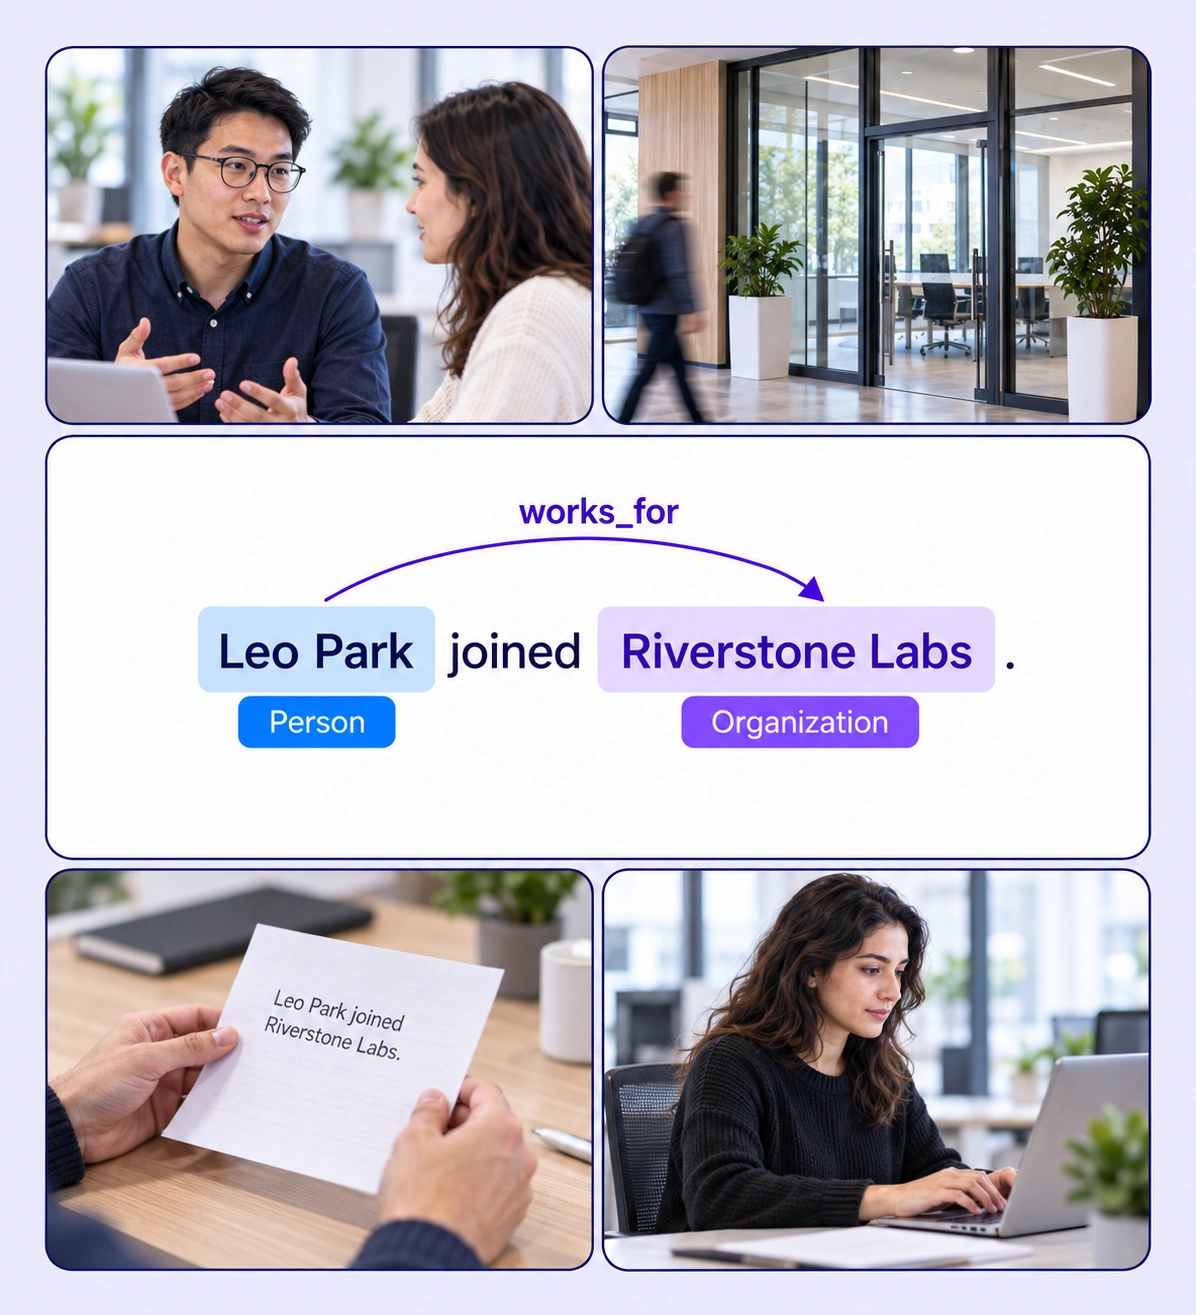
关系抽取标注通过具名关系连接文本中的实体。这些标签有助于训练模型从语言中提取结构化事实。
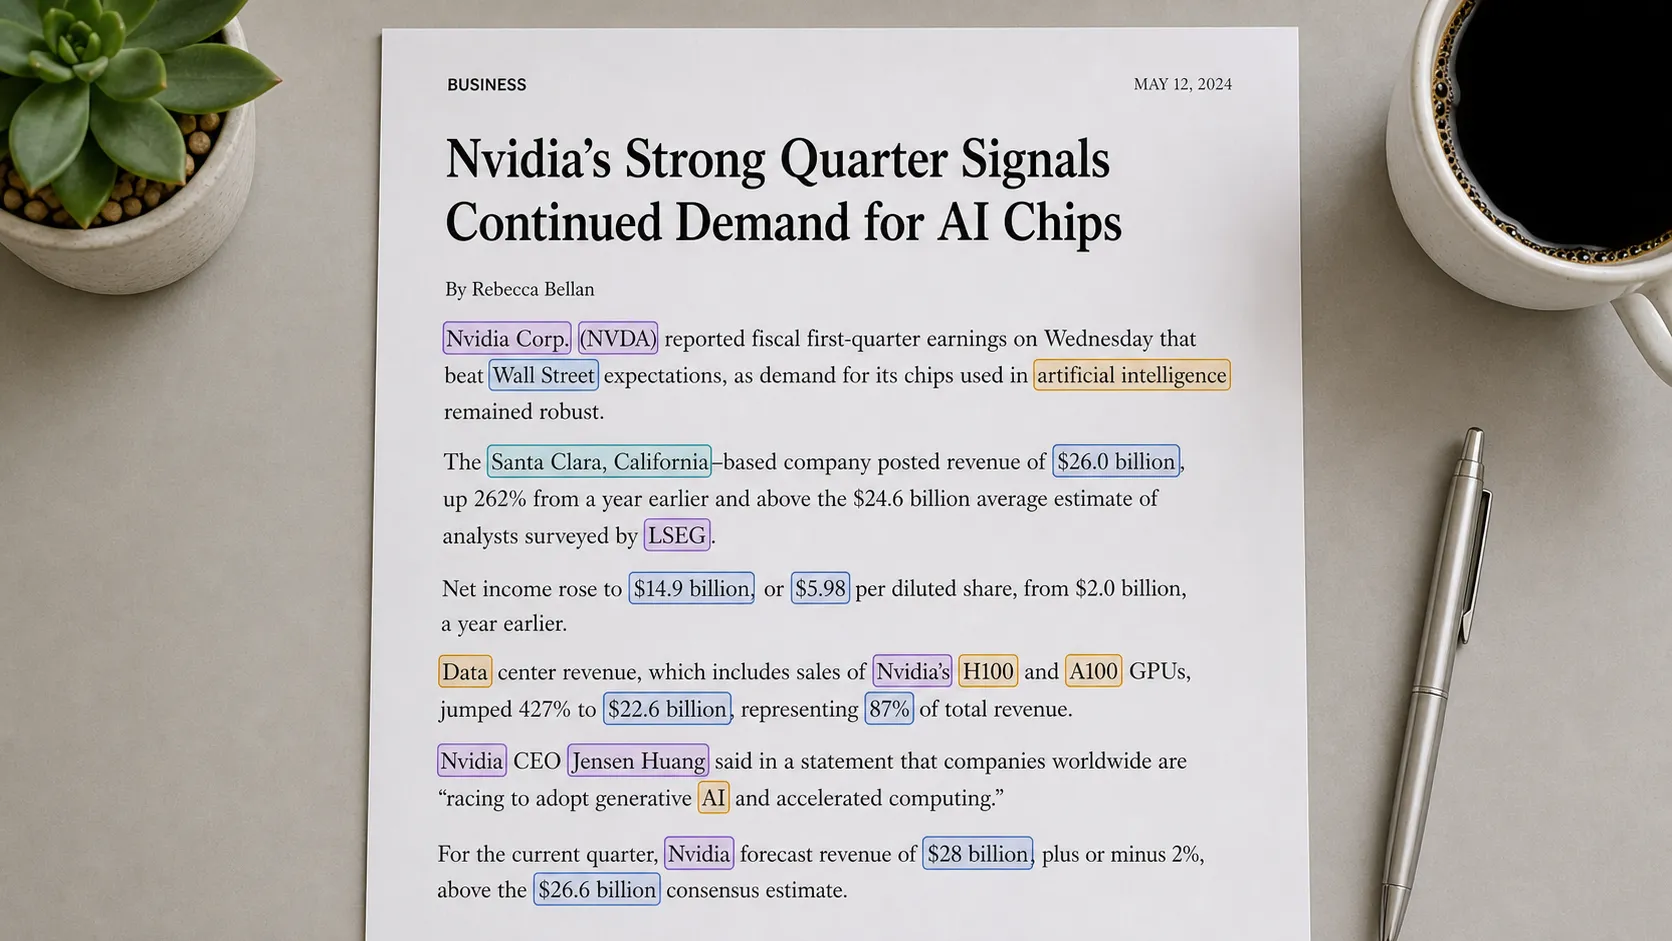
命名实体识别用于识别实体提及。关系标注在这些提及之间添加有意义的连接,例如某人在某个组织任职。
可以。围绕您的领域定义关系类型,并在标注指南中说明源实体和目标实体各自应承担的角色。
方向会改变含义。works_for(任职于)关系应从人物指向组织,因此审核人员既要检查关系标签,也要检查两个端点。
可以。实体属性可记录额外上下文,而关系记录实体之间的连接。使用本体确保这两类信息保持一致。
经过审核的实体片段与具名关系类型,为下游信息抽取或知识图谱流水线提供结构化示例。请明确源实体、目标实体和关系的含义。
原生语言标注使用纯文本文件。围绕团队需要标注的文本和任务,定义实体类别、关系及数据项属性。
将已标注文本送入审核,结合上下文处理评论和修正,并在发布数据集前使用已配置的共识机制或已批准的基准检查一致性。
可以。文本支持 JSONL 和 Unitlab 统一导出格式。选择能够保留训练流水线所需实体、关系和属性的导出格式。